一条命令之后,你的 DGX Spark 就有了自己的本地 AI 助理:NemoClaw + vLLM 全流程实操
本文详解 NVIDIA 官方推荐的 DGX Spark 本地 AI 助理部署方案:通过 NemoClaw 一键安装,将 OpenClaw Agent 运行于 OpenShell 内核级沙盒中,并路由至本地 vLLM 推理引擎。涵盖模型选型逻辑(Qwen3.6-35B-A3B-NVFP4)、四层隔离机制(Landlock/seccomp/netns/Inference)、vLLM 接线三大要点、三种访问方式及高频排障指南。
如果你手里有一台 DGX Spark,大概率已经做过这两件事之一:要么用 Ollama 拉个模型跑着玩,问两句就腻了;要么试着装个 OpenClaw 之类的 Agent,配到一半发现——这东西居然有我电脑的完整 shell 权限。
前者不好用,后者不安全。
NVIDIA 官方在 DGX Spark 的 playbook 里给了一个把这两件事一起解决的做法:用 NemoClaw 把 OpenClaw Agent 关进内核级沙盒,再把它的推理路由到本地 vLLM 上。全程一条安装命令起步,最后你能得到一个跑在沙盒里、可以通过网页/终端/微信访问、且所有推理都不出本机的 AI 助理。
这篇文章把这份官方手册拆成能照着做的中文版,顺带把几个官方写得比较含蓄、但实际最容易翻车的点拎出来讲清楚。
一、NemoClaw 到底是什么?先分清三个名字
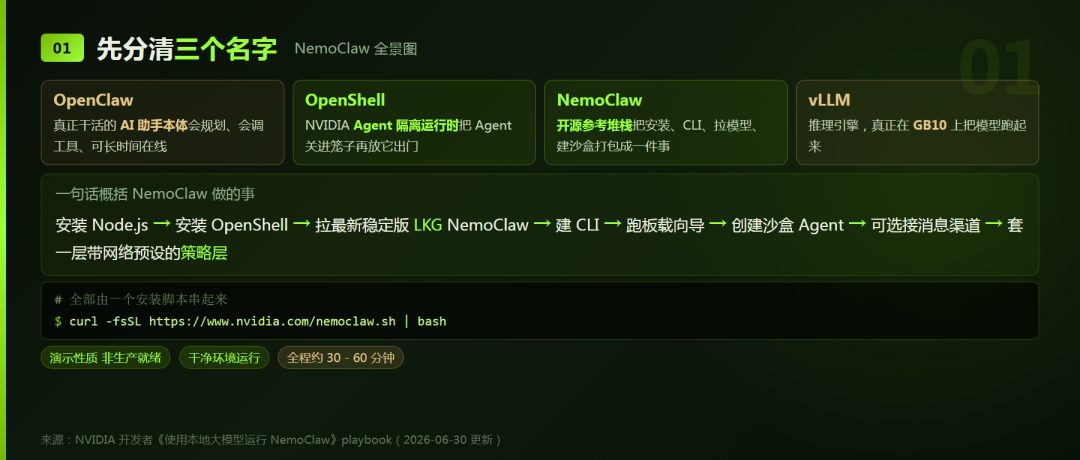
官方文档里 NemoClaw、OpenClaw、OpenShell 三个词反复出现,第一次看容易晕。其实是一条清晰的三层结构:
- OpenClaw:那个真正干活的 AI 助手本体。会规划、会调工具、能长时间在线运行。
- OpenShell:NVIDIA 的 Agent 隔离运行时。它不生产智能,只负责把 Agent 关进笼子里再放它出门。
- NemoClaw:把上面两件事 + Node.js + CLI + 模型拉起打包成一件事的开源参考堆栈。你要敲的命令基本都对着它。
- vLLM:推理引擎,负责真正在 DGX Spark 的 GB10 上把模型跑起来。
一句话概括 NemoClaw 做的事:
安装 Node.js → 安装 OpenShell → 拉最新稳定版 NemoClaw → 建 CLI → 跑板载向导 → 创建沙盒 Agent → 可选接消息渠道 → 套一层带网络预设的策略层。
全部由一个安装脚本串起来:
curl -fsSL https://www.nvidia.com/nemoclaw.sh | bash安装向导会问两件事,输入 yes 接受第三方许可,Confirm 然后 Y 走快速安装,剩下的全自动。
二、为什么是这个模型:Qwen3.6-35B-A3B-NVFP4
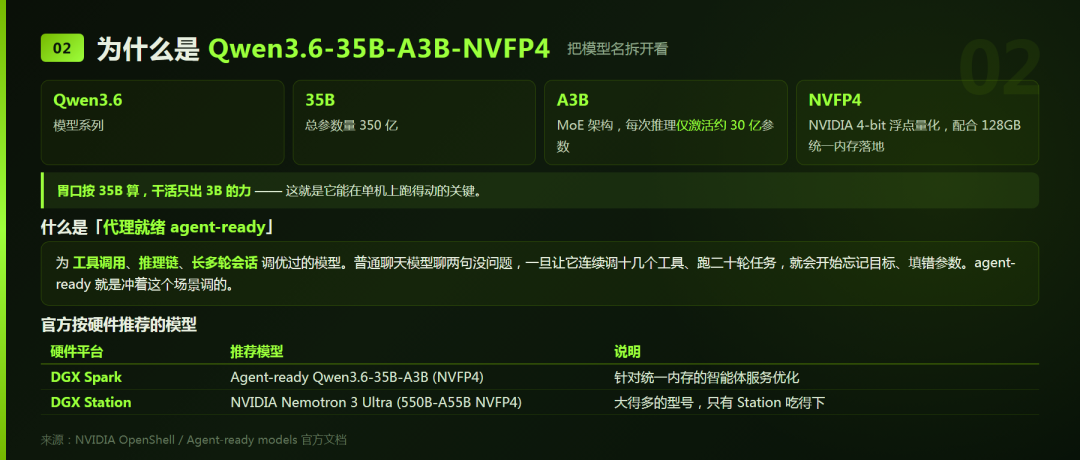
快速安装默认会给 DGX Spark 配nvidia/Qwen3.6-35B-A3B-NVFP4,这不是随手挑的,是官方"代理就绪"(agent-ready)模型清单里针对 DGX Spark 的推荐项。
拆开这个名字看,每个后缀都有含义:
- Qwen3.6:模型系列。
- 35B:总参数量 350 亿。
- A3B:MoE 架构,每次推理实际只激活约 30 亿参数。这是它能在单机上跑得动的关键——胃口按 35B 算,干活只出 3B 的力。
- NVFP4:NVIDIA 的 4-bit 浮点量化格式。配合 DGX Spark 128GB 统一内存,让 35B 级别的模型稳稳落地,还给长上下文留了余量。
所谓"代理就绪",官方的定义是:为工具调用、推理链、长多轮会话调优过的模型。普通聊天模型跟你对话没问题,一旦让它连续调十几个工具、跑二十轮任务,就会开始忘记自己要干什么、工具参数填错。agent-ready 模型就是冲着这个场景调的。
横向对比一下官方给不同硬件的推荐,更能看出定位差异:
| 硬件平台 | 推荐模型 | 说明 |
|---|---|---|
| DGX Spark | Agent-ready Qwen3.6-35B-A3B (NVFP4) | 针对统一内存的智能体服务优化 |
| DGX Station | NVIDIA Nemotron 3 Ultra (550B-A55B NVFP4) | 大得多的型号,DGX Station 才吃得下 |
三、动手前,先花 30 秒验证环境
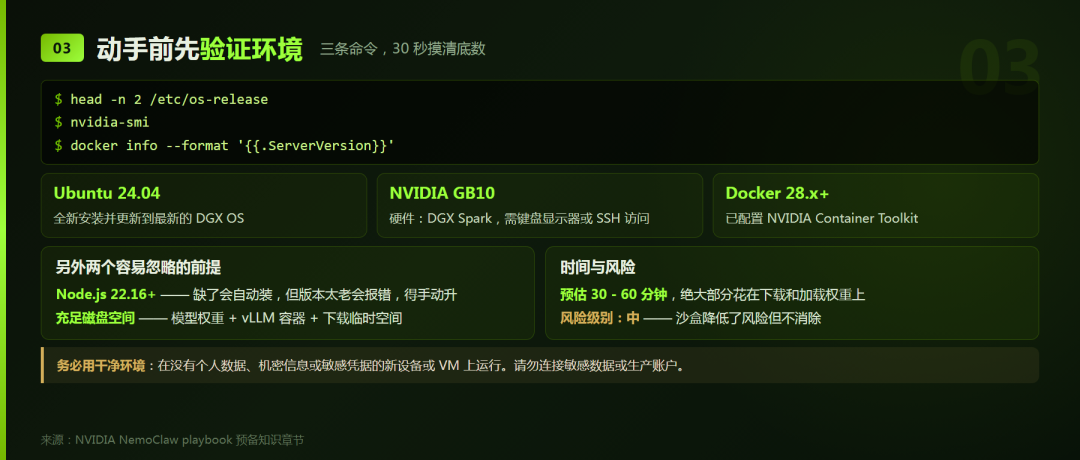
官方要求在开始之前先跑这三条,把软硬件底数摸清楚:
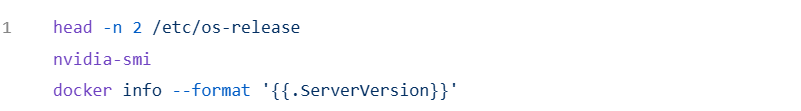
预期看到的三个结果:Ubuntu 24.04、NVIDIA GB10 GPU、Docker 28.x 以上。
硬件上你需要的就一台带键盘显示器或能 SSH 的 DGX Spark (GB10),系统全新安装并更新到最新。
另外两个容易被忽略的前提:
- Node.js 22.16+——装的时候缺了会自动装,但如果你机器的 Node 版本卡在老版本,安装会报错,得手动升上去。
- 磁盘空间——模型权重 + vLLM 容器 + 下载临时空间。这是"第一次跑要等 30-60 分钟"的主要原因,绝大部分时间花在下载和加载权重上,取决于你的网络。
关于时间:官方给的预估是首次完整走通 30-60 分钟。如果你还要在第二个会话里配微信渠道,还得再加一些。
四、一条命令之后,会走到哪一步
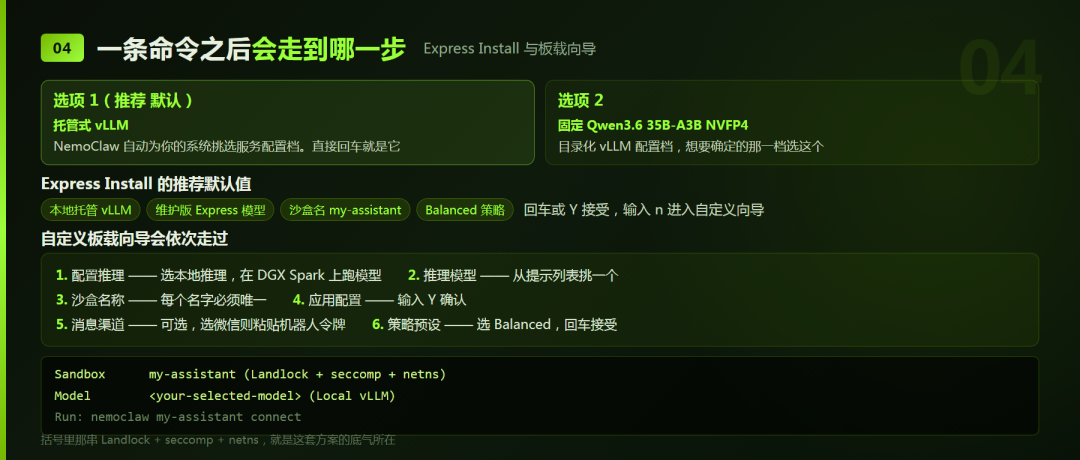
安装脚本在 DGX Spark 上会检测硬件,然后给你一个交互式选择——除非你提前设了模型覆盖变量。这里有两个选项:
- 选项 1(默认):托管式 vLLM,由 NemoClaw 自动为你的系统挑选服务配置档。直接回车就是它。
- 选项 2:固定使用 Qwen3.6 35B-A3B NVFP4 的目录化 vLLM 配置档。想要确定的那一档,选这个。
接着 Express Install 会把推荐设置摆在你面前:本地托管 vLLM + 维护版 Express 模型 + 沙盒名my-assistant+ Balanced 策略。回车或输入 Y 就接受,输入 n 则进入自定义板载向导。
自定义向导会依次走过这些:
- 配置推理 —— 选本地推理,在 DGX Spark 上跑模型
- 推理模型 —— 从提示列表里挑一个,需要时自动准备本地模型构件
- 沙盒名称 —— 每个沙盒名字必须唯一(默认 my-assistant)
- 应用配置 —— 输入 Y 确认
- 消息渠道 —— 可选,选微信就粘贴你的机器人令牌
- 策略预设 —— 选 Balanced,回车接受建议预设
跑完你会看到这样一段输出:
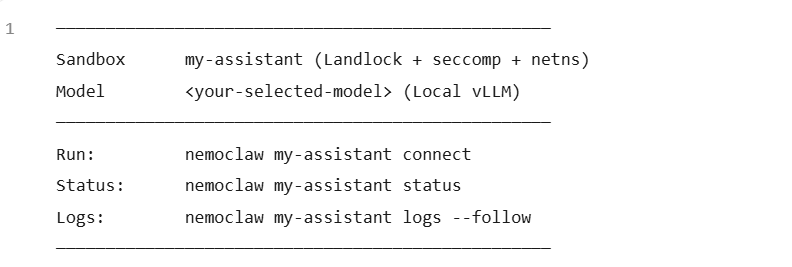
括号里那串 Landlock + seccomp + netns 就是这套方案的底气所在,下一节细说。
小贴士:装完如果提示
nemoclaw: command not found,别急着重装,先跑一下source ~/.bashrc刷新 shell 路径,多半就好了。
另外,板载向导是可以反复跑的——想给不同用途建多个互相隔离的沙盒,加 --name 就行,不会影响已有沙盒:
nemoclaw onboard --gpu --name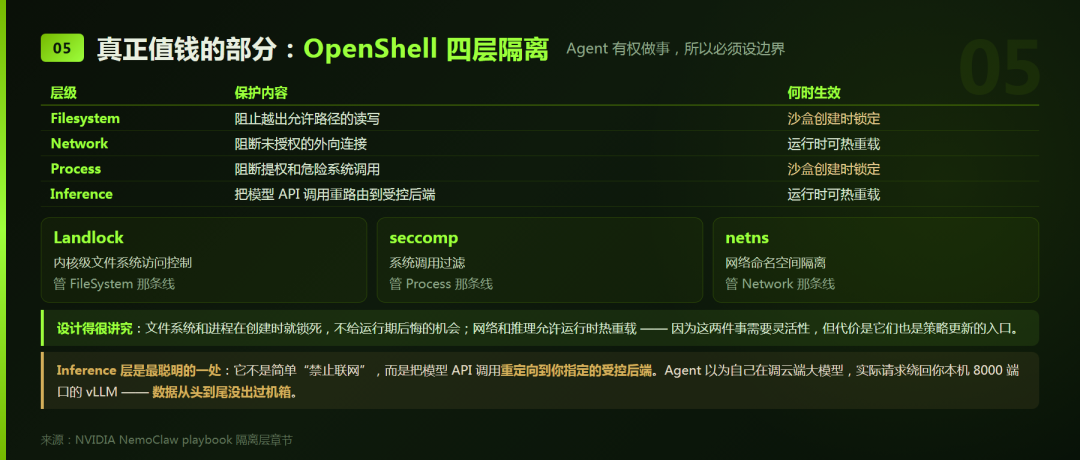
五、真正值钱的部分:OpenShell 的四层隔离
如果这篇文章你只记住一件事,记这段。
Agent 和聊天机器人的本质区别是:Agent 有权做事。它能读文件、能跑命令、能联网、能调 API。在个人电脑上裸跑一个有 shell 权限的 LLM Agent,等于把家门钥匙交给一个会被提示词注入骗的人。
OpenShell 用四层隔离把风险框住:
| 层级 | 保护内容 | 何时生效 |
|---|---|---|
| Filesystem | 阻止越出允许路径的读写 | 沙盒创建时锁定 |
| Network | 阻断未授权的外向连接 | 运行时可热重载 |
| Process | 阻断提权和危险系统调用 | 沙盒创建时锁定 |
| Inference | 把模型 API 调用重路由到受控后端 | 运行时可热重载 |
落到实现上,就是输出里那三个:
- Landlock —— 内核级文件系统访问控制,文件层那条线
- seccomp —— 系统调用过滤,进程层那条线
- netns —— 网络命名空间隔离,网络层那条线
注意"何时生效"这一列的差异,设计得很讲究:文件系统和进程在创建时就锁死,不给运行期后悔的机会;网络和推理允许运行时热重载——因为这两件事需要灵活性(比如临时放行一个新渠道),但代价是它们也是策略更新的入口。
Inference 层是我觉得最聪明的一处:它不是简单地"禁止联网",而是把模型的 API 调用重定向到你指定的受控后端。也就是说 Agent 以为自己在调某个云端大模型,实际请求转了一圈绕回你本机 8000 端口的 vLLM。数据从头到尾没出过机箱。
六、vLLM 接线:三个必须注意的点
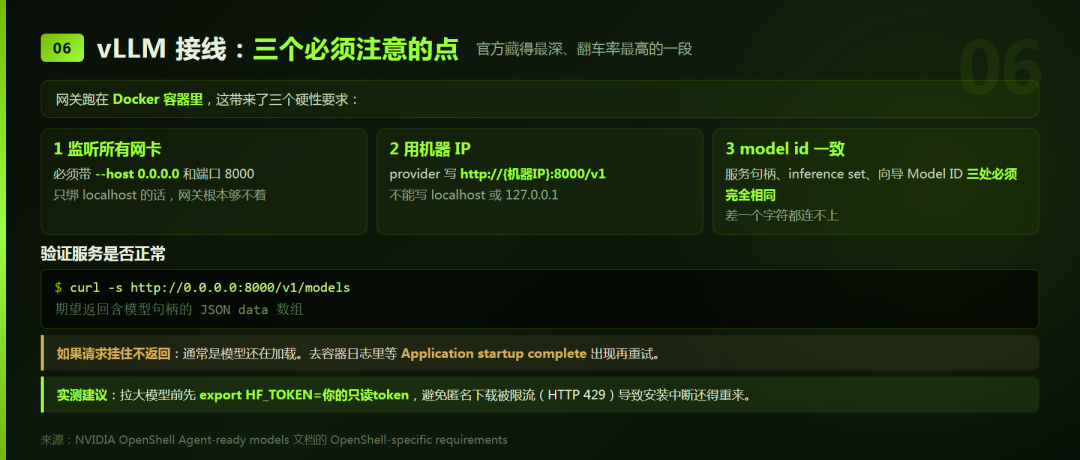
这一段是官方文档藏得最深、但实操翻车率最高的地方。OpenShell 网关跑在 Docker 容器里,这带来了三个硬性要求:
1. 服务必须监听所有网卡
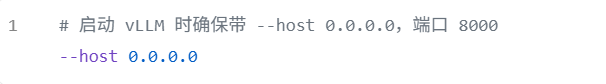
原因很直接:网关在很多容器内部,如果 vLLM 只绑定 localhost,网关根本够不着它。
2. 创建 provider 时要用机器 IP,不是 localhost
http://{机器IP}:8000/v1不能写 localhost 也不能写 127.0.0.1——那个 IP 是容器的 IP,不是你主机的。
3. model id 必须三处一致
vLLM 服务的模型句柄、OpenShell 的 inference set 配置、OpenClaw 向导里填的 Model ID,这三个字符串必须完全对得上。差一个字符都会连不上。
验证服务是否正常:
curl -s http://0.0.0.0:8000/v1/models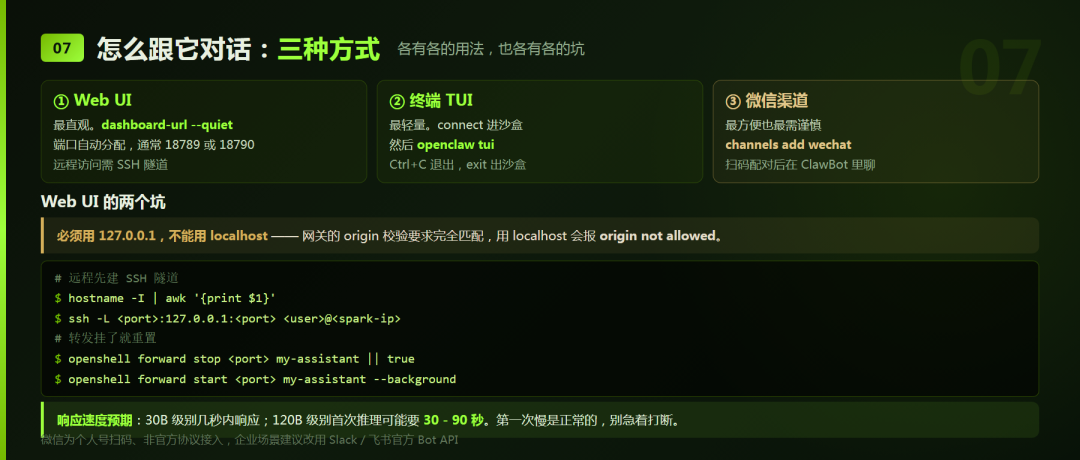
期望返回一个包含模型句柄的 JSON data 数组。如果这个请求挂住了不返回,通常是模型还在加载——去容器日志里等 Application startup complete 出现再重试。
实测建议:如果你要拉较大的模型,建议提前导出 Hugging Face 只读 token,避免匿名下载被限流(HTTP 429)导致安装中断还得重来:
export HF_TOKEN=你的token
七、怎么跟它对话:三种方式,各有各的坑
方式一:Web UI(最直观)
拿到带令牌的完整面板地址:
nemoclaw my-assistant dashboard-url --quiet会输出类似 http://127.0.0.1:18790/#token=...。端口是自动分配的,通常是 18789 或 18790,不同安装可能不同。
如果在 Spark 本机(接了显示器),浏览器直接打开即可。远程访问则要建 SSH 隧道:
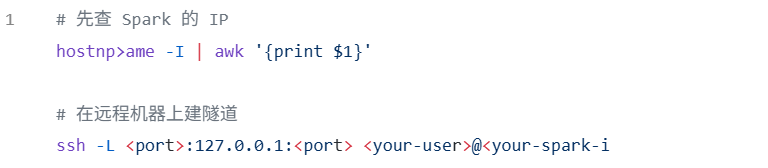
⚠️这里有个反直觉的坑:浏览器里必须用 127.0.0.1,不能用localhost。网关的 origin 校验要求完全匹配,用 localhost 会报 origin not allowed。
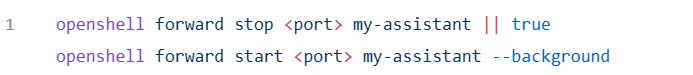
如果面板加载不出来、怀疑端口转发挂了,重置一下:
方式二:终端 TUI(最轻量)
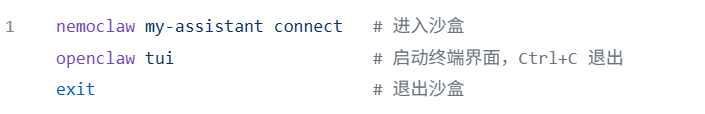
方式三:微信(最方便,也最需要谨慎)
沙盒已经存在但没配过渠道的话,补一条命令:
nemoclaw my-assistant channels add wechat选 Y,用微信扫提示里的二维码完成配对。之后在微信 ClawBot 对话框里发消息,机器人会把请求转发给沙盒里的 Agent 并回复。
关于响应速度的心里预期:取决于模型大小。30B 级别几秒内响应;120B 级别首次推理可能要 30-90 秒。第一次回复慢是正常的,别急着 Ctrl+C。
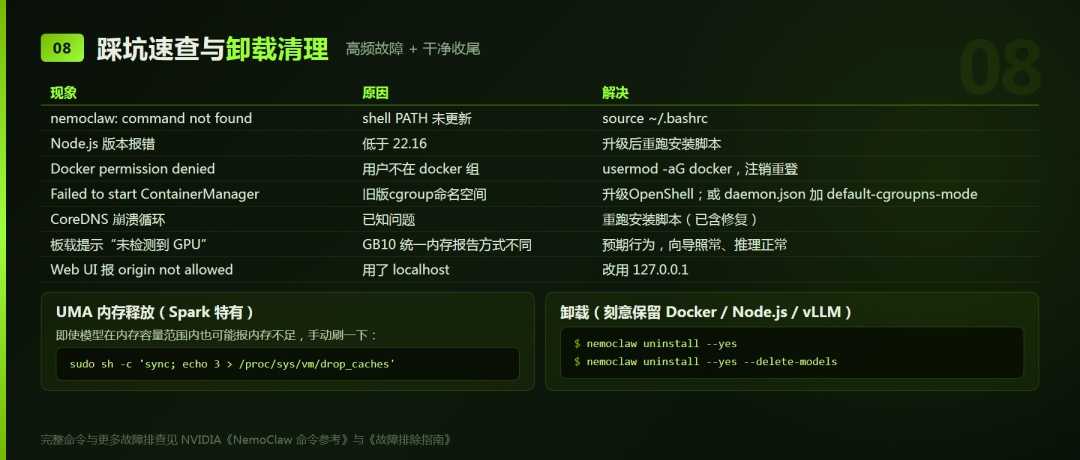
八、几个高频踩坑点
从官方故障排查表里挑了最常遇到的几条:
| 现象 | 原因 | 解决 |
|---|---|---|
nemoclaw: command not found | shell PATH 未更新 | source ~/.bashrc,或开个新终端 |
| Node.js 版本报错 | 低于 22.16 | 装 Node 22.16+,重跑安装脚本 |
| npm EACCES 权限错误 | 全局目录不可写 | mkdir -p ~/.npm-global && npm config set prefix ~/.npm-global,把 PATH 写进 .bashrc |
| Docker permission denied | 用户不在 docker 组 | sudo usermod -aG docker $USER,注销重登 |
| 网关报 Failed to start ContainerManager | OpenShell/Docker 版本旧,私有 cgroup 命名空间 | 先升级 OpenShell;仍不行就用脚本给 daemon.json 加 default-cgroupns-mode: host 再重启 docker |
| 端口 8080 被占 | 另一个网关容器在用 | 跑 nemoclaw onboard 或 --resume,它会探测并复用健康的网关 |
| CoreDNS 崩溃循环 | 某些 Spark 配置的已知问题 | 重跑安装脚本(已内含 CoreDNS 修复) |
| 板载提示"未检测到 GPU" | GB10 的统一内存报告方式不同 | 这是预期行为,向导继续正常走,推理照常用 vLLM |
| Web UI 报 origin not allowed | 用了 localhost | 改用 http://127.0.0.1:18789/#token=... |
| 端口 18789 被占 | 别的进程占用 | lsof -i :18789 找到 PID 后 kill |
还有一个 DGX Spark 特有的:UMA 统一内存架构下,即使模型总量在内存容量范围内,也可能因为缓冲区缓存没释放而报内存不足。这时候手动刷一下:
sudo sh -c 'sync; echo 3 > /proc/sys/vm/drop_caches'九、用完怎么收拾干净
NemoClaw 自带卸载程序,这一点做得相当克制:

卸载程序跑六步:停辅助服务和端口转发 → 删所有沙盒/网关/提供方 → 删全局 npm 包 → 删 Docker 容器/镜像/卷 →(可选)删模型权重 → 删状态目录(/.nemoclaw、/.config/openshell、~/.config/nemoclaw)和 OpenShell 二进制。
注意它刻意保留的东西:Docker、Node.js、npm 和 vLLM 镜像都不动——这些都是系统级组件,删了容易误伤别人的环境。要连模型权重一起清才加 --delete-models。
万一 CLI 本身坏了(安装中途失败之类),还有个兜底的远程卸载:

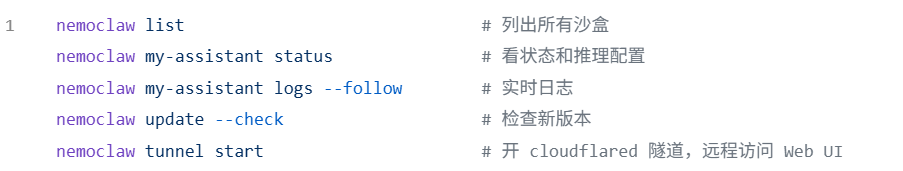
日常用得上的几条命令,建议收藏:
NemoClaw 解决的其实是一个很具体的矛盾——我们想要 Agent 有能力,又不想要它有无限能力。OpenShell 的四层隔离给了一个工程上的答案:FileSystem 和 Process 锁死(不出格),Network 和 Inference 可热重载(够灵活)。尤其 Inference 层那个重定向,让"本地推理"从口号变成了一个可强制执行的策略。
要说清楚的有三点:
第一,这是演示,不是生产方案。NVIDIA 在手册里写得很明白——"按原样提供,仅用于演示目的,不作任何保证,非生产就绪"。真要上生产,安全控制得你自己补。
第二,Agent 的固有风险不会因为沙盒消失。数据泄露、恶意代码执行、意外操作、提示注入——官方列的这四条,隔离只降低不消除。务必用干净环境跑,别接敏感数据和生产账号。
第三,关于微信渠道要格外谨慎。手册里写明微信是"扫码登录个人号、非官方协议"的接入方式。这意味着它既存在账号层面的风险,也需要你自己确认合规性。如果是正经的企业场景,建议走 Slack、飞书这类提供官方 Bot API 的渠道,NemoClaw 同样支持。另外请务必确认你的使用场景、渠道选择、模型与组件选型都符合适用法律法规的要求以及相应组件的许可协议。
回到开头那两难。这台巴掌大的机器真正有意思的地方,从来不是它能跑多大的模型,而是——它让你第一次可以在自己的桌子上,认真想一想"AI 助理到底该怎么被管住"这件事。
而 NemoClaw 给出的答案是:给它能力,同时给它边界。
JOTO 企业落地观察
- 企业部署本地 AI 助理时,需明确区分“演示就绪”与“生产就绪”。NemoClaw 提供的 OpenShell 四层隔离是安全基线,但企业若要上线,必须自行补足审计日志、权限分级、操作审批等治理环节,不能依赖沙盒替代管理流程。
- 这类系统的取舍在于:Inference 层重定向虽保障数据不出域,但也意味着企业需承担 vLLM 服务的稳定性、可观测性与弹性扩缩责任。当模型升级或并发突增时,本地推理服务将成为关键瓶颈点。
- 对于 RAG 知识工程团队,该方案中“沙盒名唯一”与“模型 ID 三处一致”的强约束,提示知识接入必须与沙盒生命周期对齐。即新增知识源需触发对应沙盒的重新配置,无法做到跨沙盒共享同一知识库实例。
- 在 FDE 驻场共创场景中,客户现场若采用微信渠道接入,需前置评估其与企业 IT 安全策略的兼容性。因微信非官方 Bot 协议,FDE 需协助客户完成渠道替换(如飞书/钉钉)或补充额外的账号隔离与会话审计措施。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们