云栖实录丨面向 AgenticOps 的开源建设:采集标准化、统一语义建模与能力评测
阿里云可观测团队围绕 AgenticOps 生产落地的三道核心墙——运行事实采集、故障上下文理解、能力可复现验证,系统性推进开源建设:基于 OpenTelemetry 构建 OBI/eBPF 无侵入采集、国产框架语义规范共建、GenAI 语义双轨协作;推出 UModel 统一语义运行时,实现对象-关系-状态聚合;发布 BRiSE Benchmark 流水线,固化任务、环境与评分标准,支撑 Agent 能力持续迭代。
开源建设:把运行事实可靠地带回来
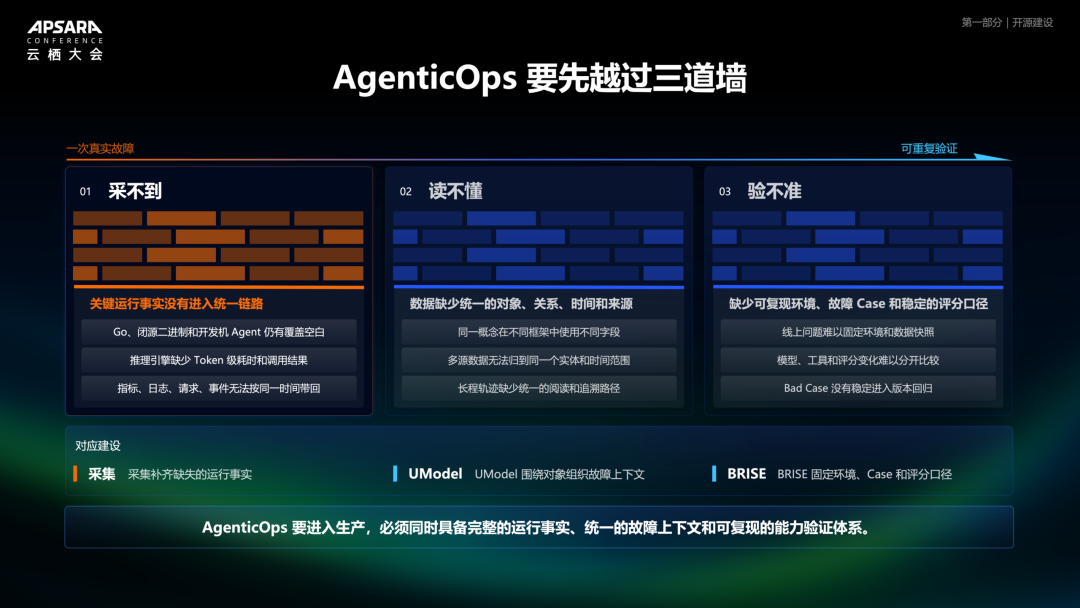
随着大模型的飞速发展,Agent 进入越来越多的领域。但当 AgenticOps 要真正走进生产环境,靠的不是一个更强的模型,而是一整套可持续建设的工程底座。要进入生产,必须同时具备完整的运行事实、统一的故障上下文和可复现的能力验证体系。这对应三个层层递进的挑战,也对应三项开源建设。一次真实故障,要能被稳定采集、被正确理解、被重复验证——跨越这三道墙,缺一不可。而今天,我们以这三道墙为主线,为大家分享阿里云可观测团队在 AgenticOps 的开源建设过程中的实践与思考。
OBI:让“不能改代码”的应用变成标准化 OpenTelemetry 信号
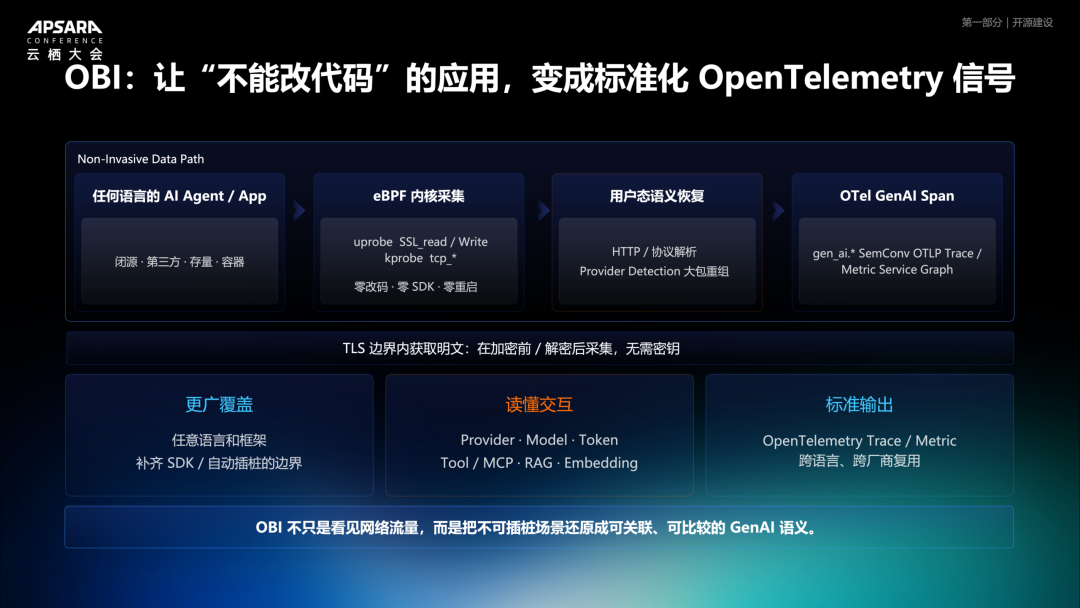
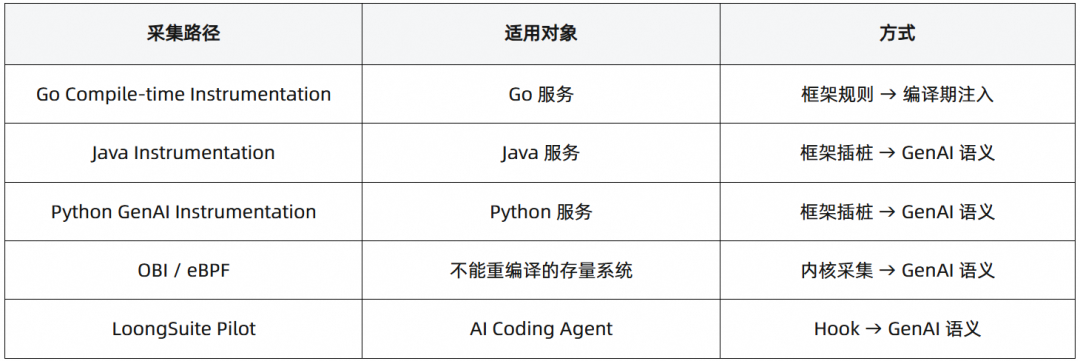
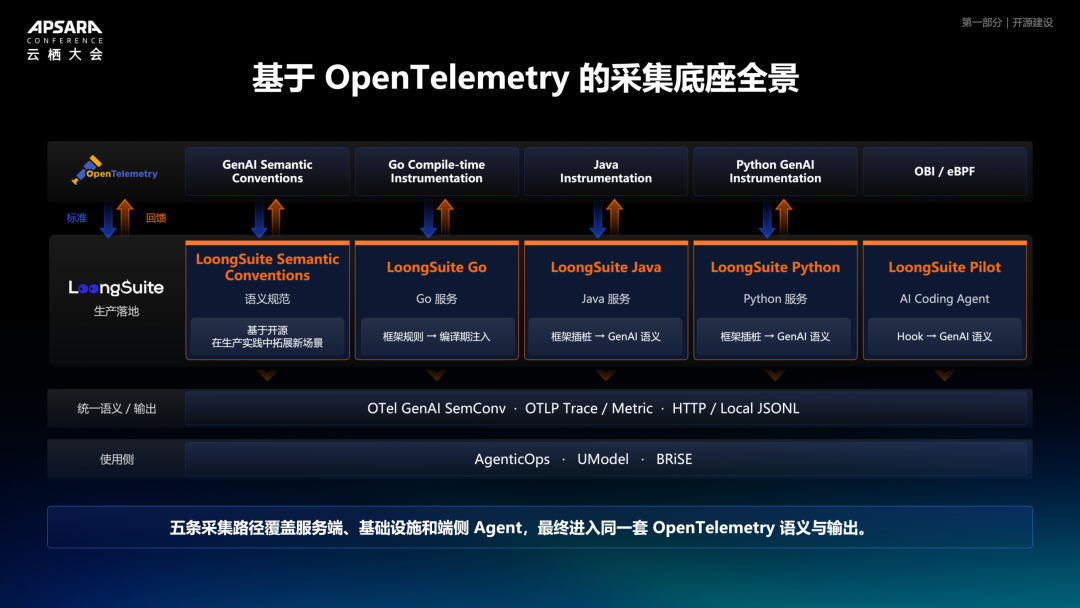
第一个是 OBI(OpenTelemetry eBPF Instrumentation)。它基于 eBPF 技术,主要面向那些无法修改代码的系统——我们无法触及、无法对它做埋点和采集。这时可以通过 eBPF 这种无侵入技术,在任意语言、任意环境下(包括 x86、ARM,任意 K8s、ECS,Sidecar/DaemonSet 部署)自动捕捉信号,做到零改码、零 SDK、零重启。
我们通过 eBPF 的 kprobe/uprobe 拦截应用发送网络请求时的关键信息,在 TLS 边界内获取明文(在加密前、解密后采集,无需密钥),再经用户态语义恢复(HTTP/协议解析、Provider 检测、大包重组),最终输出标准的 OTel GenAI Span。在 Agent 场景下,OBI 能自动识别调用大模型的协议——OpenAI、Anthropic、Gemini、千问等——并把输入输出、工具调用、MCP 调用、RAG、Embedding 等信息完整采集出来,产生的都是符合 OpenTelemetry 规范的标准数据。
这里有一个特别好的应用场景就是 Agent Sandbox。Sandbox 相当于一个虚拟隔离化的容器,在里面很难做侵入式埋点,所以我们在云监控上线的基于 Sandbox 的可观测能力,正是基于 OBI 实现的。OBI 不只是看见网络流量,而是把不可插桩的场景,还原成可关联、可比较的 GenAI 语义。
国产框架贡献进入 OpenTelemetry 之路
除了 eBPF,我们在 Java 和其他语言上也向社区贡献了大量框架支持。以 RPC 框架 Apache Dubbo 为例,这个项目我们花了很多时间跟社区一起共建,走出了一条清晰的贡献路径:首先在生产中发现采集问题,把 bug 反馈给社区,不断修复、逐步补齐能力、替换废弃 API;接着跟社区一起商讨 RPC 框架到底应该怎么采集,共同制定语义规范——为 Dubbo 这类 RPC 框架单独定义语义规范,并新增 Dubbo RPC 指标,从 Trace 扩展到 Metric,建立独立的 SemConv 页面;然后按规范重构插桩、固定字段语义、实现与规范对齐;打磨稳定后进入 stable 支持。整个过程前前后后花了一年多到两年。
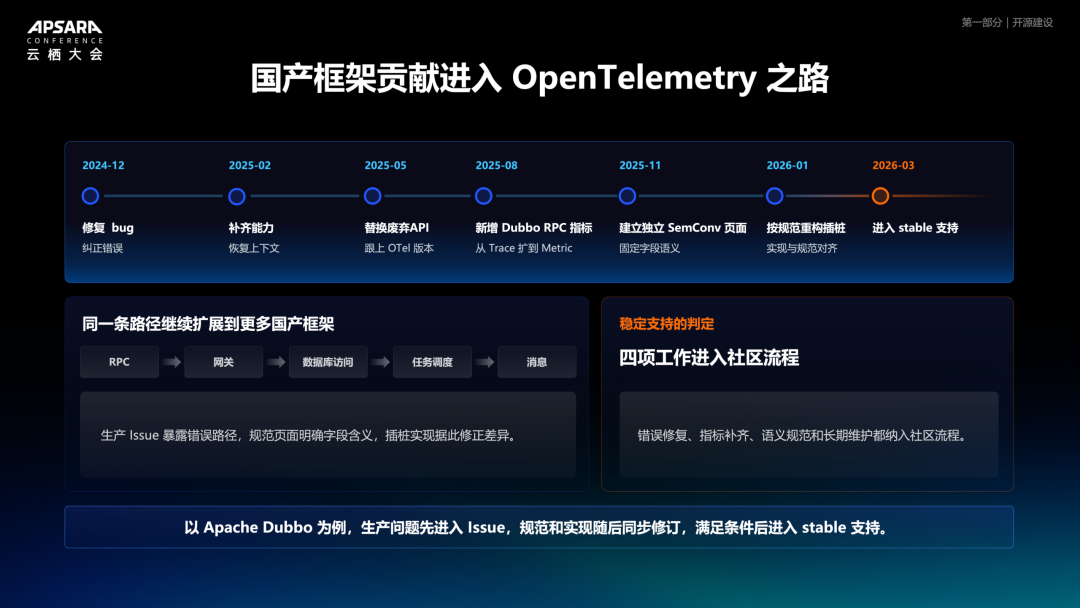
有了这样一个范式,就可以把它拓展到更多场景——RPC、网关、数据库访问、任务调度、消息等等,我们把很多插件和框架的支持都贡献给了社区,形成了一套比较完善的规范,跟社区一起共建。
Semantic Convention 语义规范:双轨协作
语义规范是 OpenTelemetry 社区里非常核心的一个项目。它规定的是在可观测领域到底应该采集什么数据、叫什么名字、要什么单位、怎么采集。OpenTelemetry 社区有几十家厂商,包括国内外各种云厂商和可观测领域的头部企业,共同投入大量研发协商出这套规范。一旦满足规范,任意实现都能被观测领域的各家厂商很好地适配。
一开始我们跟社区一起共建 GenAI(Agent 领域)的语义规范,但社区希望我们先有真实场景的验证。于是我们走了一条双轨协作的路径:
OTel 上游社区轨道:OpenTelemetry 启动 GenAI SemConv 讨论 → 社区 maintainer 建议先完成真实场景验证 → 逐项回馈字段、工具与 Agent 插桩。
LoongSuite 验证轨道:整理内部模型调用与工具执行语义 → 阿里云、阿里控股与蚂蚁开展大规模验证 → 开源 LoongSuite GenAI SemConv。
两条轨道的分工很明确:LoongSuite 先在真实场景中快速验证字段和实现,成熟后再提交 OpenTelemetry,供不同厂商长期使用。一条承担快速试验,一条承担跨厂商长期维护。
在语义规范之上,我们拓展了几个关键场景:
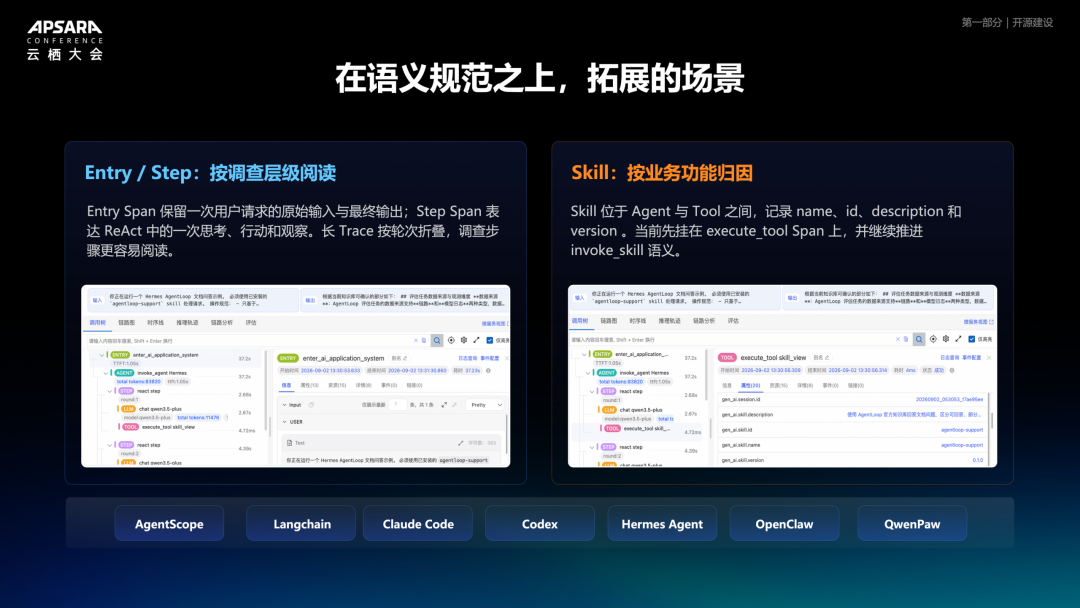
Entry / Step:按调查层级阅读。Entry Span 保留一次用户请求的原始输入与最终输出——之所以要单独记录,是因为有些框架会篡改用户的原始输入,导致我们采集到的东西并非本意。Step Span 表达 ReAct 中的一次思考、行动和观察,一次复杂任务可能执行几十轮甚至上百轮,长 Trace 按轮次折叠后,调查步骤更容易阅读。
Skill:按业务功能归因。Skill 是生产中特别重要的资产,位于 Agent 与 Tool 之间,记录 name、id、description 和 version。有了这些规范,就能基于 Skill 做后续的分析和评估——前面嘉宾分享到的 Skill 调优实践,正是来源于这样的规范采集。
这些实现能在不同框架中完成,包括 AgentScope、LangChain 这样的框架,以及 Claude Code、Codex、Hermes Agent、OpenClaw、QwenPaw 等 Coding Agent,都能完整覆盖。
为推理引擎建立请求级 OpenTelemetry 追踪
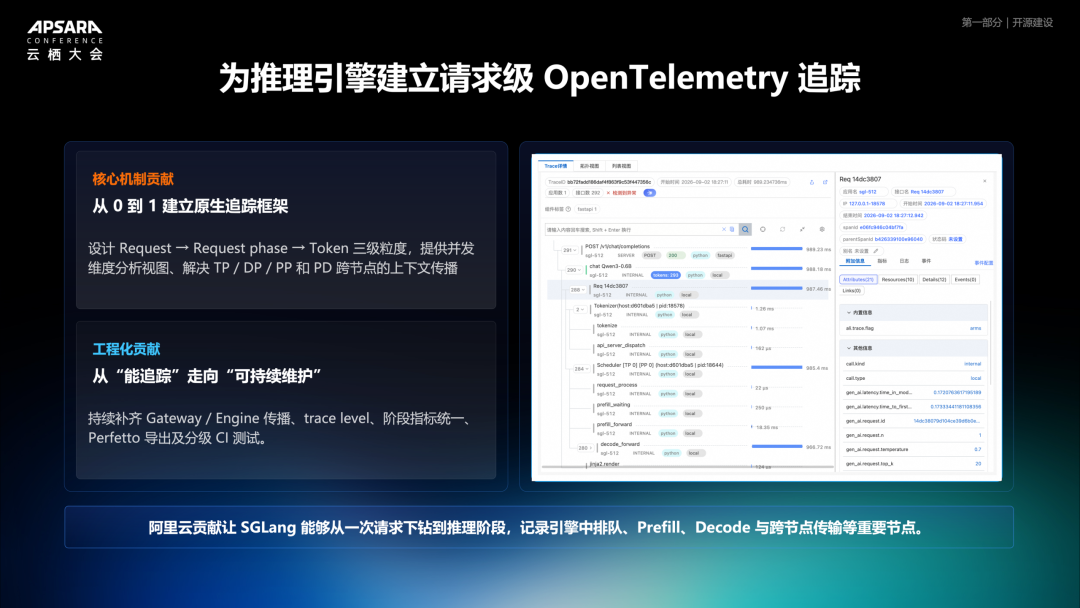
除了在 Agent 层面,我们还在推理引擎侧做了观测实践。我们希望把 Agent 的请求一路透传到推理引擎,完整看到这条链路到底慢在哪里、卡在哪里。以社区框架 SGLang 为例,阿里云的贡献让它能从一次请求下钻到推理阶段,记录引擎中排队、Prefill、Decode 与跨节点传输等重要节点:
核心机制贡献(从 0 到 1 建立原生追踪框架):设计 Request → Request Phase → Token 三级粒度,提供并发维度分析视图,解决 TP/DP/PP 和 PD 跨节点的上下文传播。
工程化贡献(从“能追踪”走向“可持续维护”):持续补齐 Gateway/Engine 传播、trace level、阶段指标统一、Perfetto 导出及分级 CI 测试。
这样就能分级采集到每一次 Token 预测的概率层面,更细腻地观测每个请求的实际执行情况。这部分能力也一并向社区捐献、合并了进去。请求级 Trace 能告诉我们一次调用慢了或答错了,Token 级观测则能进一步定位到具体 Token、生成阶段和跨租户资源干扰。
LoongSuite Pilot:面向 Coding Agent 场景的标准化采集
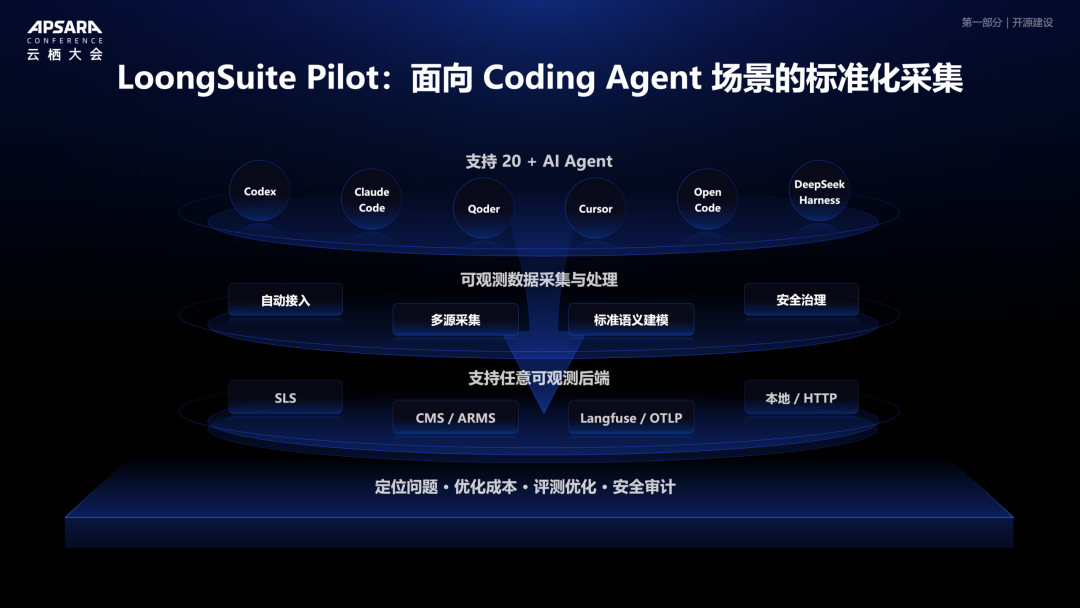
LoongSuite Pilot 是我们面向 Coding Agent 场景推出的标准化采集能力。它解决的问题是:我们有非常多的 Coding Agent,无论在个人办公场景还是生产中都会大量使用,比如 Claude Code、Codex 等,它们在完成复杂任务时也需要把执行轨迹记录下来。
通过 LoongSuite Pilot,可以一站式完整采集各种 Coding Agent(支持 20+ AI Agent,覆盖 Codex、Claude Code、Qoder、Cursor、OpenCode、DeepSeek、Harness 等),把观测对象从服务进程扩展到闭源 Agent、开发机和 CI,统一映射到 GenAI SemConv,再发送到任意可观测后端(SLS、CMS/ARMS、Langfuse/OTLP、本地/HTTP)。基于这份数据,就能定位问题、发现 Token 消耗、做评测优化、优化 Skill、调优 Agent,甚至做安全审计——比如知道它访问了什么不该访问的数据、执行了什么不该执行的命令。
社区贡献:让生产经验持续进入 OpenTelemetry
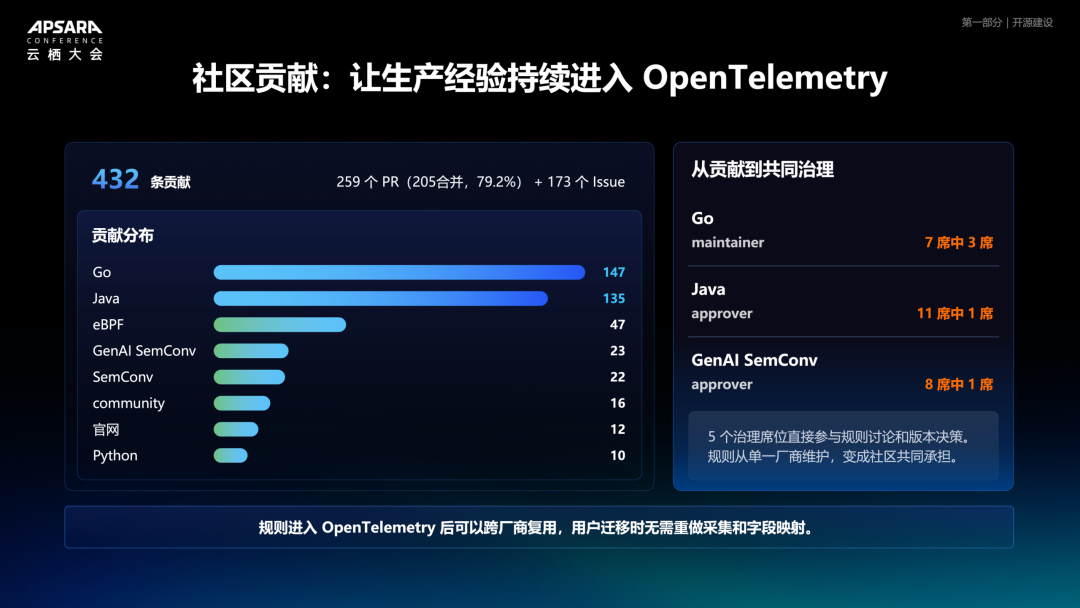
过去几年持续贡献,我们向社区提供了大量 PR 和 Issue,也实际拿到了很多 maintainer 和 approver 席位,参与到 OpenTelemetry 社区的治理规范中:
贡献分布:三年内共 432 条贡献,259 个 PR(205 已合并,79.2%)+ 173 个 Issue;其中 Java 135、Go 147、eBPF 47、Python 10、SemConv 23、GenAI SemConv 12、community 22、官网 16。
治理席位:Go maintainer(7 席中 3 席)、Java approver(11 席中 1 席)、GenAI SemConv approver(8 席中 1 席),共 5 个治理席位直接参与规则讨论和版本决策。
规则进入 OpenTelemetry 后可以跨厂商复用,用户迁移时无需重做采集和字段映射。规则从单一厂商维护,变成社区共同承担。就在最近,OBI 项目又有团队成员新晋升为 approver,再添一个新席位。
UModel 语义运行时:围绕对象组织故障上下文
数据辛辛苦苦采集进来,Agent 就能把故障看明白吗?这就是第二道墙——上下文读不懂。LLM 刚出来时,我们欣喜地看到它能读懂错误日志,但随着真正的业务落地,我们发现真正关键的是让模型理解背后的数据、对象、关系,理解对象之间的关系和时间,以及这些数据的来源。如果没有这些东西的对齐,Agent 在每一次调查里都可能一本正经地胡说八道,这样的结果让 SRE 同事难以信赖。UModel 要做的,就是围绕当前故障对象,把分散在各个监控系统的指标、日志、链路、事件统一组织起来,形成一个可查询、可追溯、可继续补充证据的调查上下文。
(一)真实案例:Checkout Service 成功率下降
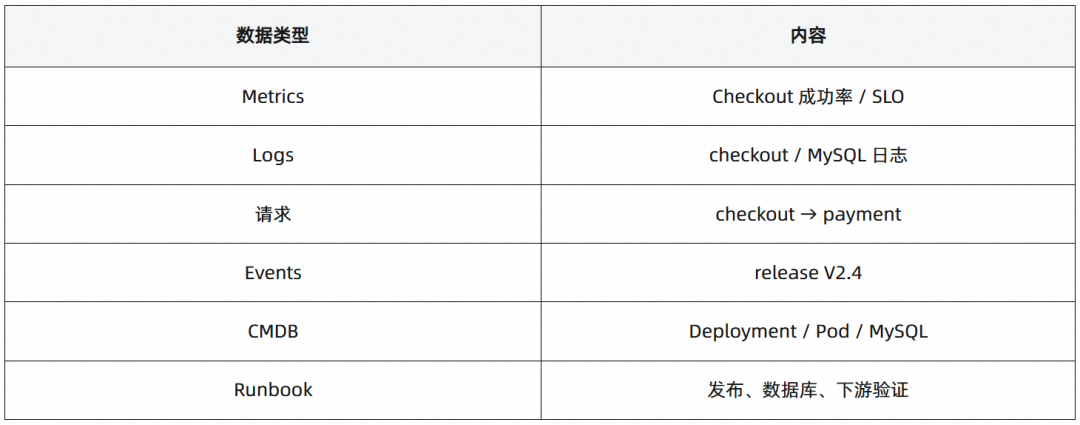
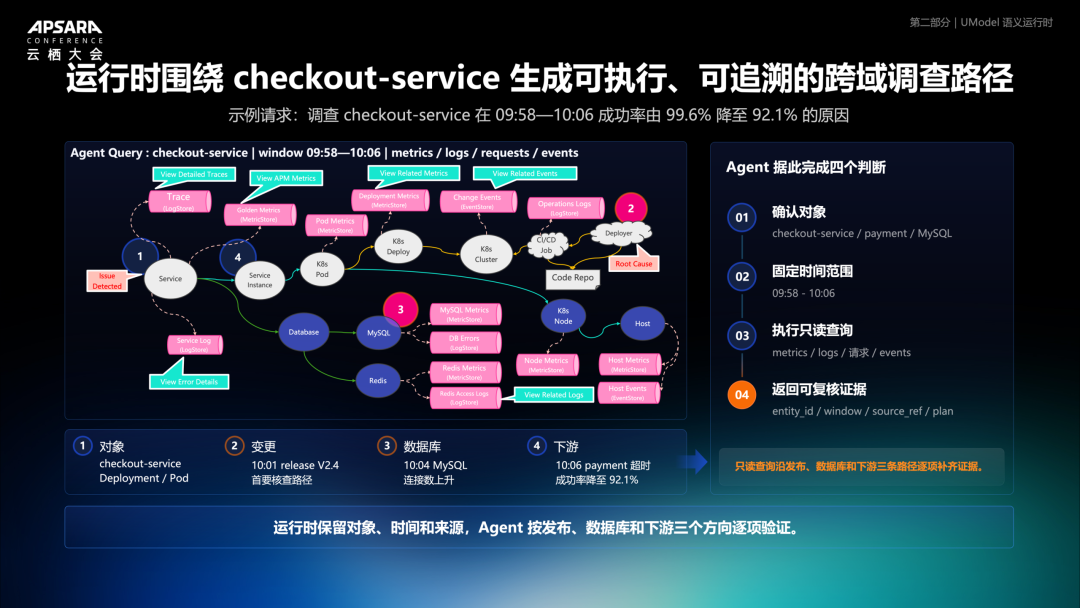
以 OTel Demo 中的 Checkout Service 为例。业务侧最先感知到的现象很直接:Checkout Service 支付成功率在 3 分钟内从 99.6% 降至 92.1%,下降了 7.5 个百分点。用户其实不会关心这是数据库、容器还是下游的问题,他会投诉支付不顺畅、结算不顺畅。而对 AgenticOps 的 Agent 来说,任务就是从业务现象出发去调查排查。Agent 可访问的数据看起来已经非常齐全:
再看时间线:09:58 起,10:01 发布 V2.4,10:04 数据库连接数上升,10:06 payment 超时。SRE 的第一反应往往是“是不是这个发布引起的故障”——这是有经验的人的合理直觉。但时间相近的三条线索还不能证明因果关系,发布仍只是一个待验证的假设。
Agent 真正需要确认的是:这次发布影响了哪些实例?连接数变化对应哪个 MySQL 对象?发生超时的 payment 调用和成功率下降的 Checkout Service 是否在同一个依赖路径上?要把所有事实放到同一个空间、同一个时间窗口内,才能判断它们如何关联。于是有了四个关键判断:哪个对象先变化?哪条证据支持原因?异常怎样传播?下一步验证什么?
(二)UModel 的三层结构:聚合对象、关系、状态和证据,形成 Agent 可继续执行的调查上下文
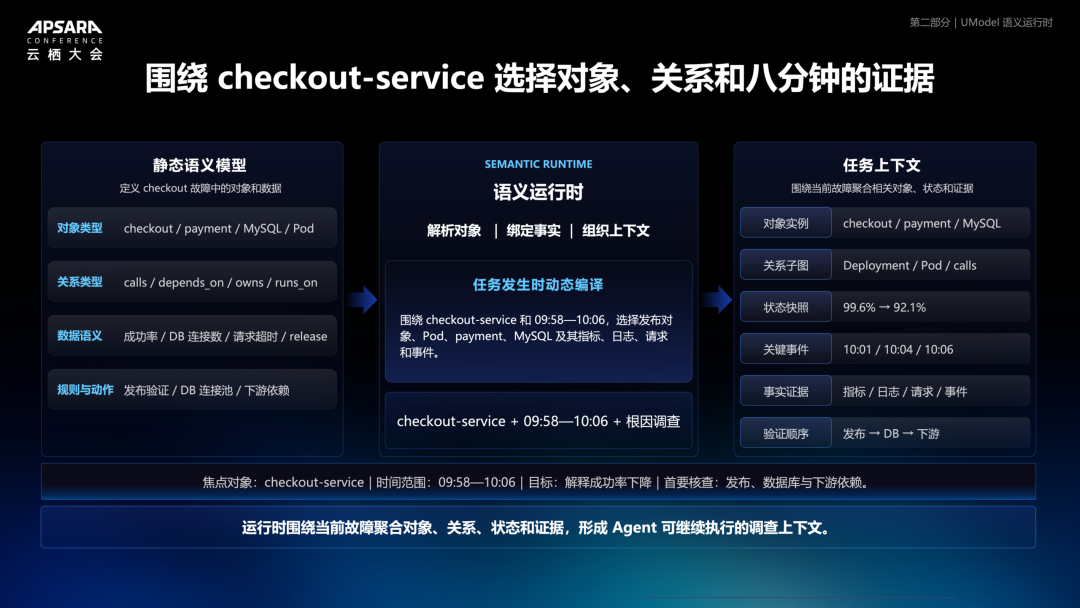
UModel 通过“静态语义模型 → 语义运行时 → 任务上下文”三层结构,把分散信息组成调查所需的上下文:
静态语义模型:定义 checkout、payment、MySQL、Pod 等对象类型,定义它们之间的关系类型(calls / depends_on / owns / runs_on),定义数据语义(成功率 / DB 连接数 / 请求超时 / release)以及规则与动作(发布验证 / DB 连接池 / 下游依赖)。没有这一层约束,同一个对象在不同系统里可能一直对不上。
语义运行时:任务发生时动态编译,只聚焦当前对象、当前时间窗口和与调查有关的事实。三个明确条件是——焦点对象 checkout-service、时间范围 09:58—10:06、目标是解释成功率下降(不是做巡检)。无关数据全部排除,只给 Agent 需要的关键数据。
任务上下文:输出的不是琐碎元数据,而是对象实例(Deployment/Pod/calls)、关系子图、状态快照(99.6%→92.1%)、关键事件(10:01/10:04/10:06)、事实证据(指标/日志/请求/事件),以及建议的验证顺序(发布 → DB → 下游)。
这样 Agent 既能看到成功率下降,也能知道这组变化对应到哪组数据里。
(三)跨域调查:保留对象、时间和来源
我们来看具体怎么排查,用户的请求很朴素:“请调查 checkout-service 在 09:58—10:06 成功率由 99.6% 降至 92.1% 的原因。”这背后要跨越发布系统、数据库、调用链、监控日志多个数据域。沿着确认的对象和时间窗口,Agent 执行只读的跨域调查,按三条路径逐项补齐证据:
1. 变更方向:10:01 发布的 V2.4 版本到底影响了哪些对象;
2. 数据库方向:10:04 连接数上升的具体表现和相关日志;
3. 下游方向:10:06 payment 超时和 checkout 成功率之间的关系。
这里有一组关键字段是 Agent 必须反馈的:entity_id、window、source_ref、plan。也就是说,Agent 不光要自己排查,还要告诉用户——自己排查的对象是哪个实体、属于哪个时间范围、来自哪里,以及这次调查服务于整体排查链路中的哪一环。这样继续排查下去,就不会丢失最初定义的问题边界。
有了这样的排查记录,人可以复查 Agent 的排查过程是否靠谱,另一个 Agent 也可以按它的排查链路做 validate。通过实验我们发现,这能在不同模型上提高 50% 到 100% 的诊断质量。
(四)UModel 开源建设:对象图、查询服务与 Agent 已形成公共语义标准
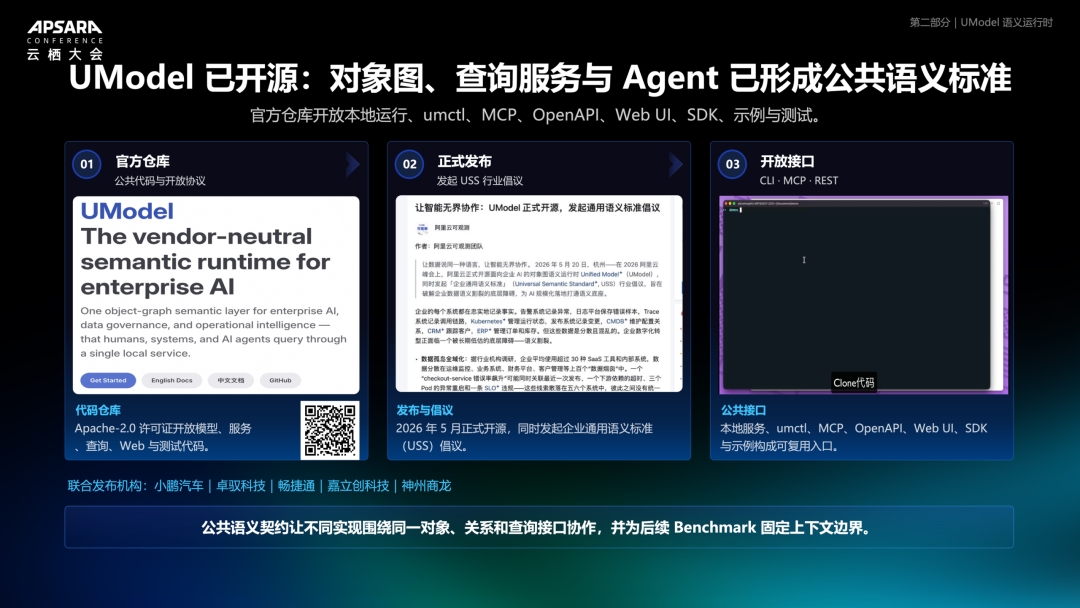
我们希望这种运维数据的语义建模不只内部团队使用,也希望对其他企业开放——尤其是现在大家可能是多云,我们希望不同产品都能用统一的方式建立运维的语义运行时,形成统一的语义规范,这样我们在跨产品问题追踪的时候可以使用相同的一套语言规范。这也是我们开源 UModel 的原因,具体包括三部分:
代码仓库:以 Apache-2.0 许可证开放模型、服务、查询、Web 与测试代码。它不只是一个概念或架构图,而是真正可运行、可查询、可接入 Agent 的公共资产。
发布与倡议:2026 年 5 月正式开源,同时发起企业通用语义标准(USS)倡议,联合发布机构包括小鹏汽车、卓驭科技、畅捷通、嘉立创科技、神州商龙。
开放接口:本地服务、umctl、MCP、OpenAPI、Web UI、SDK 与示例构成可复用入口,适配不同开发者的使用习惯。
统一的语义运行时对评测也很重要:可以固化对象关系、固化问题、固化查询时间与窗口、固化查询入口,这样不同 Agent 面对相同问题时,就能公平地比较分数——这也为后续的 Benchmark 固定了上下文边界。
Benchmark 建设:让能力经得起反复评测
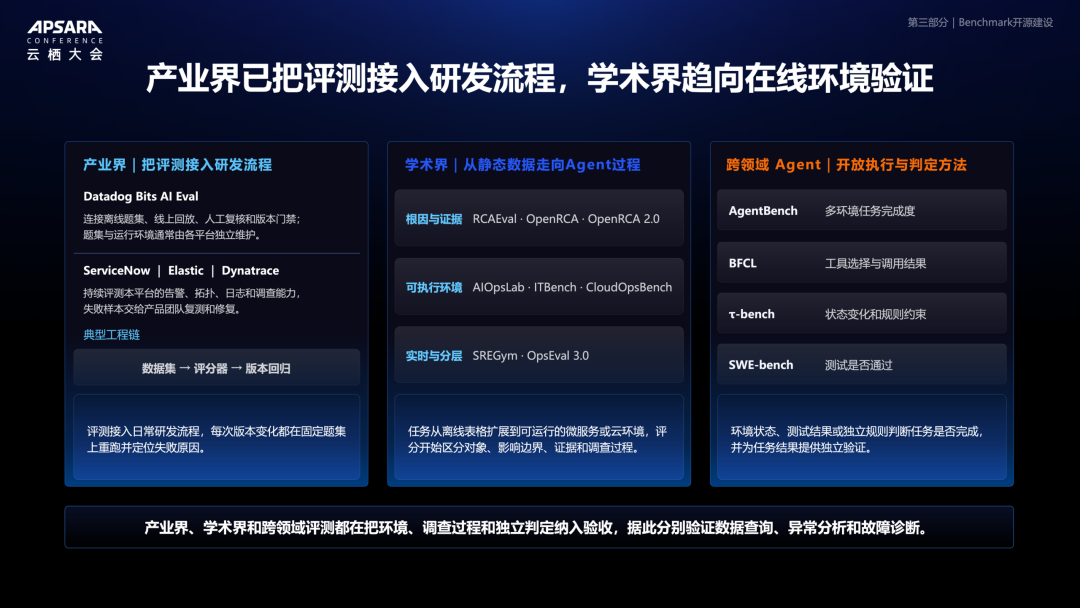
第三道墙是——上下文准备好了,Agent 就一定能做对吗?不见得。Agent 在 Demo 场景下成功定位根因、偶尔在线上生产环境立功,都让人兴奋,但这不足以证明能力是稳定的、可靠的、可以让 SRE 信赖的。真实的系统状态随时在变,故障证据每次都不一样,模型、工具、Skill、提示词也在变。如果每次测试面对的条件都不同,就很难判断提升到底是不是真正的提升。
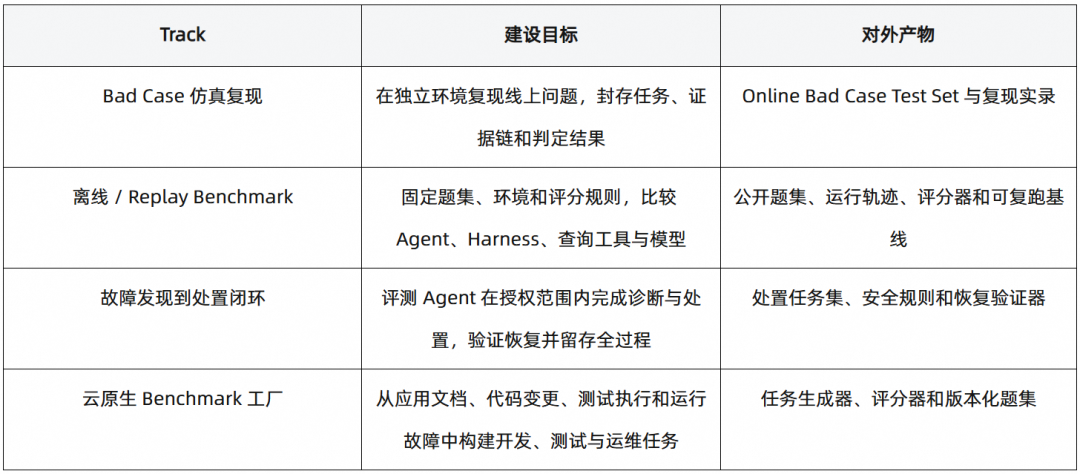
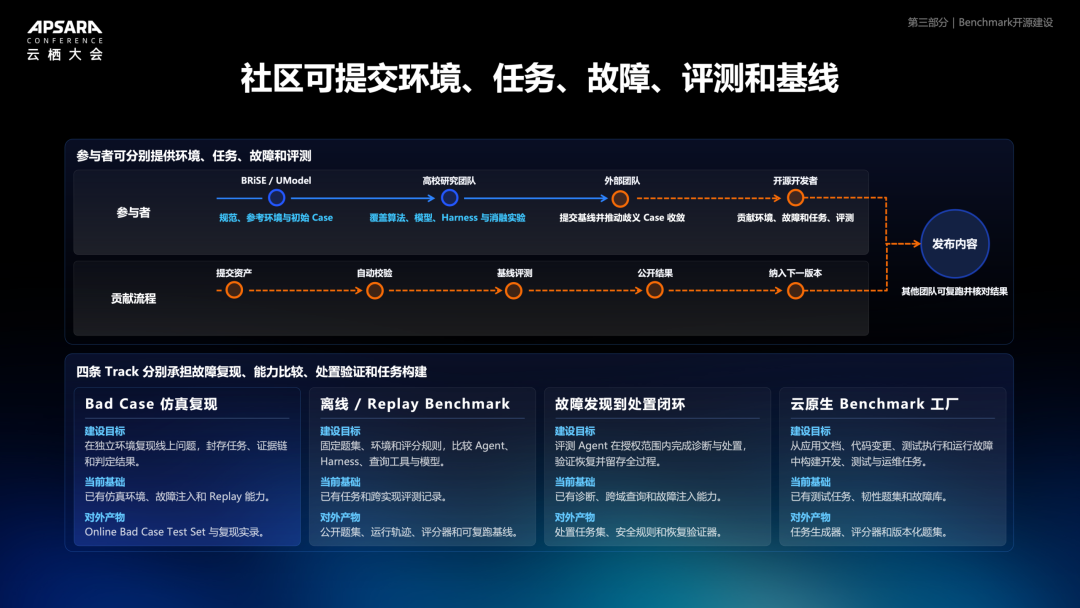
这本质上是一个系统化的实验设计与评估问题,是数据科学问题。我们要做的是降低它的门槛:把故障环境、故障任务和评分标准固化下来,让同一个问题可以被反复执行、被不同团队执行,从而在相同条件下得到相对公平的比较。BRiSE 就是负责这一部分的。
(一)行业需求决定 Benchmark 应该覆盖哪些真实任务
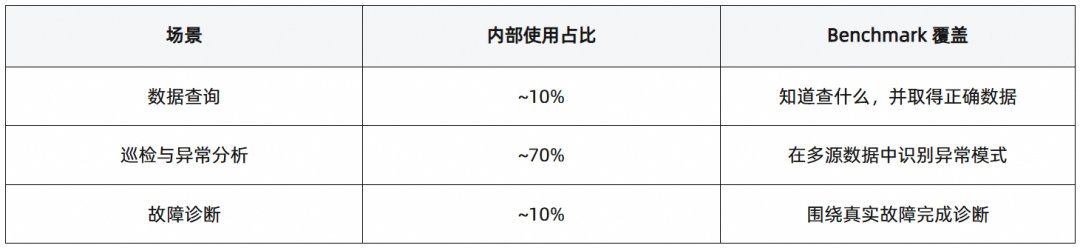
我们通过阿里云 STAROps 能触达到不同行业的用户,和他们的接触中去深入了解他们日常在做什么、问题背后需要什么样的评测。不同系统使用不同对象,但评测任务都需要说明对象、关系、时间范围、证据来源和交付结果:
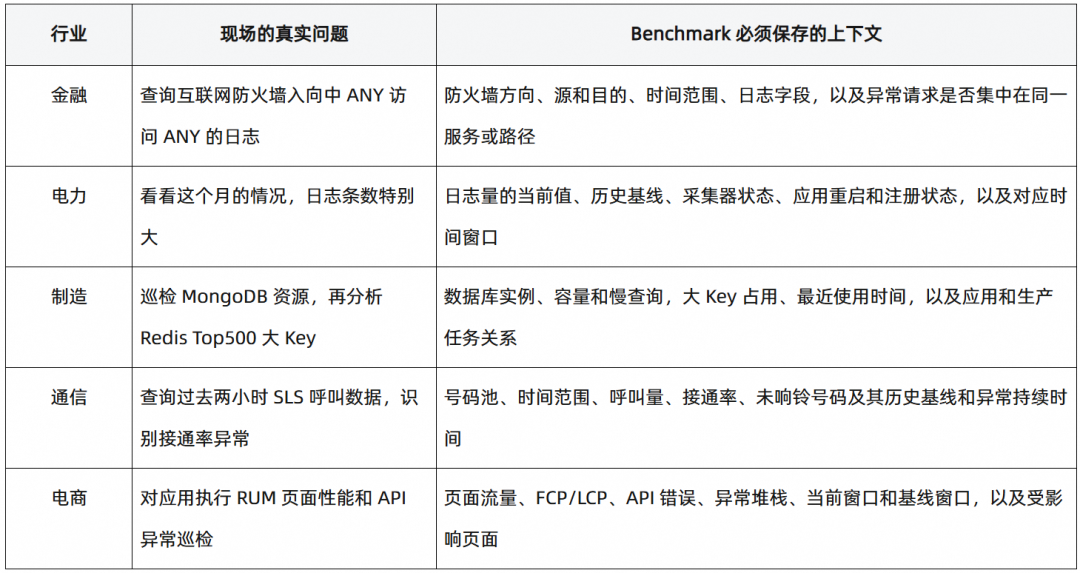
一个共同的启示是:关键词查到了,不代表题就答对了。比如金融场景听起来只是查日志,实际上必须明确方向、源、目的、时间范围和字段含义,才能判断异常请求是否集中在某个服务或路径上。
(二)可以重复评测和优化的流水线
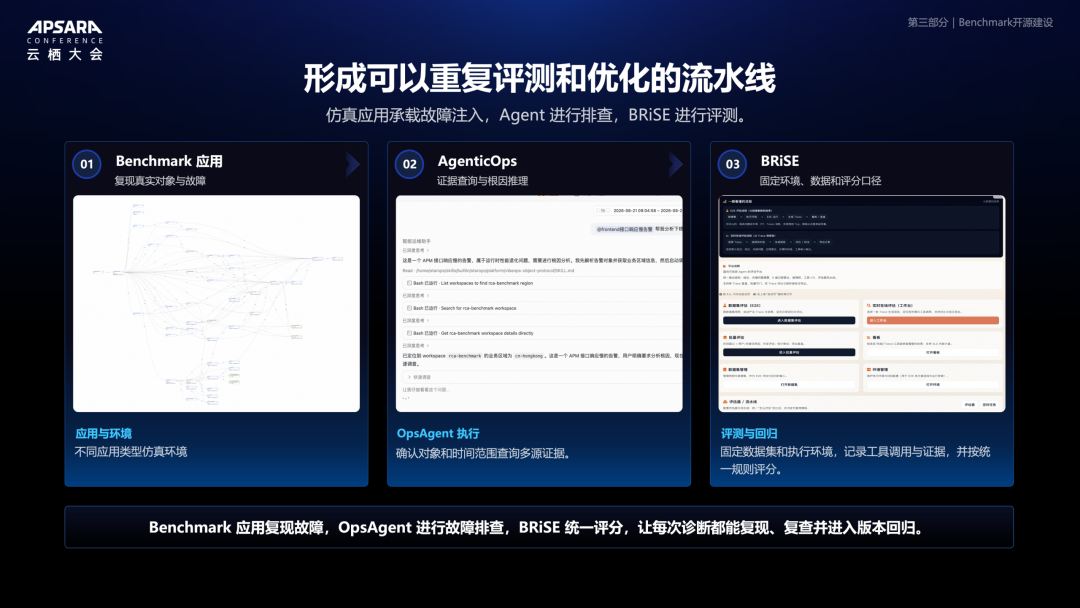
要验证这项工作,整个流程里有三个角色分工明确:
Benchmark 应用:复现真实对象与故障数据。它负责提供问题发生的环境——“Checkout Service 过去一段时间成功率下降,什么原因”这句话的背后,是一个非常复杂的仿真应用和大量故障注入。
OpsAgent(被测 Agent):证据查询与根因推理。可以是 STAROps Agents、任意 Ops Agents,或通用 Agents,负责确认对象和时间范围、查询多源证据,我们记录它的排查过程和结论。
BRiSE:固定环境、数据和评分口径,统一评分。
把这三件事分开,就能分别检查:题目是否有效、有难度、有区分度;Agent 是怎么做的;结果怎么判断。固定数据集和执行环境,记录工具调用与证据,按统一规则评分——让每次诊断都能复现、复查并进入版本回归。
JOTO 企业落地观察
- AgenticOps 的可观测底座已从单点埋点演进为“采集-建模-评测”三位一体工程。对企业部署而言,这意味着不能再将 Agent 视为黑盒调用,而需前置规划其可观测性契约——包括语义规范对齐、上下文对象建模、评测用例沉淀,否则后期调试成本将指数级上升。
- UModel 提出的“静态语义模型→语义运行时→任务上下文”三层结构,为企业构建统一运维知识图谱提供了可落地方案。这类系统取舍在于:是否接受初期投入建模成本,以换取长期跨团队、跨工具、跨云环境的故障协同效率;拒绝建模则必然陷入多源数据拼凑与人工翻译的泥潭。
- BRiSE 所代表的“环境-任务-评分”三要素固化,标志着 Agent 能力评估正从主观演示转向工程化验收。对企业智能体工程而言,这意味着必须将 Benchmark 流水线纳入 CI/CD,使 Agent 迭代与模型、工具、提示词变更解耦,避免“每次升级都需重新验证全量场景”的反模式。
- OpenTelemetry GenAI SemConv 的双轨协作路径(LoongSuite 验证→社区标准化)揭示了企业参与开源的真实节奏:内部先行验证是获得社区话语权的前提,但最终必须回归开放标准。这对 RAG 知识工程有直接启示——私有知识增强若不映射到统一语义框架,将无法与外部工具链协同演进。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们