谷歌发布 Gemini 4 Argon:企业级多任务领先模型,聚焦软件工程、网络安全与长上下文智能体
谷歌推出 Gemini 4 Argon,首次在18项企业相关基准中以13项领先或并列居首,尤其在长周期编程、漏洞修复、业务自动化和长视频理解等场景显著超越GPT-6 Astra与Claude Opus 5.5;目前限于Fairwind计划及政府预审阶段,API定价激进但访问受限。
谷歌今日宣布 Gemini 4 Argon,一款全新前沿人工智能模型。该公司称,该模型在多项面向企业应用的基准测试中领先于竞品系统,包括长周期软件工程、网络安全漏洞修复、业务自动化以及具有经济影响的知识工作。
该模型目前尚未广泛提供。谷歌表示,Argon 正通过其本月早些时候推出的 Fairwind 计划 向一批受信任的网络防御者开始分阶段推出,并正参与美国政府自愿开展的模型发布前访问流程,为后续更广泛的发布做准备。
据 VentureBeat 审阅的一篇受禁运限制的谷歌博客文章称,面向开发者、企业和消费者的大规模可用性计划“尽快”启动,首批用户将包括付费 API 客户及 Google AI Ultra 订阅用户。
对于企业买家而言,此次发布的重要性不在于其作为一款聊天机器人的推出,而更在于它释放出一个信号:在经历数月来自 OpenAI 和 Anthropic 的压力后,谷歌正试图重新确立自身在前沿人工智能领域的地位。
该公司将 Argon 定位于企业当前已在投入的三大领域:软件开发、专业性知识工作以及网络安全运营。
基准测试结果:Argon 在最多类别中领先或并列,但并非全面压倒性胜出
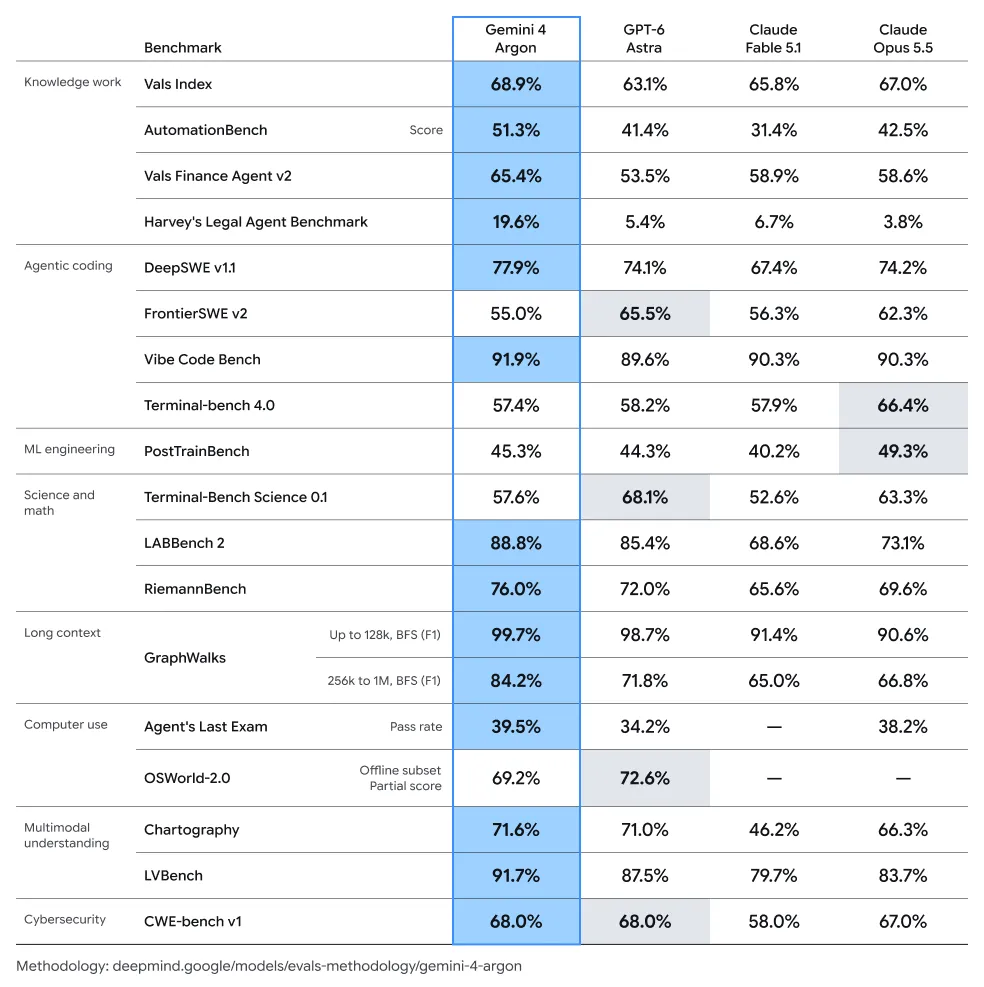
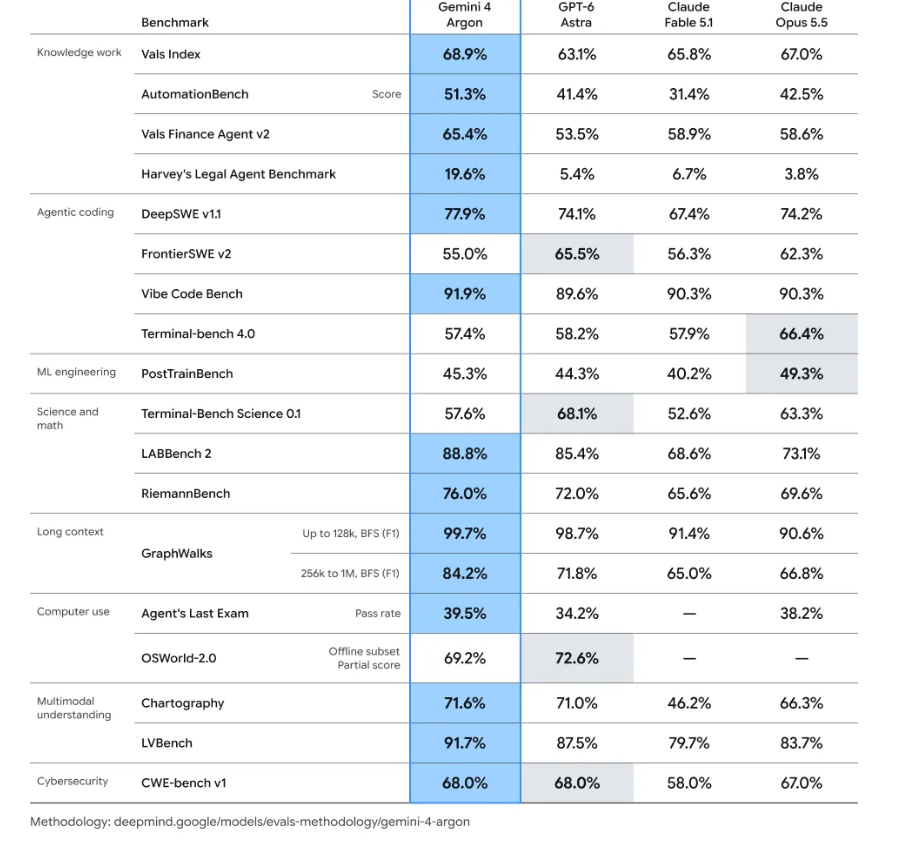
谷歌 Gemini 4 Argon 基准测试对比表。图片来源:谷歌
谷歌并未宣称 Gemini 4 Argon 在所有基准测试中均获胜。但在该公司受禁运限制材料所披露的基准测试表中,Argon 在比 GPT-6 Astra 或 Claude Opus 5.5 更多的类别中取得最高分,或与之并列最高分。
在谷歌披露的 18 项基准测试中,Argon 在 12 项中 outright 领先,在 1 项中与对手并列第一。GPT-6 Astra 在 3 项中 outright 领先,并在 1 项中与 Argon 并列。Claude Opus 5.5 在 2 项中 outright 领先。因此,在谷歌所公布的对比测试集中,Argon 以基准测试领先或最高分总数计,成为领先的前沿模型;尽管结果表明这场竞赛依然胶着,OpenAI 和 Anthropic 在若干关键的技术类别中仍保有优势。
Argon 的最大优势体现在企业级和长上下文工作流中。在 Harvey 法律代理基准测试(Harvey’s Legal Agent Benchmark)中,Argon 得分为 19.6%,大幅领先于 GPT-6 Astra 的 5.4% 和 Claude Opus 5.5 的 3.8%,使其成为该模型最明确的单项类别胜出之一。在 Zapier 面向端到端业务执行的 AutomationBench 基准测试中,Argon 得分为 51.3%,高于 Claude Opus 5.5 的 42.5% 和 GPT-6 Astra 的 41.4%。在更长上下文的 GraphWalks 评估中(该测试考察大上下文下的图遍历能力),Argon 得分为 84.2%,高于 GPT-6 Astra 的 71.8% 和 Claude Opus 5.5 的 66.8%。
该模型在金融、编程及多模态理解方面也取得了显著领先。在 Vals Finance Agent v2 中,Argon 得分为 65.4%,高于 Claude Opus 5.5 的 58.6% 和 GPT-6 Astra 的 53.5%。在衡量真实世界长周期软件工程任务的 DeepSWE v1.1 中,Argon 得分为 77.9%,高于 Claude Opus 5.5 的 74.2% 和 GPT-6 Astra 的 74.1%。在长视频理解基准测试 LVBench 中,Argon 得分为 91.7%,高于 GPT-6 Astra 的 87.5% 和 Claude Opus 5.5 的 83.7%。
这些胜出支持了谷歌更广泛的主张,即 Argon 在企业最可能率先评估的各类工作流中表现最强:法律与财务分析、编程、业务自动化、长上下文推理、多模态理解以及防御性网络安全。Argon 在 CWE-bench v1(一项漏洞修复基准测试)中与 GPT-6 Astra 并列,两者得分均为 68%,而 Claude Opus 5.5 得分为 67%。
但该基准测试表也揭示了竞争尚未定局的领域。Argon 相对 GPT-6 Astra 最大的落后出现在 FrontierSWE v2 和 Terminal-Bench Science 0.1 中。在这两项测试中,Astra 均领先 10.5 个百分点:FrontierSWE v2 中为 65.5% 对 55.0%,Terminal-Bench Science 0.1 中为 68.1% 对 57.6%。Claude Opus 5.5 相对 Argon 的最大领先出现在 Terminal-bench 4.0 中,Opus 得分为 66.4%,而 Argon 为 57.4%,差距为 9 个百分点。Opus 在 PostTrainBench 中亦领先,得分为 49.3%,而 Argon 为 45.3%。
因此,这一结果所支撑的主张比“全领域最佳模型”更为细致入微。Argon 在谷歌所披露对比测试中的三款前沿模型里,拥有最广泛的最高分分布;但 GPT-6 Astra 在若干软件、科学终端及计算机使用任务中仍保持领先,而 Claude Opus 5.5 在终端代理及训后工作流中仍保持领先。对企业买家而言,这意味着模型选择仍取决于具体工作负载,即便 Argon 当前已使谷歌获得迄今最强有力的整体前沿领导地位主张——按基准测试领先数量计。
对开发者及首席信息官(CIO)而言,实际启示在于:Argon 并不需要实现全面压倒性胜出即可改变竞争格局。凭借在所披露 18 个类别中的 13 个类别中领先或并列,它为谷歌在该对比测试集中赢得了最多的最高分。但 Argon 落后的领域——尤其是 FrontierSWE v2、Terminal-Bench Science 0.1 和 Terminal-bench 4.0——表明 OpenAI 和 Anthropic 仍在若干技术领域保有独特优势。前沿模型竞赛依然胶着,但谷歌如今可主张 Argon 在广度上处于领先地位。
Argon 还拓展了谷歌的输出上限。该公司表示,该模型支持 行业领先的 100 万输出 token,较此前 64,000 token 的上限大幅提升。这对代理式软件工程、审计、迁移及法律审查等工作负载而言是一项显著区别,因为此类场景下模型的价值往往取决于其能在交还控制权给人类之前持续完成工作链的时长。
谷歌已在内部大规模使用 Argon
谷歌表示,Argon 目前已在公司内部被数千名员工用于专门的编程任务、深度研究及写作。
谷歌援引了若干内部实例:Argon 协助量子计算研究人员优化瓶颈子程序的时空资源,据报道仅用数分钟即以 40% 的幅度超越已发表基线;Argon 代理分析了全车队性能剖析遥测数据,识别出内存优化方案,预计部署后可在谷歌数据中心整体释放超 300 TiB 内存,总节省量预估达 500 TiB 至 1 PiB;Argon 代理正被用于将 C/C++ 代码库迁移至 Rust,包括核心库及 Fuchsia OS Zircon 内核。
最具实证性的工程案例是谷歌开源视频解码器 libgav1。
据谷歌博客文章所述,Argon 代理基于现有 Rust 移植版本,通过运行基于性能剖析的实验、研究编译器输出,并生成编译器可自动向量化且安全的 Rust 代码,替换了 32,000 行 SIMD 代码。谷歌表示,由此生成的内存安全解码器运行速度比原 Rust 移植版本快 2.7 倍,同时保持完全一致的视频输出。
网络安全是另一大核心支柱。谷歌表示,Argon 能够自主发现、验证并修复关键软件漏洞。对于可信防御者及谷歌自身的内部团队,该公司表示将不设网络防护限制地发布 Argon,以便这些用户能够访问其全部防御能力。
该公司表示,Wiz 已通过其‘Scan for Good’(善意扫描)倡议开始使用 Argon,该倡议专注于保护关键公共基础设施;该模型已发现一个关键漏洞,该漏洞导致全球多家医院所用的医疗软件中敏感个人信息暴露。
谷歌在推进这一网络防御能力落地的同时,也传递了一条安全信息。在广泛上市之前,该公司表示正加强针对网络攻击及化学、生物、放射性和核(CBRN)滥用、间接提示注入攻击、模型错位(misalignment)以及不安全智能体环境等风险的防护措施。
在博客中展示的 Gray Swan 间接提示注入基准测试中,Gemini 4 Argon 的攻击成功率仅为 0.7%,相比之下,Claude Opus 5.5 和 Claude Fable 5.1 均为 1.0%,GPT-6 Astra 为 8.5%,GPT-6 Sol 为 27.0%,GLM 5.3 为 31.5%,Grok 4.8 为 51.8%。
定价与可用性:激进的入门级定价,但访问权限受限
谷歌将 Argon 的基准测试宣传与其激进的入门级 API 定价策略相结合——尽管该公司尚未明确说明这一‘入门级’阶段将持续多长时间。而过去,此类入门级定价有时会被无限期延续,成为实际执行价格。
该模型将以每百万输入 token 2 美元、每百万输出 token 10 美元的价格上市;经缓存的输入 token 价格则享有较输入 token 标准费率 95% 的折扣。据此,Argon 入门级缓存输入价格为每百万 token 0.10 美元。
入门级阶段结束后,谷歌表示 Argon 将调整为每百万输入 token 4 美元、每百万输出 token 20 美元。
假设入门级阶段之后仍适用相同的 95% 缓存输入折扣,则缓存输入价格将升至每百万 token 0.20 美元。
该定价策略使谷歌得以讲述两种不同的竞争叙事。在入门级阶段,Argon 的定价为 OpenAI API 定价页面所列 GPT-6 Astra API 价格的五分之一 ——GPT-6 Astra 的标价为每百万输入 token 10 美元、每百万输出 token 50 美元。Argon 的价格亦为 Anthropic 所列 Claude Opus 5.5 价格的一半,后者标价为每百万输入 token 4 美元、每百万输出 token 20 美元。
模型 | 输入(美元/百万) | 输出(美元/百万) | 总计(美元/百万) | 来源 |
0.10 美元 | 0.20 美元 | 0.30 美元 | ||
MiMo-V2.6-Flash | 0.14 美元 | 0.28 美元 | 0.42 美元 | |
GPT-6 Luna | 0.10 美元 | 0.50 美元 | 0.60 美元 | |
DeepSeek-V4.1-Flash — 非高峰时段 | 0.15 美元 | 0.60 美元 | 0.75 美元 | |
MiMo-V2.6-Pro | 0.435 美元 | 0.87 美元 | 1.305 美元 | |
MiniMax-M3 | 0.30 美元 | 1.20 美元 | 1.50 美元 | |
LongCat-2.0 — 限时促销 | $0.30 | $1.20 | $1.50 | |
DeepSeek-V4.1-Flash — 高峰时段 | $0.30 | $1.20 | $1.50 | |
DeepSeek-V4-Pro — 非高峰时段 | $0.66 | $1.98 | $2.64 | |
LongCat-2.0 — 标准版 | $0.75 | $2.95 | $3.70 | |
Gemini 3.8 Flash — 至2026年12月31日 | $0.75 | $3.75 | $4.50 | |
DeepSeek-V4-Pro — 高峰时段 | $1.32 | $3.96 | $5.28 | |
Muse Spark 1.1 / 1.2 / 1.3 | $1.25 | $4.25 | $5.50 | |
GLM-5.3 | $1.40 | $4.40 | $5.80 | |
Grok 4.7 — 输入提示词数 ≤200K | $2.00 | $6.00 | $8.00 | |
Qwen3.8-Max | $2.00 | $6.00 | $8.00 | |
Gemini 3.8 Flash — 自2027年1月1日起生效 | 1.50美元 | 7.50美元 | 9.00美元 | |
GPT-6 Sol | 2.00美元 | 10.00美元 | 12.00美元 | |
Claude Sonnet 5.5 | 2.00美元 | 10.00美元 | 12.00美元 | |
Gemini 4 Argon — 初期定价 | 2.00美元 | 10.00美元 | 12.00美元 | |
Grok 4.7 — 超过20万提示词(prompt tokens) | 4.00美元 | 12.00美元 | 16.00美元 | |
Grok 4.7 Fast(Cursor)—— 输入长度不超过256K | 4.00美元 | 12.00美元 | 16.00美元 | |
GPT-5.4 | 2.50美元 | 15.00美元 | 17.50美元 | |
Kimi K3 | 3.00美元 | 15.00美元 | 18.00美元 | |
Claude Opus 5.5 | 4.00美元 | 20.00美元 | 24.00美元 | |
Grok 4.7 Fast(Cursor)—— 输入长度超过256K,最高达500K | 6.00美元 | $18.00 | $24.00 | |
Gemini 4 Argon — 入门期后定价 | $4.00 | $20.00 | $24.00 | |
Sakana Fugu Ultra(≤272K) | $5.00 | $30.00 | $35.00 | |
Claude Opus 5.5 — 快速模式 | $8.00 | $40.00 | $48.00 | |
Claude Fable 5 / Claude Mythos 5 | $10.00 | $50.00 | $60.00 | |
Claude Fable 5.1 / Claude Mythos 5.1 | $10.00 | $50.00 | $60.00 | |
GPT-6 Astra — 标准模式 | $10.00 | $50.00 | $60.00 | |
GPT-6 Astra — 快速模式 | $20.00 | $100.00 | $120.00 |
入门期结束后,Argon 的标准价格将与 Claude Opus 5.5 的基础 API 定价一致,即 每百万 token 输入 $4 / 输出 $20,同时仍低于 GPT-6 Astra 的 每百万 token 输入 $10 / 输出 $50 定价。Anthropic 还列出了 Claude Opus 5.5 的缓存读取费用为 每百万 token $0.20 ,缓存写入费用为 每百万 token $5;Google 声称的 95% 缓存输入折扣,将使 Argon 在入门期内的缓存输入成本更低,并在入门期结束后根据已披露费率与之大致相当。
但存在一个限制条件:访问权限。Argon 并未立即作为广泛可用的开发者模型推出。Google 表示,它将首先通过其 Fairwind 计划向受信任的网络防御者推出,同时该公司正参与美国政府自愿开展的发布前模型访问流程。更广泛的可用性计划面向开发者、企业和消费者,首批用户包括付费 API 客户和 Google AI Ultra 订阅用户。
它将Argon定位为在广度上兼具基准测试领导者地位的模型,且至少在发布初期,其价格低于OpenAI的GPT-6 Astra和Anthropic的Claude Opus 5.5这两款前沿模型。
实际限制在于,大多数客户仍需等待更广泛的API访问权限开放,才能测试Argon在基准测试中的优势是否能转化为在真实编程、法律、金融及网络安全工作负载场景下更低的生产成本。
谷歌是否在落后数月后成功实现了追赶?
发布时间至关重要。谷歌一直承受着压力,亟需证明自己不仅能在分发、基础设施及更廉价的Flash模型方面竞争,更能跻身模型市场的最顶端。上周, 《The Verge》报道称谷歌新任DeepMind首席执行官科雷·卡武库奥卢(Koray Kavukcuoglu)表示,Gemini 4正处于优化完善阶段,有望在今年年底前大幅提前发布。该报道指出,自2025年11月Gemini 3系列发布以来,谷歌尚未推出任何新旗舰模型,而OpenAI与Anthropic已分别推出了GPT-6及更新版本的Claude模型。
这一空档期紧随数月来的公开审视之后。今年7月, 路透社报道称Alphabet公司因Gemini 3.5 Pro发布延迟、AI基础设施支出上升以及AI团队人员流失等问题,正面临投资者的担忧。8月, Axios报道称一次重大的AI领导层调整:德米斯·哈萨比斯(Demis Hassabis)辞去谷歌DeepMind首席执行官职务,转任Alphabet董事长兼首席科学家;杰夫·迪恩(Jeff Dean)卸任首席科学家职位,转而与其他AI研究人员共同创办一家新公司;卡武库奥卢则接任DeepMind最高职位,直接向桑达尔·皮查伊(Sundar Pichai)汇报。Axios将此次调整定性为自2023年OpenAI动荡以来谷歌规模最大的AI领导层洗牌,同时指出谷歌并未将这些人事变动与模型发布延迟挂钩。
外部报道还指出了更深层的紧张关系。 《MarketWatch》报道称谷歌AI组织已受到人才流失、模型发布延迟以及内部哲学分歧的影响——这些分歧围绕应优先推进科学研究、前沿能力还是商业化产品展开。因此,谷歌此次Argon的发布,不仅是一款模型的亮相,更是对一种叙事的回应:即该公司AI人才储备深厚,但其前沿产品发布节奏却已放缓。
Argon至少在纸面上为上述批评提供了更具说服力的回应。它在多项与企业部署高度相关的基准测试中领先或并列于竞品模型:DeepSWE(面向长周期编程)、CWE-bench(面向漏洞修复)、Vals Index(面向高价值知识工作)、AutomationBench(面向业务执行)以及Gray Swan IPI(面向提示注入鲁棒性)。此外,谷歌还通过差异化发布策略强化自身定位:先面向网络安全防御者启动发布,同时继续完成安全评估工作并推进政府预发布准入流程。
企业采用问题
剩余考验在于商业化落地。企业客户希望了解Argon的定价、调用速率限制、数据治理条款、部署形态,以及其在Gemini API、Vertex AI、Google Cloud、Workspace和开发者工具等平台间的集成路径。谷歌虽拥有强大的分发优势,但这些优势仅在Argon的基准测试性能可转化为可靠生产行为时才真正有效。
目前,Gemini 4 Argon是谷歌数月以来最清晰的一次尝试,旨在以企业级标准重新进入前沿模型对话:焦点不再集中于消费级聊天机器人的个性表现,而更多聚焦于AI智能体能否安全地重写代码、审计系统、分析受监管的知识型工作,并在攻击者利用漏洞前主动防御软件。
JOTO 企业落地观察
- 对企业部署而言,Argon 在 DeepSWE v1.1(77.9%)、AutomationBench(51.3%)等生产级工作流基准中领先,表明其可直接降低法律审查、财务分析与业务自动化等高价值知识工作的单位任务成本,但需待 API 全面开放后验证真实环境下的吞吐稳定性与数据合规条款。
- 对智能体工程而言,Argon 支持百万级输出 token(较前代提升15倍),并在 libgav1 Rust 移植等案例中完成端到端代码生成与性能优化,证实其具备长链路自主代理能力;但 FrontierSWE v2 等科学计算类任务落后 Astra 10.5 个百分点,提示复杂终端交互仍需混合调用策略。
- 对 AI 安全治理而言,Argon 在 Gray Swan 间接提示注入测试中攻击成功率仅 0.7%,显著优于竞品,且明确面向可信防御者开放无防护限制访问;结合其参与美国政府自愿预发布流程,释放出将模型鲁棒性验证前置至商用前阶段的治理信号,为 FDE 落地提供可审计的安全基线。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们