我给阶跃星辰 Step 5 Preview 出了一道工程题
作者以内测资格测试阶跃星辰新旗舰模型 Step 5 Preview(内测代号 water18-0910),设计一道含双层 Bug、存储重试逻辑与十项硬性验收的 Python 工程题,对比阿里 Qwen 3.8 Max 和月之暗面 Kimi K3。Step 5 Preview 以 328 秒、28 次迭代一次性全通过,展现分层修复、主动补测等工程品味。模型参数 600B(激活 27B),百万上下文,API 定价输入 1 美元/百万 tokens,输出 2.7 美元,成本为 GLM-5.3/Kimi K3 的 35%、Claude Opus 5 的 12.5%。
Step 5 Preview 的核心规格与定位
最近一段时间,我都在参与阶跃星辰的新旗舰模型小范围内测,我们测试的时候,模型代号还是 Water18。现在这款新旗舰有了正式的名字,叫 Step 5 Preview。先单独说明一下:我内测截图里的模型 ID water18-0910,代表的就是 Step 5 Preview。除了横评,文中提到的大部分测试结果都出自这个模型。
6 月份我曾经介绍过 Step 3.7 Flash,当时印象就很深刻。这次的 Step 5 Preview 是阶跃星辰的新一代旗舰基模,开源,面向长程任务、Agent 和 Coding 领域。它的 Slogan 是:Advancing the Pareto Frontier——向前一步,智能效率的新一代“帕累托前沿”。就我自己的使用体感,就是把智能和成本的最优平衡点,再往前推进一步。
基模的基本规格:稀疏 MoE 架构,总参数 600B,每个 token 激活 27B,上下文窗口百万 tokens,支持视觉输入(图像、文本输入,文本输出),在 AI 编程、软件工程、专业知识工作等任务上达到前沿水平,在金融领域表现尤为突出。
API 定价是输入每百万 tokens 1 美元、输出 2.7 美元,缓存输入比标准输入便宜 95%。
一道真实工程题的设计与要求
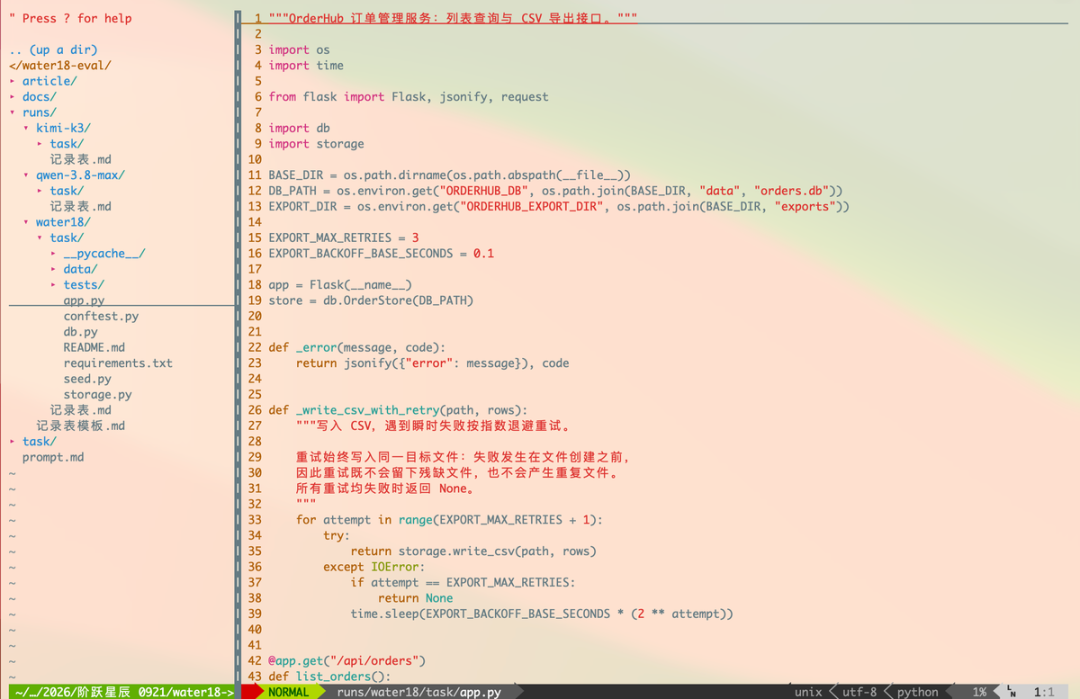
任务包是一个叫 OrderHub 的订单管理小系统,Python 加 Flask,四百多行代码,带 SQLite 数据库和一套 pytest 测试。系统能运行但有个真实的 bug:在订单列表里筛选“已支付”,导出,拿到的 CSV 只有 20 条,里面还混着其他状态的订单——数据库里有真实的 80 条已支付订单。我还有一个需求:存储层偶尔写入失败,请加个重试,最多三次。
bug 稍微有点深,表面那层在路由里:导出接口压根没把筛选参数传给查询层。后面还跟着一个:就算把参数传进去了,查询方法默认只返回第一页的 20 条。
只解决第一个问题,导出 80 条已支付订单时会发现自己只拿到 20 条,测试用例是通不过的。重试那儿也有个机关:存储层对同一个文件名的第一次写入必然失败,没有重试逻辑,第一次导出必然遇到 500。
验收标准一共十项:测试全绿、筛选导出条数和状态全对、导出不受分页影响、首次写入失败自动重试、重试不留重复或残缺文件、列表筛选分页无回归、无筛选导出全量 235 条、组合筛选正确、存储持续失败时返回明确错误、API 契约不变。每项都对应一条 curl 命令或一个测试用例。
三家模型的解法与表现对比
我肯定最关注模型的 Coding Agent 能力,所以拿到内测资格后,给它出了一道工程师经常会遇到的题:一个陌生的项目,一个能复现的 bug,一个顺手加上的小需求。为了测试它到底做得怎么样,我还拉来了另外两个小伙伴:阿里的 Qwen 3.8 Max 和月之暗面的 Kimi K3。三个模型拿到完全相同的任务包和提示词,在各自独立的目录和会话里开工,中途不许提问,我也不给任何提示。
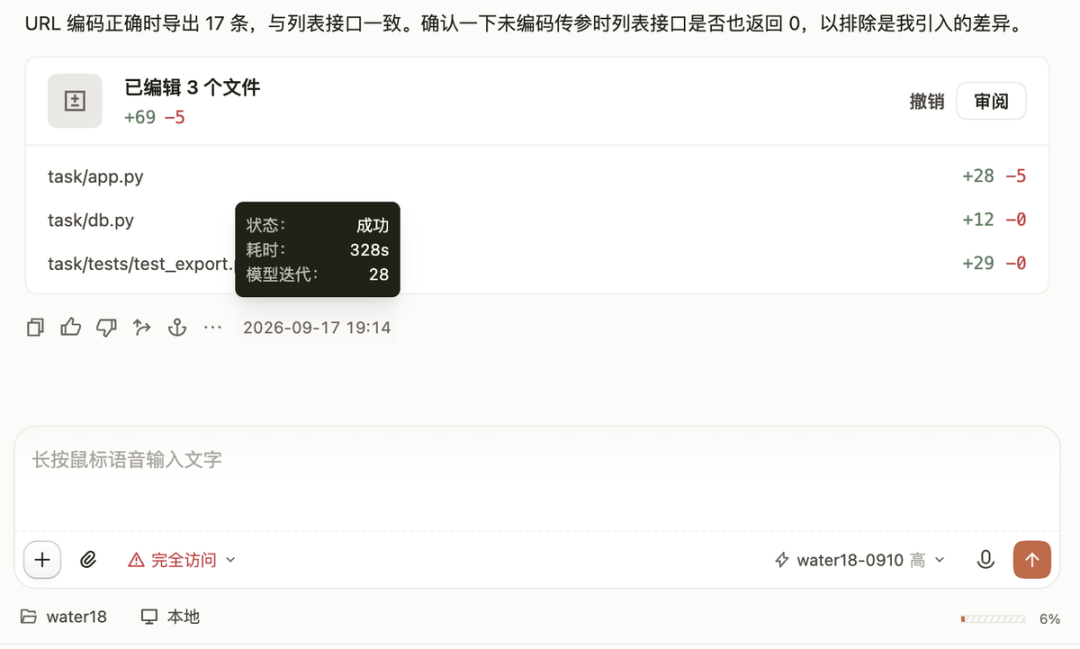
Step 5 Preview 用了 328 秒,28 次模型迭代,第一次宣告完成时,十项验收全部通过。零纠错,零澄清,零人工介入。这个成绩相当不错。
它没有在最省事的调用处打补丁,而是在数据访问层新增了一个专门的 query_all 方法,语义上把“不分页、取全部”说清楚,导出走新方法,列表的分页逻辑原样保留。分层边界是这类问题最容易被糊弄过去的地方,它处理得干净。
另一个细节是测试。它主动给项目补了两个测试用例,其中一个模拟存储彻底挂掉,验证重试耗尽之后不仅返回 500,而且导出目录里非常干净,临时文件全部清除。这条断言对应的是我验收清单里的第九项。
唯一的问题是存储持续失败时,它只返回了一个错误信息“export failed”,虽然够用,但运维显然更喜欢写着重试次数和底层原因的报错。
Qwen 3.8 Max 最快,206 秒,18 次迭代,同样十项全过。它只改了一个文件:路由层先查总数,再按总数一次性取回,绕开分页。务实有效,但查询层那个“默认只给 20 条”的行为给保留了,其他人可能会踩坑。补测试补得最勤,四个用例,覆盖关键词筛选、全量导出和非法参数;失败报错也写得最详细,带重试次数和原始原因。
Kimi K3 用时也在 320 秒左右,十项全过,解法和 Qwen 基本一致,重试封装得更讲究一些,错误信息里带上了底层原因。
测试环境是 macOS 加 Kimi Code 和 Qoder,三家使用完全相同的提示词、代码包和验收清单。
Step 5 Preview 的工程品味与成本优势
这是个带两层 bug、一个隐藏故障点、十项硬性验收的工程任务,放在去年足以难倒绝大多数模型,现在三家都能一次通过,而且都懂得补测试、不碰我设计的断言、保持 API 契约,非常厉害。
Step 5 Preview 让我记住的是它的工程品味:它是唯一一个把 fix 放回了原来位置的选手。快一分钟慢两分钟,对真实工程来说没那么重要;但留在查询层里的分页默认值,在现实的工程里总会坑下一个人。
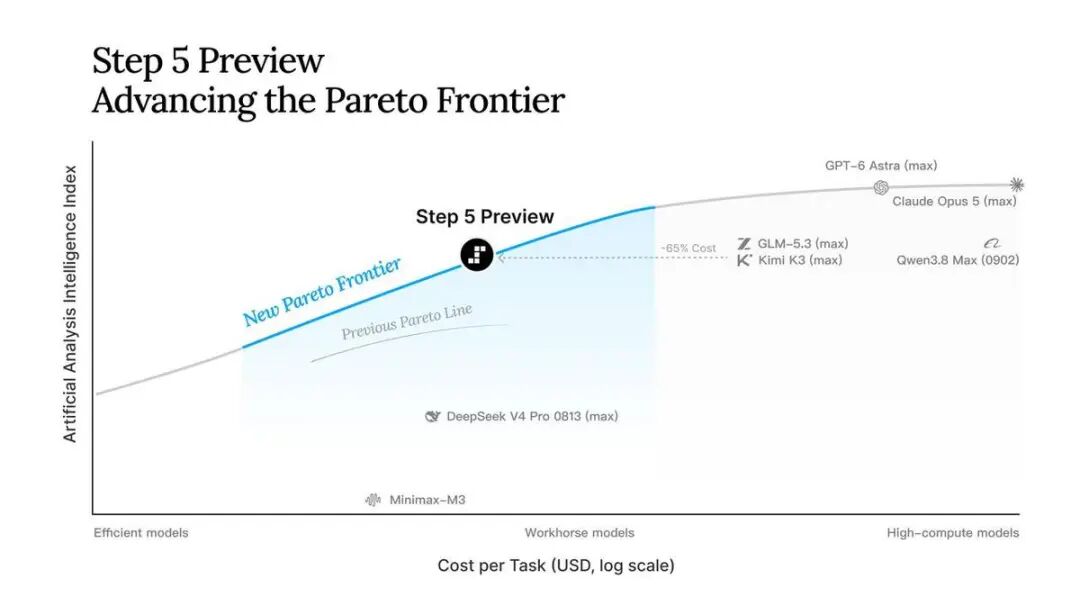
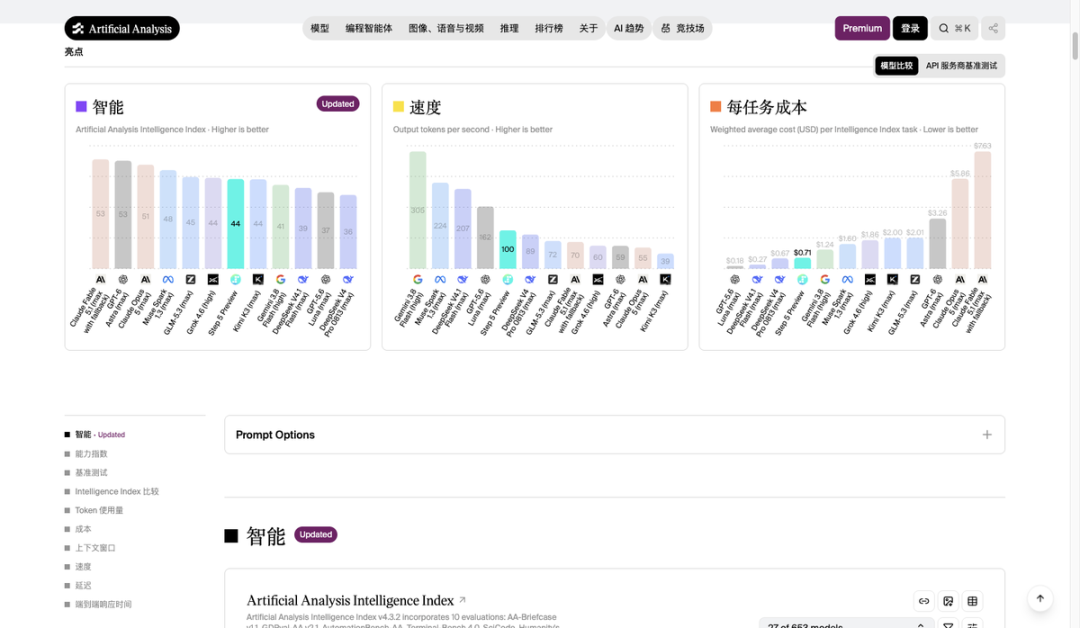
看模型发布报告,它的单任务成本是 GLM-5.3 和 Kimi K3 的 35%、Claude Opus 5 的 12.5%,这个还是很惊艳的。如果同等智能水平的价格真的打到三分之一,很多团队算得过来的账就得重算了。这大概也是“帕累托前沿”这句口号的味道,智能和成本并重。
真实项目中的落地验证
除了这道标准化的工程题,趁着无限 Token,我赶紧用来做点真实项目。
第一个项目:上周有个用户分享了他自己的开源项目,叫 Agent Hud,官网是 https://agenthud.app,可以利用 macOS 的灵动岛非常优雅地展示你的 Agent 使用额度,比如这样:
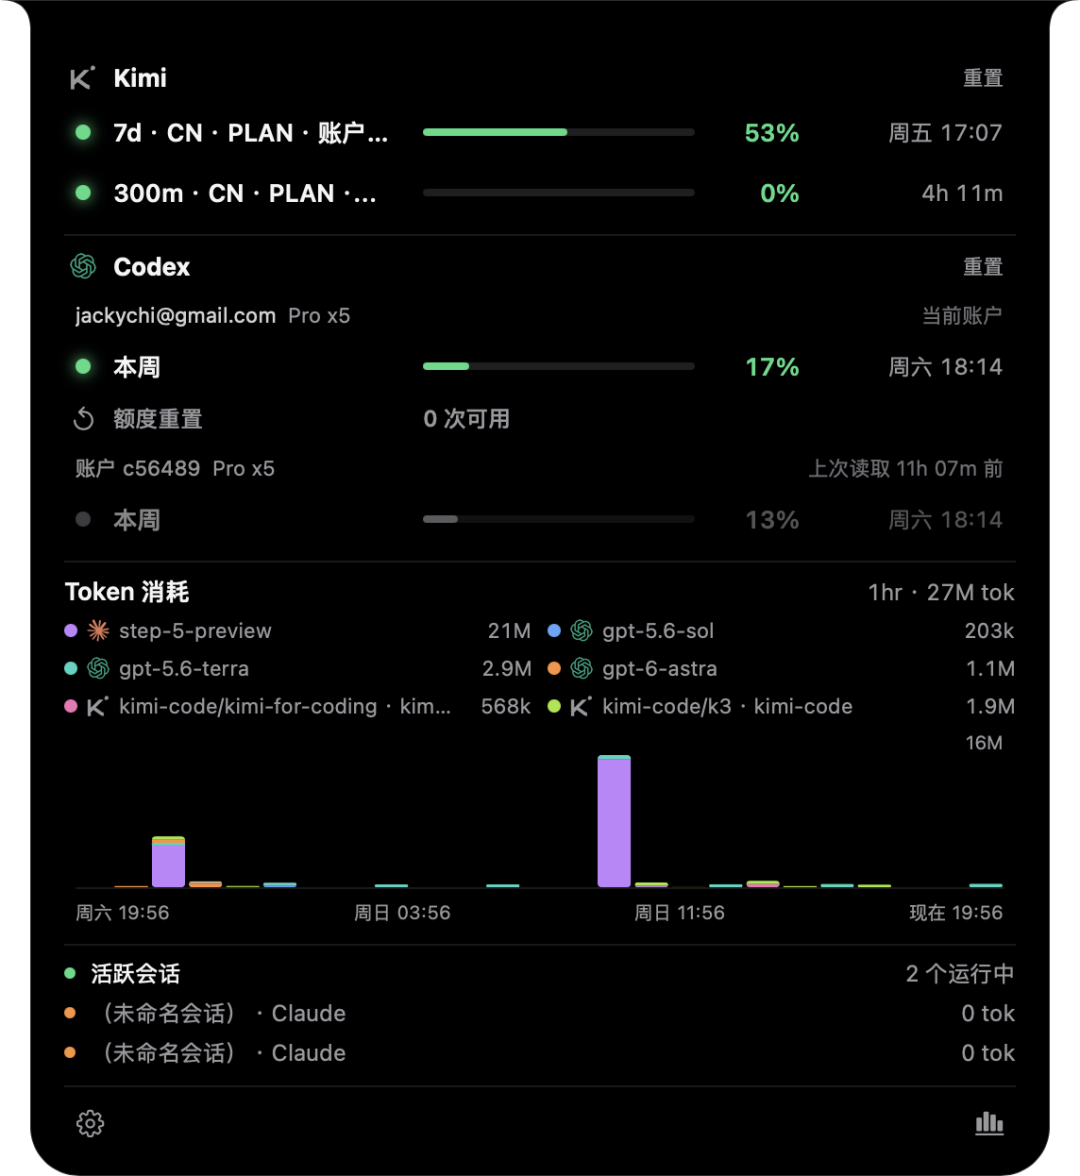
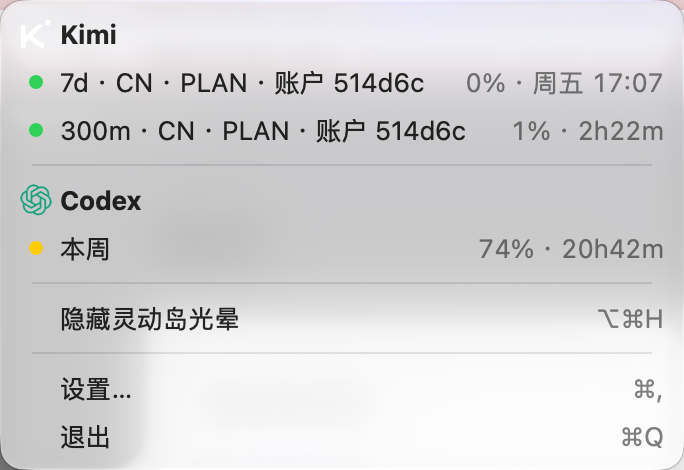
不过这个产品有个问题,就是刘海屏的 MacBook 接了外屏之后,它还会给你的大外屏上强制画一个刘海,还有个问题:不知道为什么,下拉菜单里没有退出选项,用着很不方便。既然是开源,那咱们就自己动手,丰衣足食。
我直接 Clone 了这个项目,让 Step 5 Preview 按照我的理解开始修改:
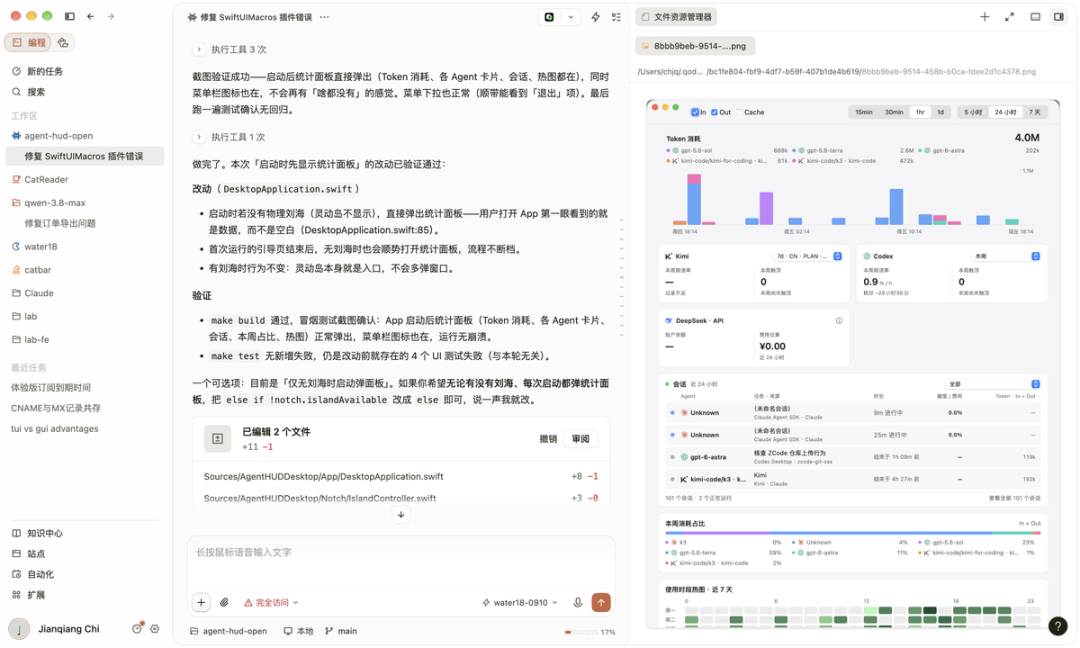
几轮交互之后,在非刘海的外屏上,它会只显示菜单项加退出,只在笔记本显示屏上才会有灵动岛的交互,这个任务完成得又快又漂亮。
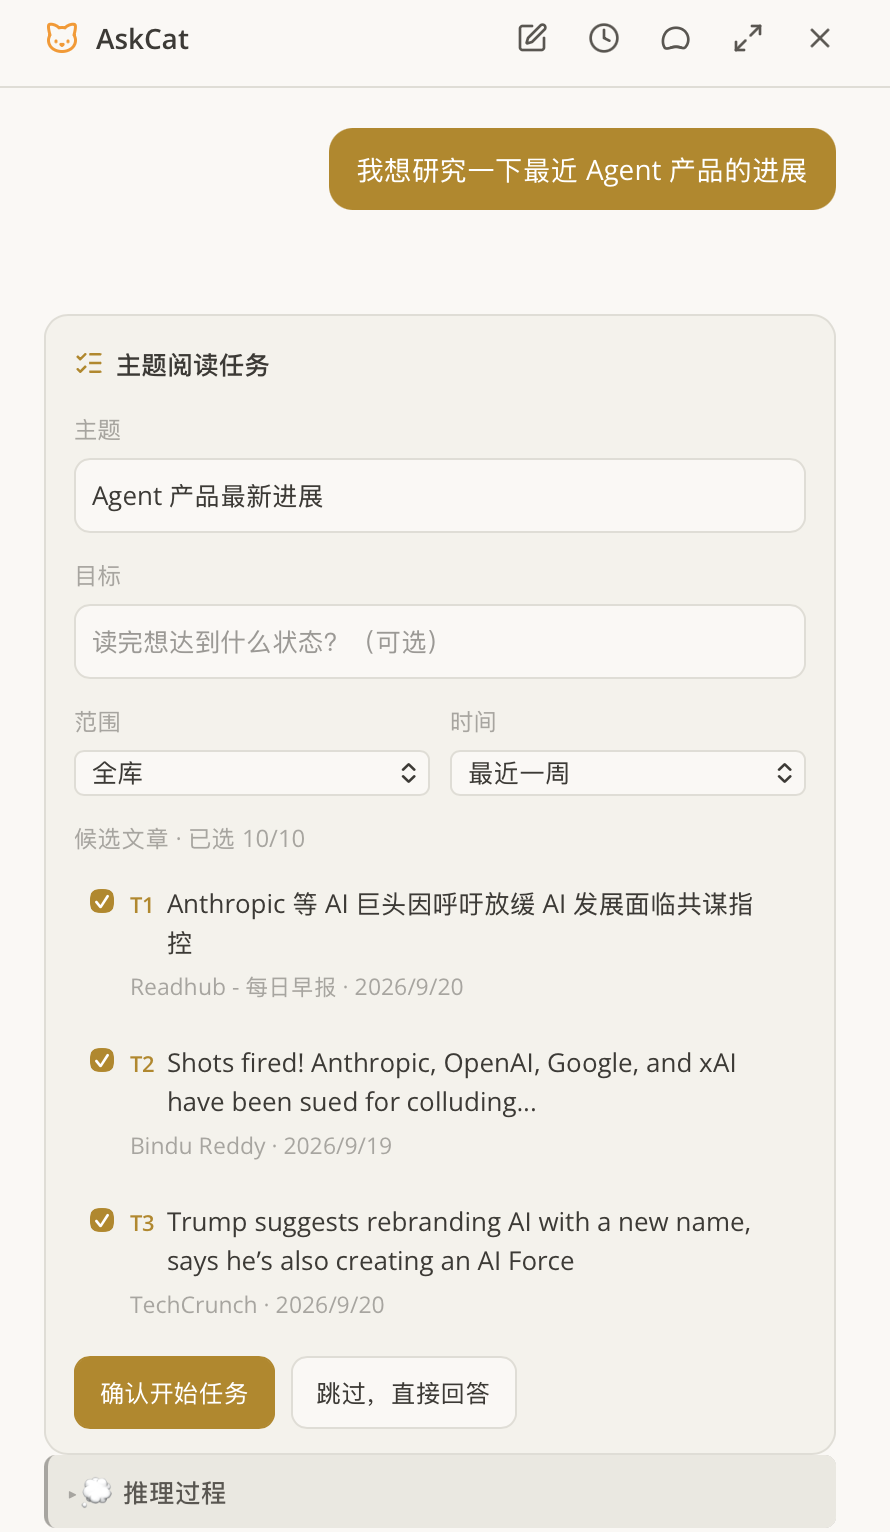
第二个项目,是墨问的 CatReader。我之前做了一次产品计划,为用户提供更主动的阅读 Agent,第一步是提供主题阅读任务,当用户在 AskCat 里选中主题阅读卡之后,说“我想研究一下最近 Agent 产品的进展”,CatReader 会弹出一个任务卡,帮助你选择合适的文章进行主题阅读,期间可以批量收藏文章,做深度研究,并保存成墨问笔记等等。
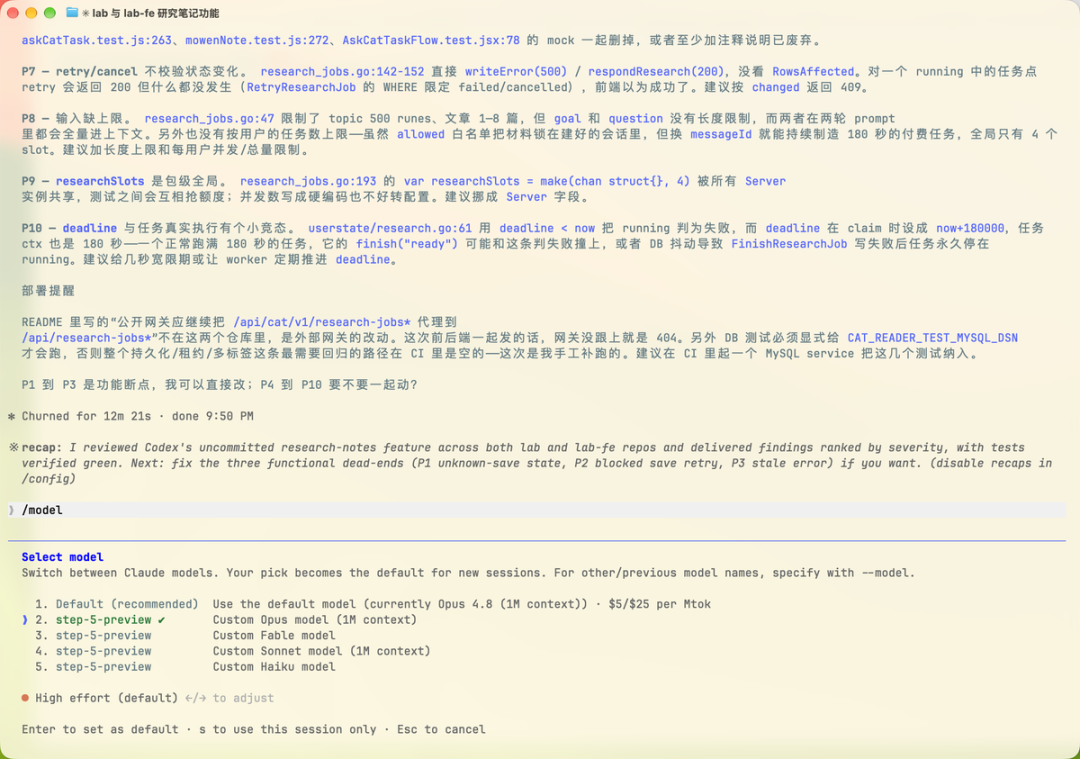
这个项目我选择了让 Codex + Astra 和 CC + Step 5 Preview 交叉设计、实现和 review,整体效果相当不错,比如 Step 5 Preview 会对 Astra 的实现给出自己的看法:
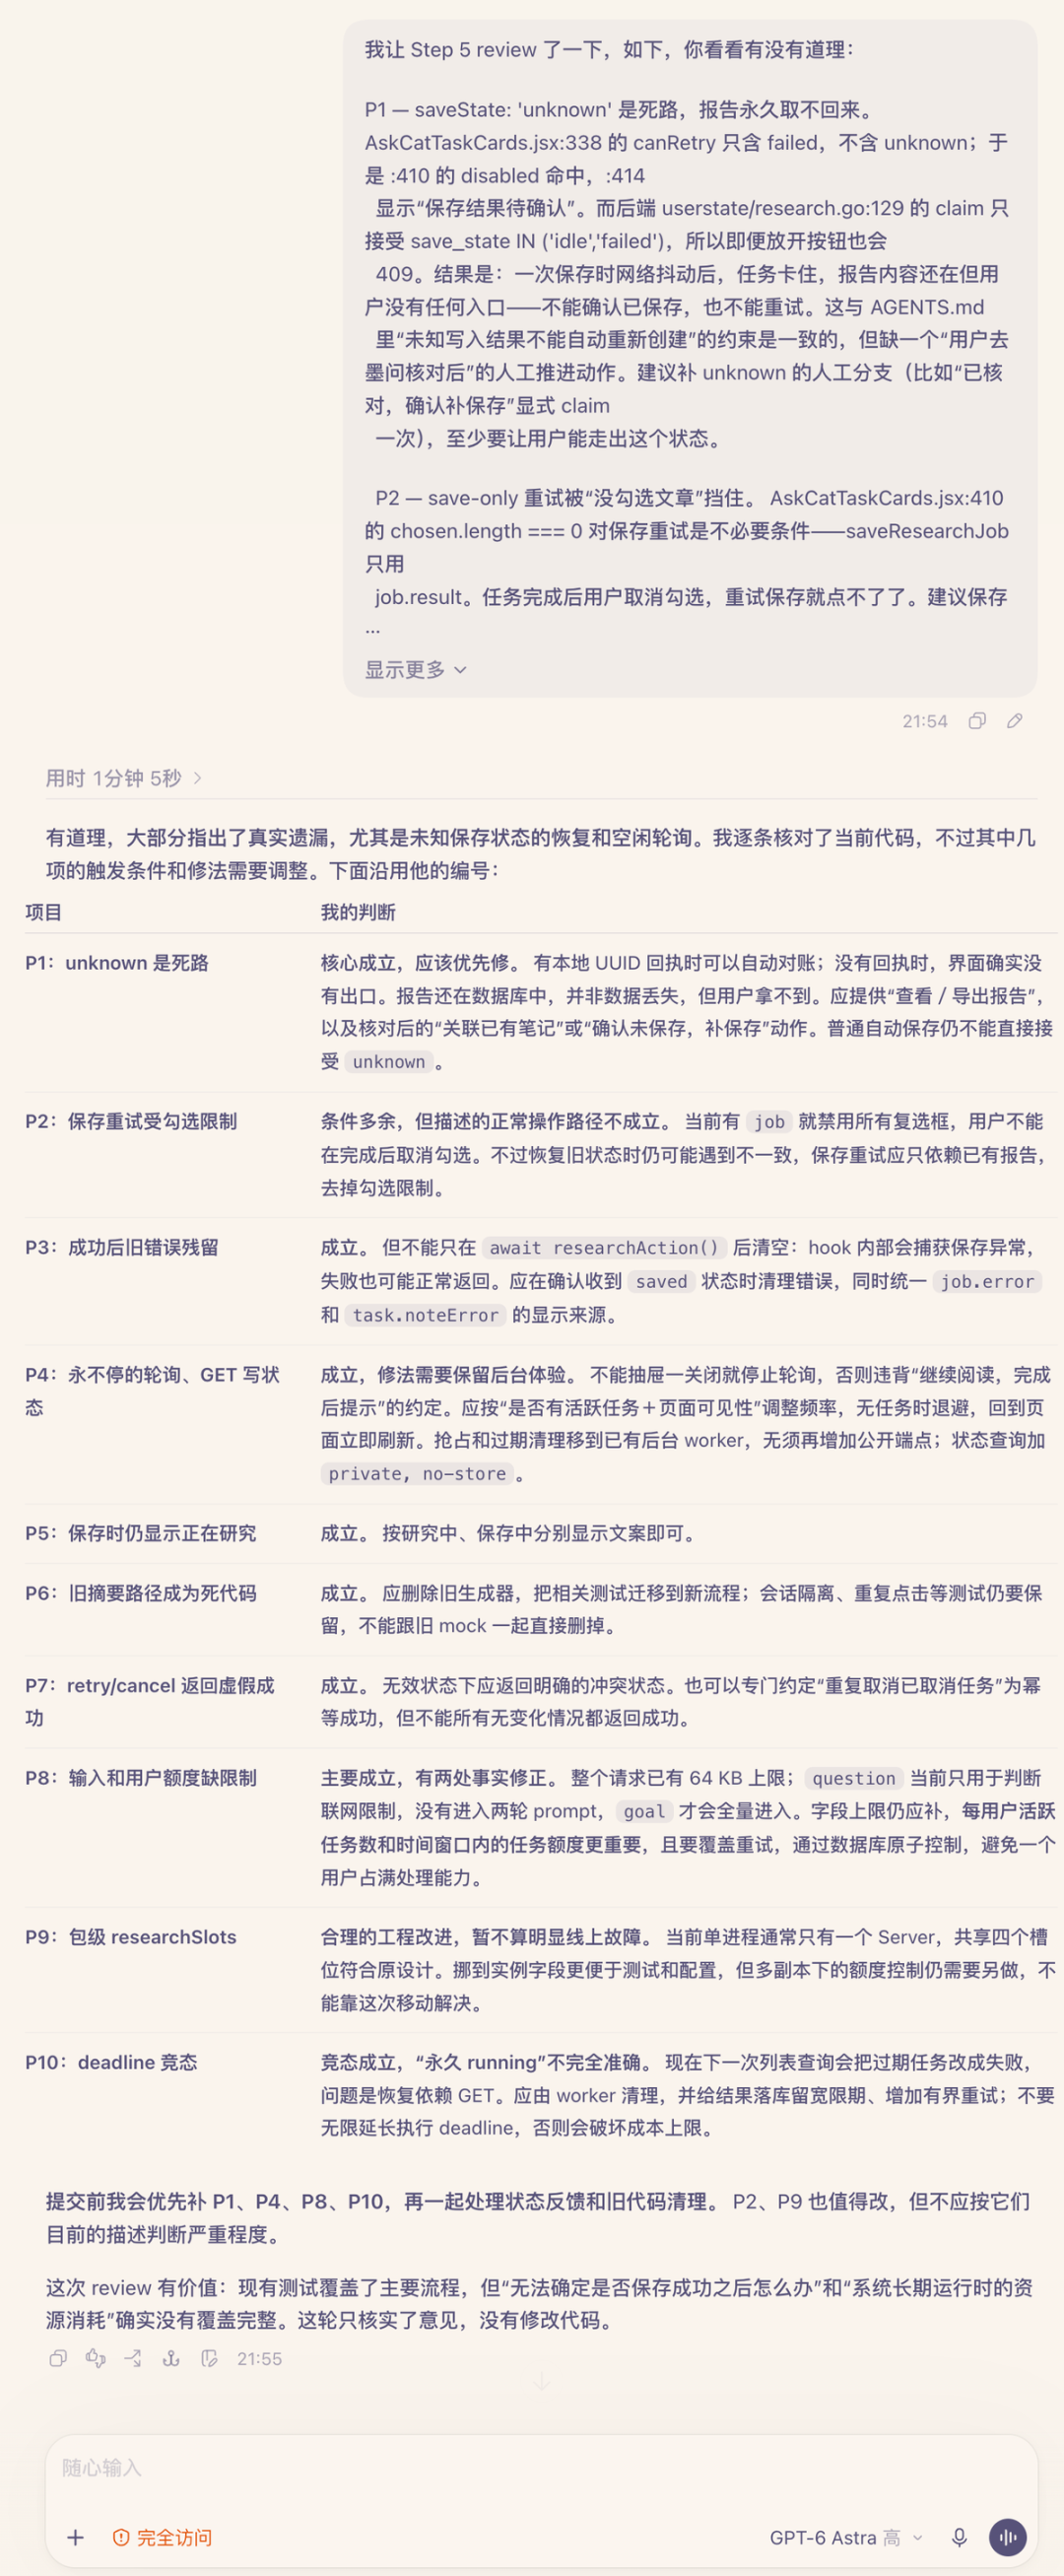
Astra 的反馈如下,并且根据 Step 5 Preview 的部分意见进行了修复:
周末搞了两天,两个高手配合,Step 5 Preview 主实现,Astra 主审核,这个功能我已经发到测试环境了:
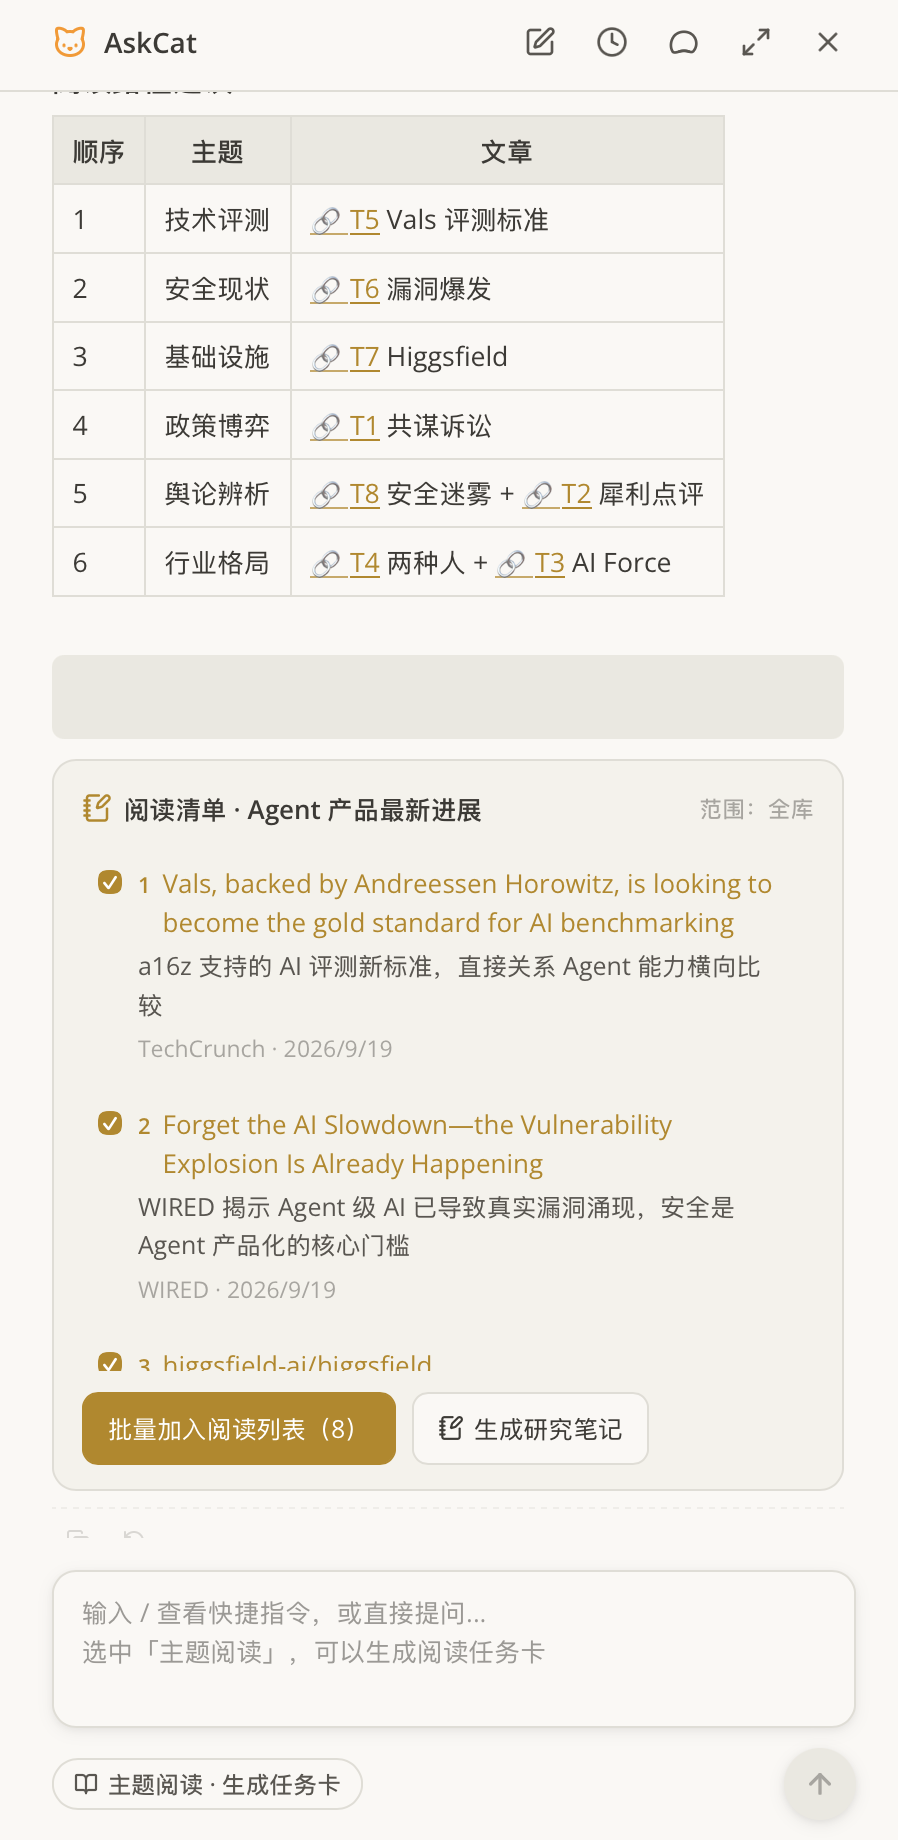
用户点击确认开始任务,AskCat 就会帮你筛选文章,加收藏,做研究,还能直接把研究成果保存到墨问里:
目前这个功能还有些小 bug,预计本周再修修就可以上线了。这个阅读 Agent,是我这次基模内测的一个附加收获,乌拉。另外,模型测试过程里我遇到的一些中断,安全护栏提示不合理等问题,都直接反馈给模型厂商,很快得到了处理和修复,非常开心。
权威榜单与综合能力验证
今天阶跃星辰的这款旗舰模型已经正式发布了,我们看看官方榜单的数据,比我专业:
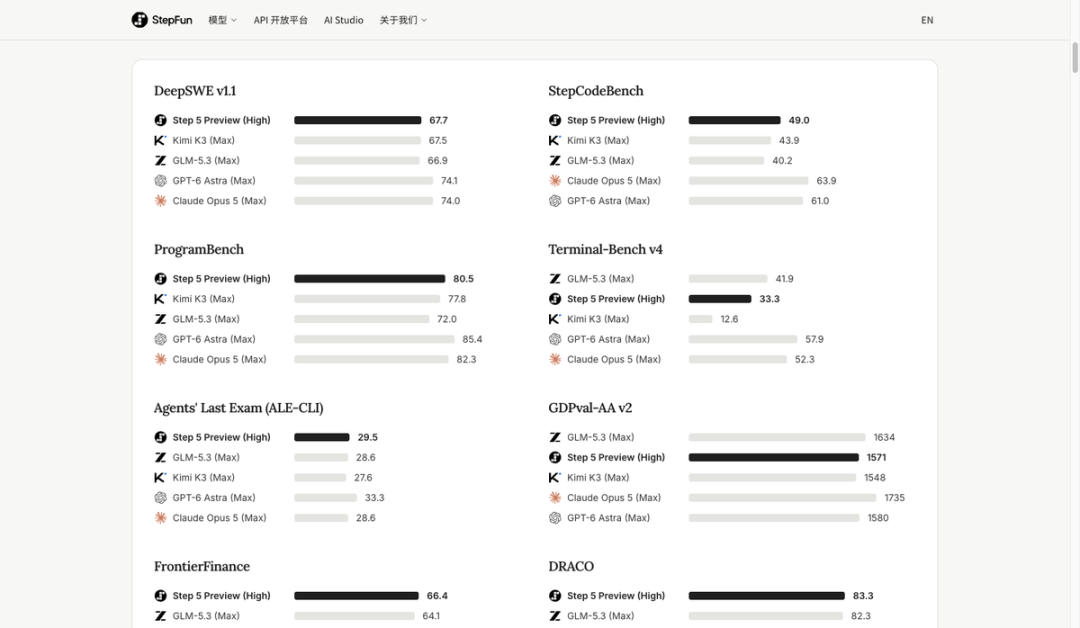
Coding 方向上,DeepSWE v1.1 拿到 67.7%,与 Kimi K3 的 67.5%、GLM-5.3 的 66.9% 相近;自研的 StepCodeBench(覆盖 553 个真实代码仓库、33 种编程语言)拿到 49.0%。
长程任务:在一张 H100 上连续 24 小时从零优化 MLA GPU Kernel,最终跑到 508 TFLOPS;还有个彩蛋,它在没有任何专项优化的情况下连续玩 Pokémon Red 超过 3000 回合,累计交互近 600 万 tokens。金融方向的外部评测 FrontierFinance 上拿到 66.4,仅次于 Claude Opus 5。另外值得一提:这款模型将于 10 月 15 日正式开源。
第三方机构 Artificial Analysis 的榜单上,它的 Intelligence Index 是 44(v4.3 口径),单任务成本 0.71 美元。同等智能水平下,它的单任务成本是 GLM-5.3 和 Kimi K3 的 35%,Claude Opus 5 的 12.5%。一句话概括定位:用明显更低的价格,提供 Frontier 级别的能力。
这次内测,除了完成那道工程题,Step 5 Preview 还帮我改好了一个日常使用的工具,把 CatReader 的新功能推进到了测试环节。这样的收获,比跑分和榜单有价值得多。
如果更强的模型能以更低的成本进入日常开发,我们就能把更多时间花在那些一直想做、还没做完的事情上。比如我这个阅读 Agent,再修几个 bug,就能和大家见面了 :)
JOTO 企业落地观察
- 企业部署 AI 编程助手时,需重点评估其对分层架构的理解能力与修复边界的保守性——Step 5 Preview 在 OrderHub 任务中坚持将修复置于数据访问层而非路由层,表明该类模型更适合嵌入已有工程规范严格的团队,降低后续维护风险。
- 在 RAG 知识工程场景中,模型对“验收标准”的字面遵循能力(如十项逐条验证、补全测试用例)比单纯生成代码更重要;企业应将验收清单结构化为 prompt 工程的一部分,而非依赖模型自由发挥。
- 百万级上下文与视觉输入支持,使该模型具备直接解析 PR 描述、截图报错、日志片段等混合信源的能力,为企业构建“问题感知—定位—修复—验证”闭环提供了更紧凑的技术栈选型可能。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们