参与研发 ChatGPT 的人,做了一个不聊天的 AI
TypeSafe AI 推出专用于结构化判断的模型 Jev,由 InstructGPT 论文作者 Diogo Almeida 创立。它不生成文本,仅输出选项、分数或概率,在 27 个业务问题测试中响应速度比 GPT-5.6 快约 75 倍、成本约为其 1/171,但准确率非最高。Jev 定位为嵌入软件的决策组件,适用于工单分派、内容检查等高频小判断任务。
AI 判断任务的新范式
自从 ChatGPT 出现,很多人对 AI 的印象就固定在了一个输入框里:你问,它答。
写文章、改代码、解释问题,这种方式很好用。可软件里的许多任务,根本不需要一篇回答。
一封邮件是否紧急?工单该分给谁?下一步要不要转人工?
程序需要的往往只是一个选项或分数。让通用模型反复处理这些小判断,等待时间和费用就会累积。
开发者已经在用结构化输出、小模型和固定规则解决这些问题。TypeSafe AI 提出了另一种尝试:把模型专门训练成一个做判断的工具。
它叫 Jev,不会写文章,也不陪你聊天。
实际效果:速度与成本优势显著
先看它处理这些小判断的速度。
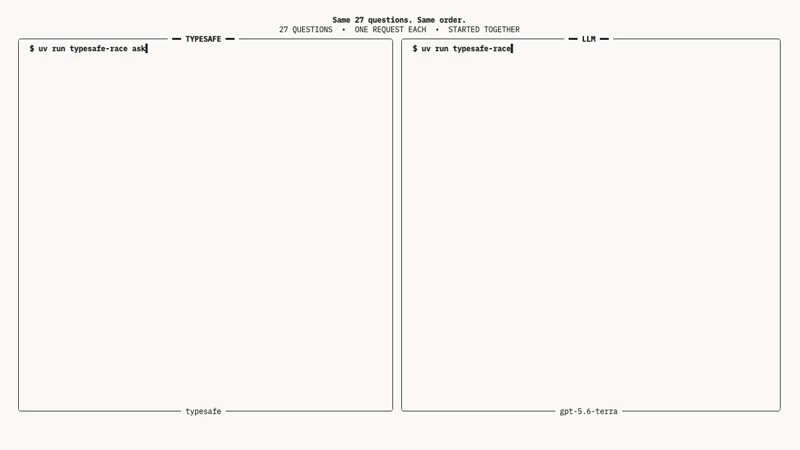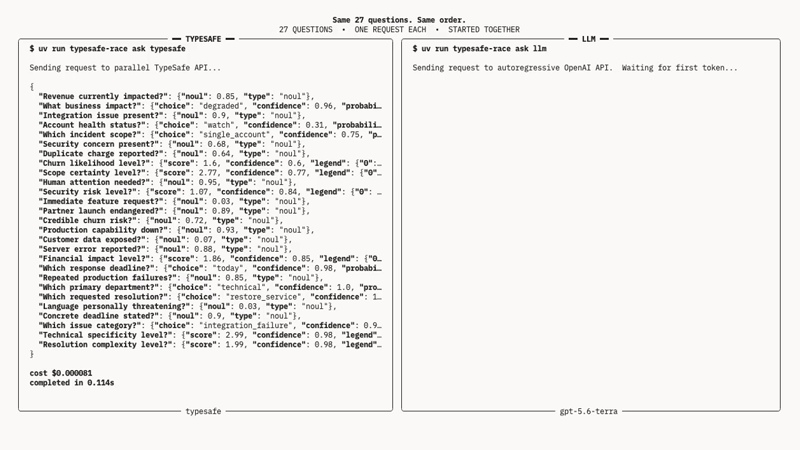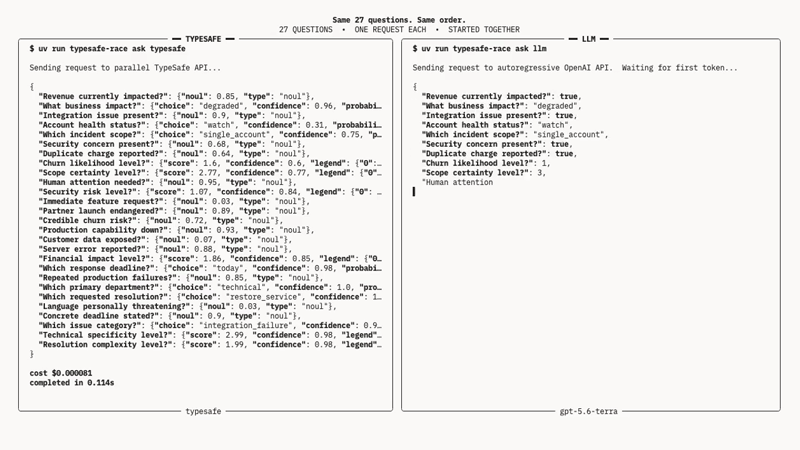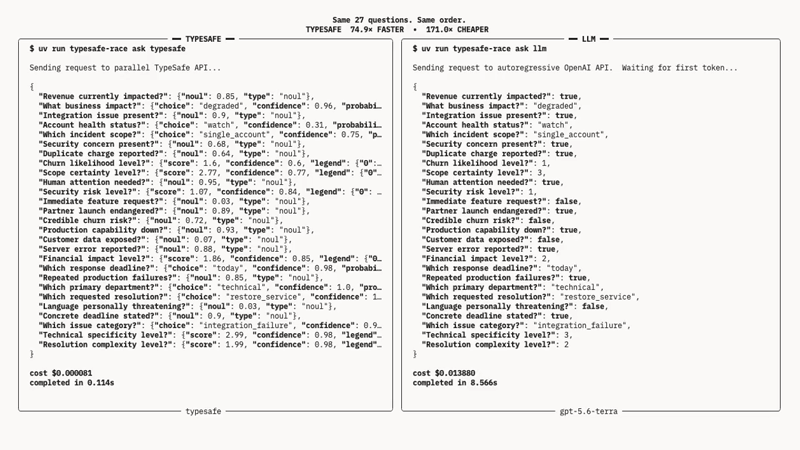
官方把同一组 27 个业务问题交给了 Jev 和 GPT-5.6 Terra。
界面记录的完成时间分别是 0.114 秒和 8.566 秒,费用分别为 0.000081 美元和 0.013880 美元。
这一次演示中,Jev 约快 75 倍,成本约为对方的 1/171。
外部测试也显示了类似取舍。
Every 用 12 段合成文字测试写作问题识别,Jev 比高推理设置的 Claude Fable 5.1 快约 25 倍,估算成本约为其 1/580;但 7 个预设问题只找到了 6 个,对方则全部找到。
样本很小,速度优势和漏检都值得保留。
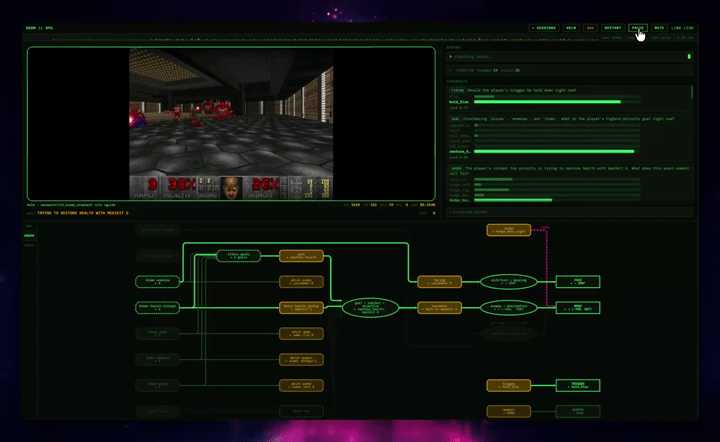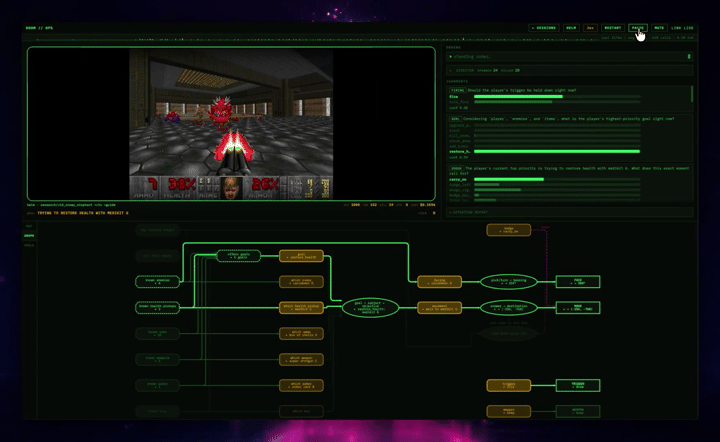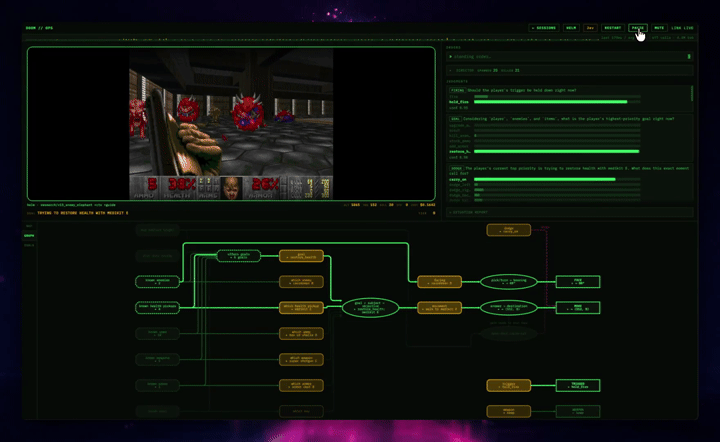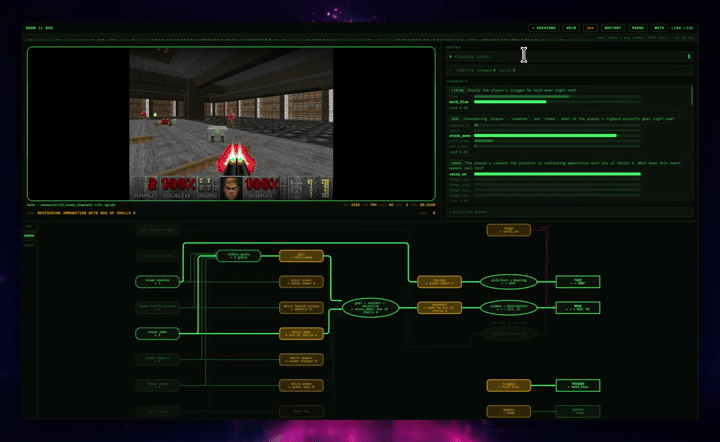
当判断需要连续发生时,响应速度就更重要了。官方用 Doom 和维基百科跳转演示了这种用途:其中 Doom 输入的是整理后的文字状态,并非直接看画面。
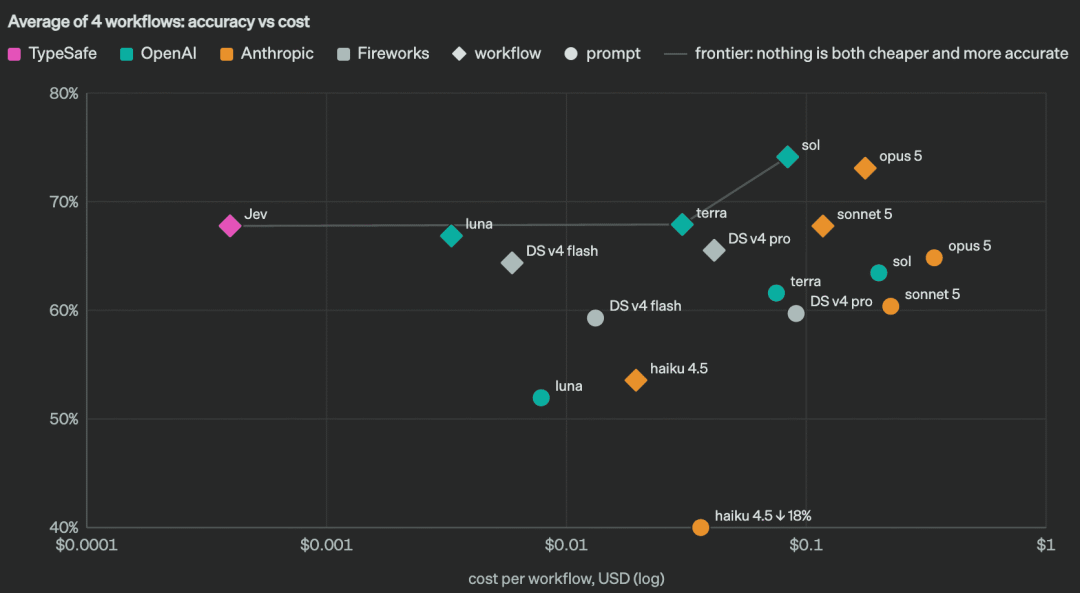
不过,响应快还得看判断准不准。官方的成本—准确率图把两者放在一起:越靠左越便宜,越靠上准确率越高。Jev 位于最左侧,但准确率并非最高。
这里比较的是 4 个自建工作流的平均结果,参考答案来自其他强模型的预测,不能当成通用能力排名。
Jev 是什么,能做什么?
这些演示有个共同点:每一步都只需要一个判断结果。
TypeSafe AI 把专门处理这类任务的 Jev 称为决策模型。
创始人 Diogo Almeida 在 OpenAI 参与了 RLHF(基于人类反馈的强化学习)和 InstructGPT 的基础研究,研究如何让模型更好地遵循人的指令。
他是 InstructGPT 论文作者之一,也参与了 GPT-4 的指令遵循和 API 评测。
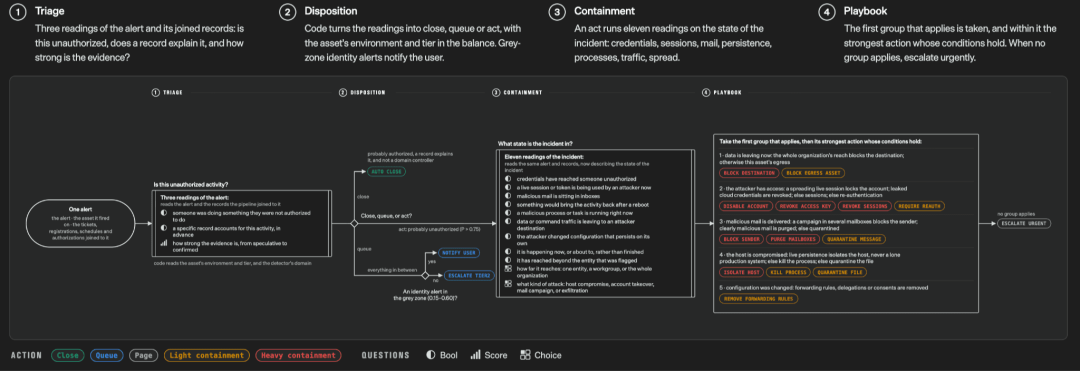
在 Jev 里,这类判断被做成了三种基本能力:从给定选项中选择(Choice)、按标准打分(Score),以及对一个陈述返回 0 到 1 的判断值(Noul)。
多个问题可以同时评估,结果直接交给软件使用。
官方文档举了一个例子:客户说 Stripe 账户连接失败已经三天,正在影响销售。
Jev 可以同时判断该分给哪个部门、客户有多不满、事情是否紧急。
程序拿到结果后,按规则分派工单;如果需要写回复,再交给能生成文字的模型。
安全告警、内容检查、邮件筛选,也可以这样拆成一连串小判断。下面这张官方示意图里,Jev 负责判断,代码负责把结果接到关闭、排队、通知等动作上。
与聊天模型的本质区别
分派工单、筛选内容,聊天模型也能做。要看 Jev 的不同,得比较底层模型的输出方式:ChatGPT 是完整的助手产品,Jev 则是供软件调用的模型。
| 对比项 | 聊天模型 | Jev |
|---|---|---|
| 输出 | 文字、代码,也能输出结构化结果 | 预设选项、分数和概率 |
| 适合任务 | 写作、解释、开放式问答 | 分类、评分、流程中的小判断 |
| 使用方式 | 对话或通过 API 调用 | 作为判断环节接入软件 |
Jev 不生成自由文本,也不会展开解释为什么选了这个答案。
所以,区别不在于“能不能返回 JSON”,而在于专门做判断后,能否更快、更便宜,同时保持足够的准确率。
它还有一个明确的边界:选项只有 A、B、C,就不会凭空输出 D。但它仍可能把本该选 A 的题选成 B。
官方所说的类型安全,保证的是输出符合结构,不能理解成“零判断错误”。
TypeSafe 还强调概率校准:大量被赋予 80% 概率的事件,实际发生比例应接近 80%。
这是训练目标;返回一个精确到小数的数字,本身并不能证明判断可靠。是否适合自己的任务,还得拿实际材料检验。
接入方式与当前可用性
现在 Jev 仍处于 Early Access,官网有候补名单入口,也提供 Playground 和 API 接入文档。
Playground 需要登录,新账号是否立即获得权限,本文尚未验证。
拿到权限后,就可以先在 Playground 里输入一段业务材料,设定要判断的问题和选项;确认效果后,再通过 API 或 SDK 接进自己的软件。
比如内容团队可以先准备一批人工标注过的中文稿,让它检查“这段是否重复前文且没有新增信息”。
先看漏检和误报,再决定哪些结果自动处理、哪些交给编辑复核。问题越具体,越容易检验它到底有没有用。
官方当前标价是每百万输入 Token 0.042 美元,输出不收费。它是收费服务,“输出免费”也不代表整个请求免费。
适用场景与现实取舍
这样的价格,在任务反复发生时才更有吸引力。Jev 值得关注的用处也在这里:频繁地分流、检查,或选择下一步动作。
如果它能在自己的业务数据上保持可接受的错误率,速度和成本优势才会真正兑现。
对多数人来说,聊天模型仍然更通用。
但很显然聊天不是唯一的场景,很多行业内部的流程、系统、软件每天都有无数次的各种判断。
Jev 的机会,或许就在那里。
JOTO 企业落地观察
- 企业部署决策模型需重新评估「端到端延迟」构成:传统依赖大模型生成+解析的链路,正被 Jev 类型的轻量判断组件替代,这对实时性敏感系统(如客服路由、风控拦截)意味着架构级优化空间。
- 智能体工程中「判断-执行」解耦成为新实践:Jev 不输出解释、只返回结构化结果,倒逼团队将「可信度验证」「兜底策略」「人工复核触发」显式设计为独立模块,而非隐含在提示词中。
- RAG 知识工程面临新分工:当判断类任务从 LLM 卸载至专用模型,RAG 系统可聚焦于高质量上下文供给与语义召回,不再被迫承担低价值分类任务,知识库构建目标更清晰。
- AI 安全治理需覆盖新型输出边界:Jev 的「类型安全」不等于逻辑安全——它能确保输出在 A/B/C 内,但无法防止因训练数据偏差导致的系统性误判,企业需建立针对决策模型的专项偏见审计机制。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们