斯坦福与英伟达推出CLM-8B:专为智能体有界决策设计的对比式语言模型
CLM-8B通过双编码器架构将状态与动作映射至共享嵌入空间,支持缓存复用、零样本决策与低延迟路由,在工具调用等任务中提速最高达9倍,但部分任务准确性略低于Jev。
AI智能体通常利用大语言模型(LLM)在一组固定的工具之间进行选择,或对候选输出进行排序。在每种情况下,模型均需处理提示词并生成词元(tokens),尽管应用程序实际仅需要一个有界决策(bounded decision)。
来自斯坦福大学和英伟达(Nvidia)的研究人员已发布 对比语言模型(Contrastive Language Models) (CLM),这是一种专为上述类型决策而设计的新方法。与生成词元序列不同,其CLM-8B模型会分别创建当前状态和可用动作的表征,然后选择与该状态最匹配的动作。
这种设计在智能体于工作流中反复做出同类决策的应用场景中尤为有用。CLM可缓存可复用的动作表征,从而避免每次请求都重新计算这些表征。
在团队针对计算机使用、游戏和工具调用任务开展的零样本(zero-shot)测试中,CLM-8B的运行速度最高可达TypeSafe公司Jev模型的9倍,并在两项游戏任务中与其成功率持平。但在其余两项任务中,CLM牺牲了一定准确性:在BFCL v4工具调用基准测试中,其得分为95.2%,低于Jev的99.2%;在WikiRacing任务中,CLM完成了30项中的26项,而Jev完成了全部30项。最大的加速效果出现在模型能在多种状态间复用动作,或需从大量候选动作中进行选择的情形下。
CLM的发布恰逢业界对 TypeSafe所称的“系统一”(System One)模型兴趣日益增长之际, 这一类别由TypeSafe于本月早些时候随Jev一同提出。CLM为这一新兴技术栈增添了一种对比式方法。
CLM如何将决策转化为匹配问题
CLM由状态(state)组件和动作(action)组件构成。状态指模型当前对某项任务所掌握的信息;动作则指可供选择的选项。CLM学习构建一个共享的 嵌入空间(embedding space) ,用于表征这些状态和动作。在训练过程中,它使正确配对的状态与动作在嵌入空间中彼此靠近,同时将错误配对推得更远。
在推理阶段,模型无需逐词元地生成动作名称。它先对当前状态进行编码,再将该表征与候选动作的表征进行比对,最终选取最接近的匹配项。
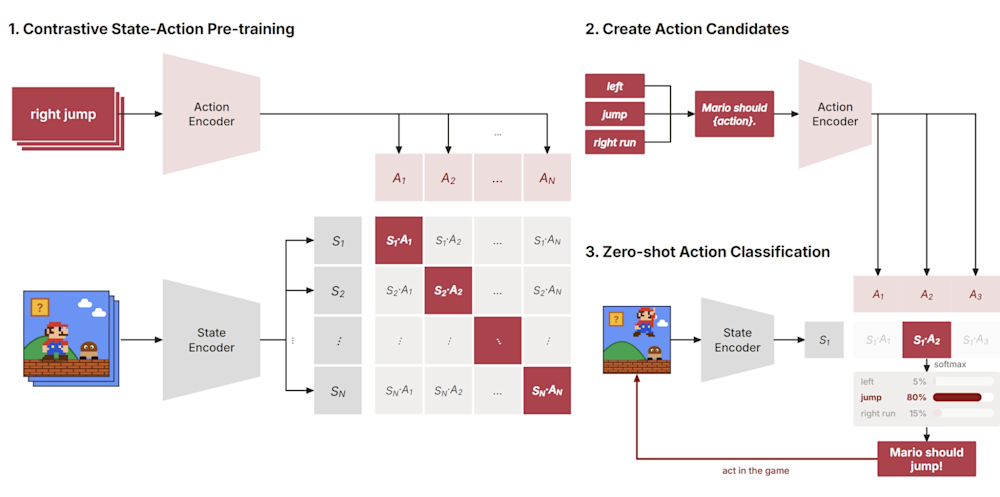
CLM架构(来源:CLM团队)
研究人员采用一种名为InfoNCE的对比训练方法实现该设计。InfoNCE通过向模型提供一个正确的状态-动作配对及若干错误配对进行训练,并奖励模型为正确配对赋予最高相似度得分。
研究人员分三个阶段训练CLM:首先使用约6000万个问答对,以教授广泛的语义匹配能力;随后加入约3000万个合成“困难负样本”(hard negatives),例如多项选择题,其中各选项在语义上高度相似,但仅有一个正确答案;最后,在约100万条智能体轨迹(agent trajectories)上进行后训练,以使模型适配智能体决策任务。
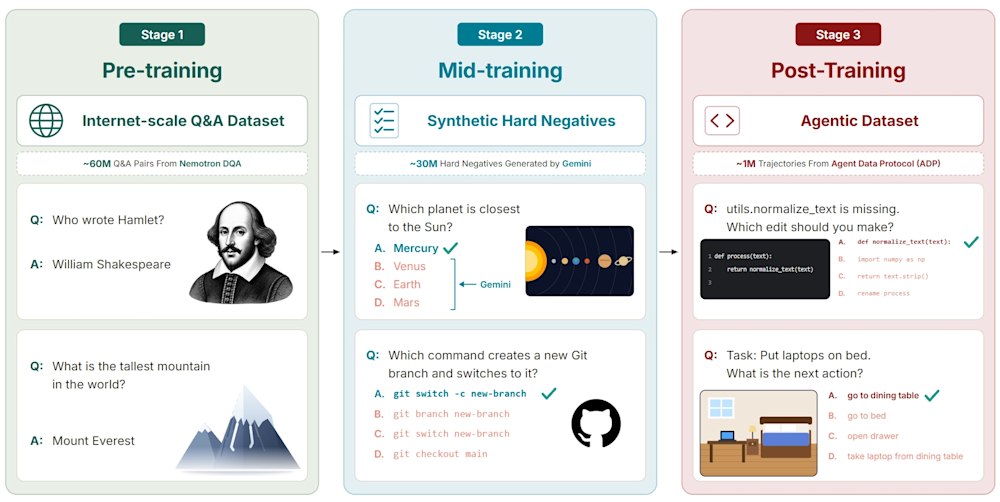
CLM训练流程(来源:CLM团队)
发布的CLM-8B采用冻结的Qwen3-8B骨干网络(backbone),并为状态和动作分别配备独立的投影头(projection heads)。这种分离支持部署优化:若某一应用需反复在相同动作集中进行选择,CLM可一次性对这些动作进行编码并缓存其嵌入向量;此后每个新请求仅需对变化的状态进行编码,并将其与缓存的动作嵌入向量进行比对。
例如,一家企业可能希望将CLM用于内部IT智能体,该智能体拥有50个经批准的动作,如重置密码、配置访问权限、提交工单或升级至安全团队。CLM无需像生成式提示词那样反复处理全部50个选项,而是可预先准备好这些动作的表征,并针对每种新情况对其逐一评分。
CLM在企业级AI技术栈中的定位
发布的模型支持多种有界决策模式:在选项间进行选择、返回是/否概率、按有序量表打分,以及对任意候选集进行排序。这使得CLM适用于工具路由(tool routing)、工单分类(ticket triage)、检索初筛(retrieval shortlisting)以及在多个提议输出间进行选择等任务。
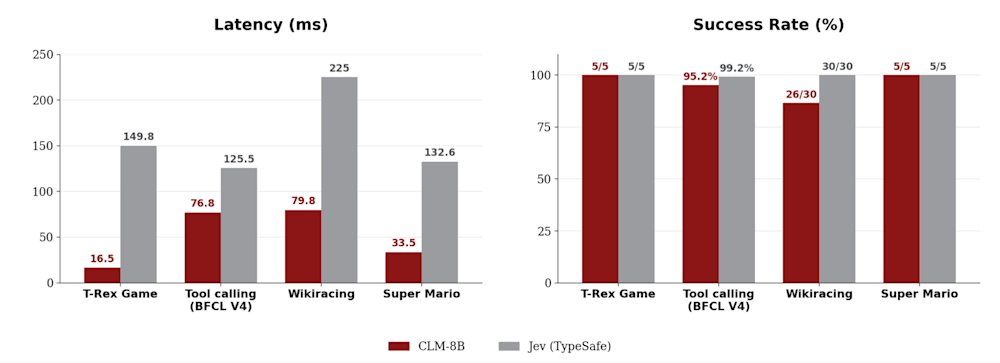
CLM在决策任务上的性能表现(来源:CLM团队)
生成式模型目前已能被约束为仅从固定工具集或输出集中进行选择。结构化输出(structured-output)和函数调用(function-calling)API已大幅提升了此类响应的可靠性,但本质上仍是将生成式模型约束为模拟决策系统的行为。而CLM则直接从决策问题本身出发:给定一个状态和一组固定动作,对可用动作进行排序并从中择一。
这也可能改变多模型系统的经济性。将请求路由至生成式大语言模型需模型处理提示词并生成答案,即使所需输出仅为单一工具的名称。CLM则避免了自回归式(autoregressive)输出生成过程。
研究人员未提供与前沿API服务的“同质同量”(apples-to-apples)美元成本对比,因此此次发布并未确立具体的托管成本降低幅度。CLM-8B仍运行一个参数量为80亿的编码器。但其推理模式消除了生成式模型在执行有界决策时所需的计算开销。
CLM的一项重要优势在于降低多步骤智能体任务的延迟。单次路由调用的延迟或许微不足道,但当智能体在返回答案前需执行数十次路由、排序和校验决策时,这些延迟便会累积叠加。
另一项优势在于,将CLM适配至特定任务无需对整个80亿参数模型进行微调。Qwen3-8B骨干网络保持冻结状态,开发者仅需训练规模小得多的状态和动作投影头。
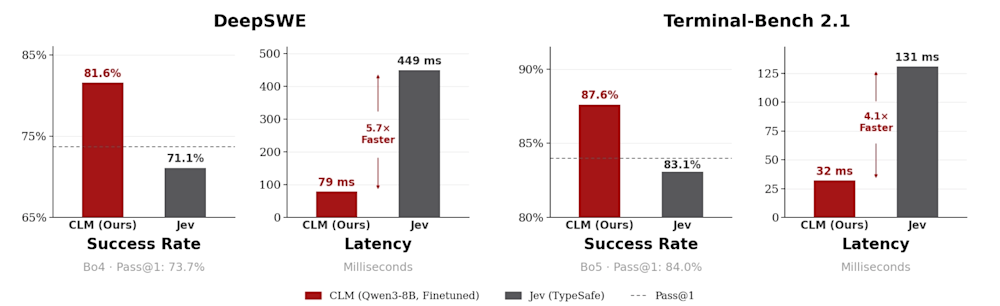
CLM在代码验证任务上的表现(来源:CLM团队)
在接受VentureBeat采访时,项目负责人 杰基·郭(Jacky Kwok) (斯坦福大学)表示,对比式训练目标在面向特定领域的决策任务中亦具优势。“我们发现,相较于使用交叉熵损失(cross-entropy loss)的标准监督式微调(SFT),对比式目标在决策任务中尤为有效,”他指出,“我们还发现,从预训练的CLM检查点(checkpoint)初始化模型,可使其快速适配下游任务及特定领域任务。”
例如,客服智能体可能需决定是否退款、升级至人工客服、索要更多信息,抑或关闭工单。借助CLM的对比式目标,模型被训练为拉近正确状态-动作配对的距离,同时将竞争性动作推得更远。
研究团队通过将CLM微调为代码任务验证器来测试该方法。在团队的代码实验中,大型模型首先生成多个候选解决方案:Opus 5为DeepSWE生成候选方案,Fable为Terminal-Bench 2.1生成5个候选方案;随后,经微调的CLM对这些候选方案进行排序,并选出一个提交。
在保留测试子集上,研究人员报告称,CLM在38个DeepSWE任务中达到81.6%的准确率,在30个Terminal-Bench 2.1任务中达到87.6%的准确率,而Jev在相同子集上的准确率分别为71.1%和83.1%。他们报告称,CLM验证器的延迟比Jev低4.1–5.7倍。需要特别注意的是,CLM并非从零开始解决DeepSWE任务——大型模型负责生成候选方案,CLM仅负责从中择一。
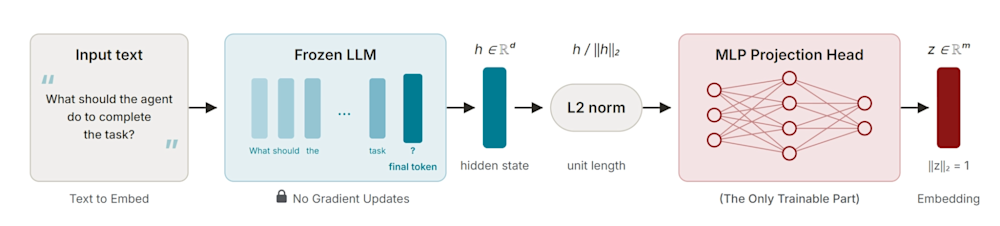
CLM 使用一个冻结的 LLM 主干网络和一个可训练的投影头组件(来源:CLM 团队)
郭(Kwok)如此描述更广泛的分工:“使用大型推理模型来生成和推理,而使用 CLM 以低成本选择、验证和监控其输出。”
一种可能的配置是:由多个成本效益高的开源模型生成候选响应或动作,再使用 CLM 快速对它们进行排序并选出最佳选项。郭认为,对于大多数决策而言,这种做法比依赖前沿模型更具成本效益。
CLM 还可作为智能体(agents)的监控层。郭表示,该团队经常观察到成功轨迹与失败轨迹在 CLM 得分上存在明显区分。“CLM 可持续对智能体生成的动作或轨迹进行打分,并标记出异常或潜在失败的行为,”他说。这可为企业系统提供另一信号,用于检测长期运行的智能体是否偏离正轨,但不应将其视为有保障的安全机制。
它还界定了“验证器”(verifier)一词的含义。CLM 仅对其接收到的候选方案进行打分,且其输出的概率值仅相对于该候选集合而言。如果所有提议的动作均错误,模型仍须对它们进行排序。
也存在一些任务场景,CLM 根本不是合适的工具。“我不会在需要大量开放式推理的任务中用 CLM 替代通用推理模型,例如解数学题、生成长篇幅响应或执行高层级规划,”郭表示。CLM 更适用于已有明确可选方案、模型只需从中选择、排序或验证的场景。
开发者今日即可测试该模式。该团队发布了 CLM-8B 权重 ,采用 Apache 2.0 许可证,并同步开源了代码、TypeSafe 兼容的 API、微调工具,以及一个用于交互式测试状态、类型化问题及候选方案排序的 Playground。
CLM 与其他决策模型的区别
CLM 是近期围绕“System One”理念发布的一系列项目之一。TypeSafe 于 9 月 15 日推出 Jev,作为一款面向快速结构化决策的模型,并采用其称为 面向校准决策的强化学习(Reinforcement Learning for Calibrated Decisions)的方法进行训练。Laya 则采取不同路径,基于 更小的双向编码器(smaller bidirectional encoders)。CUA-S1 的适用范围则更窄,其首个模型专注于为 表单填写任务(form-filling tasks)选择受限动作。
但它们在实现该决策层的方式上存在差异。“CLM 与 Jev 或 Laya 等模型的关键区别在于架构,”郭表示。据郭介绍,Jev 和 Laya 主要支持缓存状态表征,而 CLM 的双编码器架构使其能够独立计算并缓存状态嵌入与动作嵌入。
当上下文与候选动作均较长时,该架构差异变得更为重要。CLM 可分别对两侧进行编码,并批量处理其计算。当可能的动作已被预先定义(例如某公司的工具、API 或工作流)时,其表征可提前计算并在各次请求间复用。正如郭所言:“CLM 尤其适用于上下文长 / 动作空间可复用的应用场景。”
该项目亦正超越当前的 80 亿参数模型。郭表示,CLM-8B 是该团队用于研究性能随模型规模变化规律的“扩展阶梯”(scaling ladder)的一部分。他表示,目前正训练一个具备更多数据与算力支持的多模态 CLM-35B-A3B 模型,计划于 10 月初发布。该团队还在大幅增加智能体(agentic)训练数据量。
“我们还正使用大幅增加的智能体数据对其进行后训练,目标是使其更适配现有框架与工作流的集成,”郭表示。
JOTO 企业落地观察
- 对企业部署而言,CLM-8B冻结Qwen3-8B主干+可训练轻量投影头的设计,显著降低微调成本与算力门槛;企业IT智能体等固定动作集场景下,动作嵌入可一次性预计算并跨请求复用,减少重复推理开销。
- 对智能体工程而言,CLM将‘路由/排序/验证’从生成式LLM中解耦,形成可插拔的决策层——多个低成本开源模型生成候选动作后,由CLM快速打分择优,提升多步智能体任务的整体吞吐与可控性。
- 对FDE落地而言,CLM作为监控层可对智能体轨迹持续打分并识别异常行为,提供运行时可观测信号;但其验证结果仅相对候选集有效,不保证绝对正确性,故需与人工审核或冗余校验机制协同使用。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们