单任务的上限取决于模型能力,多任务的上限取决于人的注意力。这是 Coding Agent 使用场景中的典型问题。我们已经能把复杂任务交给 Agent 独立完成。但如果同时推进好几件事,仍然需要自己盯着不同的 Session:哪个完成了,哪个在等反馈,哪个失败后需要重新告诉它「继续」。DeepSeek 团队提到,根据他们的经验,一个人通常只能同时跟进 3~5 个活跃 Session。Agent 已经能独立执行任务,但让这些工作持续推进,仍然要靠人协调。这次他们提出的 Super-agent,就是在尝试改变这种分工。它的设置就是有点像一个一直存续的PMO。更有意思的是,一向坚持极简 Harness 的 Pi 作者 Mario Zechner 公开推荐了这套设计。他还提到,Earendil 也在朝类似方向发展:一个长期存在的主体,按需委派任务,并能接收不同系统的事件。几天后,LangChain 在《Agents Are Going Async》中,也直接讨论了 DeepSeek 的 Router / Worker 模式。再包括最近一直在研究的 Grokbot,以及之前写的拆解 Grok Bot:最好用的 Bot 是怎么造出来的?。我发现这些团队虽然做着不同的产品,却在 Always-on Agent 的设计上,开始出现一些相似的选择。我把它们归纳为三个正在形成的共识。
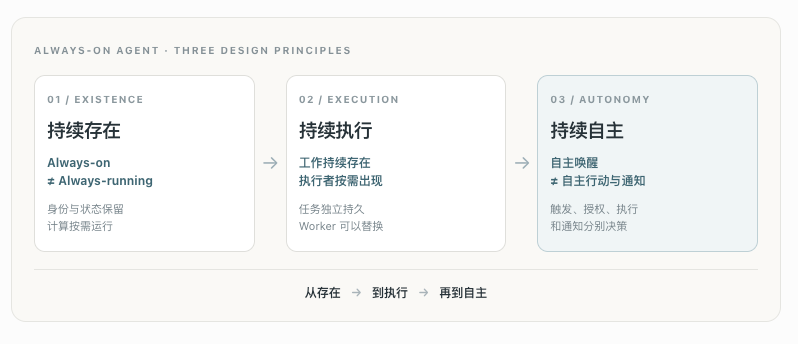
第一,Always-on 不等于 Always-running。从持续存在,到持续执行,再到持续自主。这三个判断,正在改变 Agent 系统组织工作的方式。01|Always-on 不等于 Always-running
一个长期在线的 Agent,为什么不需要一直运行?用户面对的是长期存在的 Bot,但实际执行命令的 Cloud Computer 可以按需启动、休眠和恢复。Bot 的身份与计算环境不必拥有相同的生命周期。Pi Durable 则在 Cloudflare 上,用持久化 Session、休眠与定时唤醒,验证了另一种轻量的实现方式。DeepSeek 的 Super-agent 设计,则从另一个角度讨论了这种分离。它提出把 Agent Loop 的计算、需要持久化的 Session 状态,以及实际执行代码的环境分别管理。Agent Loop 可以运行在云端,而开发机上的代码、依赖和工具不一定需要全部迁移过去。长期存在的是 Agent 的身份与状态,而不是某个永远运行的进程。如果从恢复机制来看,还可以区分不同层次:Memory 保存经验,Durable Workflow 保存执行进度,虚拟机快照帮助恢复运行环境。它们并不能相互替代。更重要的是,日志记录了工具调用,不意味着外部操作一定成功。执行状态可以恢复,真实结果仍然需要核验。02|工作持续存在,执行者按需出现
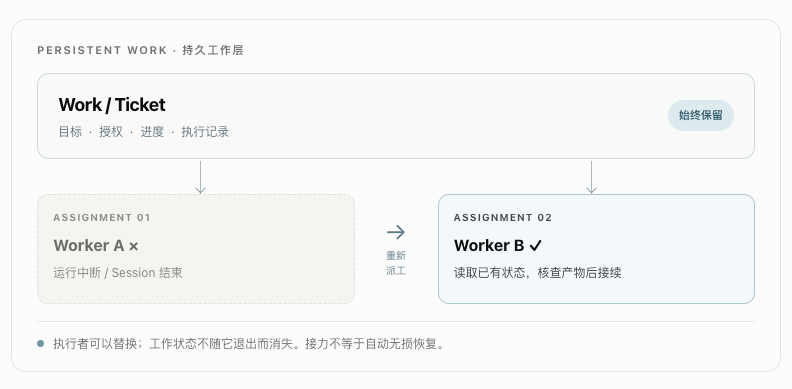
假设一个 Coding Agent 正在修改代码,用户突然追加要求,或者 Worker 运行到一半崩溃。系统如何继续这项工作?DeepSeek 的 Router / Worker 架构,尝试将全局协调与具体执行分开。Router 持续接收消息、协调任务;Worker 在独立 Session 中执行工作。如果所有任务都挤在一个 Session,彼此容易干扰;如果每条消息都新建 Session,又会失去跨任务的连续上下文。而在它开源的 dsh-superagent 原型中,还有一个更值得关注的设计:Ticket。Ticket 被定义为「一个获得授权的工作单元」。它附带 Mandate,记录谁授权、允许做什么,再通过 Assignment 分配给具体的 Executor。这意味着,一项工作不再等同于执行它的某个 Session。Worker 退出后,Ticket 仍然可以存在。系统可以重新分配执行者,让它根据已有记录和外部产物继续处理。当然,这不代表能够自动无损接力。新 Worker 仍然需要检查此前做过什么、哪些外部操作已经生效。如果用户中途修改要求,Executor 也不能自行扩大原有 Mandate,而要判断是否需要交回协调流程重新授权。LangChain 的 Async Subagents 在框架层提供了另一种能力:主 Agent 不必等待后台任务结束,还能查询状态、追加要求或取消执行。Grok Bot 则让长期 Bot 协调拥有独立 Durable Workflow 的 Helper,从持久化工作流层面支持长任务恢复。三家的执行保证并不相同,但都在减少任务对单次模型运行的依赖。相比争论叫 Worker、Helper 还是 Sub-agent,更重要的是:执行者退出后,系统是否仍然知道这项工作该怎样继续?03|自主唤醒不等于自主行动,更不等于通知用户
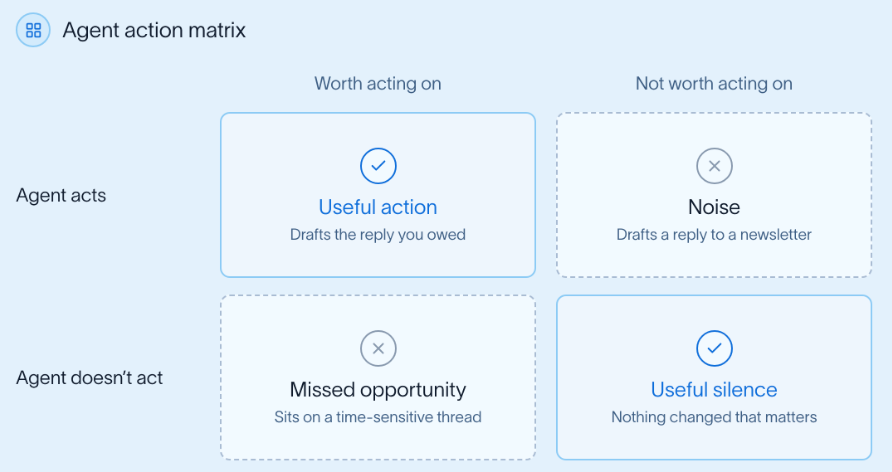
LangChain 在《What We've Learned Building Proactive Agents》里分享了一个挺有代表性的例子。他们的工程 Agent Robin 会关注 Slack 中的讨论,但并不需要每次都参与。团队专门引入了一个名为 Jev 的决策模型,判断 Robin 什么时候真的有话值得说。它既不需要每次都等人 @,也不会因为看到一条新消息,就突然插进同事们的对话。Agent 看见了事件,不意味着必须采取行动;即使能够行动,也不意味着应该打扰人。同样的判断也出现在 LangChain 的销售 Agent 中。GTM Agent 会将邮件会话分成不同情况:哪些正在等待人处理、哪些需要准备回复草稿、哪些根本不需要回复。系统可以在后台持续工作,但不是所有事情都要变成一条通知。LangChain 还披露,在其 Managed Deep Agents 的相关运行中,超过 70% 来自定时调度,而非用户临时发起。当大量工作发生在没有人直接发出指令的时候,判断什么值得做、什么值得告诉人,就成了新的设计问题。04|从持续执行到持续负责
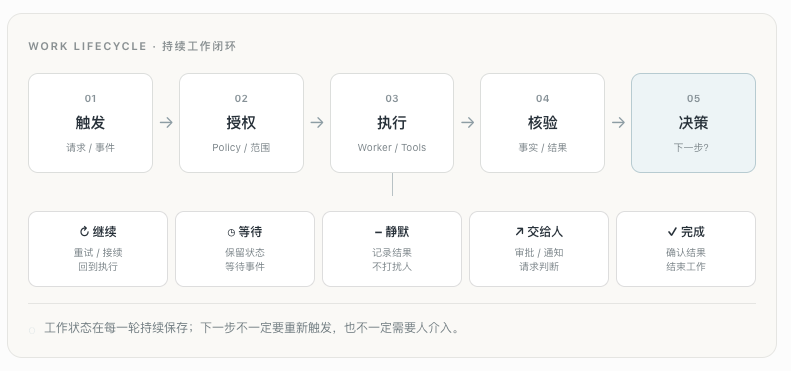
如何让工作不再依赖人持续盯着某个 Agent Session?让状态独立于计算进程,让任务独立于具体执行者,再让系统能够根据事件主动协调工作。这些机制组合起来,一项长期工作就可以形成持续循环:触发 → 评估与授权 → 执行 → 结果核验 → 下一步决策。能不能继续?Worker 崩溃后怎么恢复?外部操作成功却没有记录时,如何避免重试造成重复副作用?应不应该继续?一项持续几天的工作,最初的目标和授权是否仍然有效?继续得对不对?工作虽然没有中断,但如果逐渐偏离目标,谁来发现并纠正?DeepSeek 在设计中还提出了独立 Watchdog,不仅检查进程是否存活,也尝试判断 Worker 有没有取得实质进展、是否偏离目标。公开原型尚不能代表这些可靠性机制已完整落地。只要系统还无法判断工作是否应该继续、结果是否可信,人就仍然需要不断检查和干预。最初那个注意力瓶颈,也就没有真正解除。过去,我们更多围绕一次模型执行来组织 Agent 的工作;现在,开始围绕持续存在的工作,组织每一次模型执行。而从持续执行走向持续负责,可能才是 Always-on Agent 下一道真正需要跨过的门槛。 立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询