Jev + TrueForge:40 次决策准确率持平 Opus,成本为何更低?
本文介绍将 TypeSafe AI 的决策模型 Jev 接入开源智能体框架 TrueForge 的实践:在 40 条客户请求匹配测试中,Jev 方案与 Claude Opus 准确率同为 37/40,但匹配环节成本仅为 Opus 的 1/150~1/250。Jev 提供校准置信度,支持自动复核;TrueForge 则通过延迟加载、结果转存、代码处理与子智能体等机制降低上下文与调用开销。
把 AI 智能体里的部分判断交给专门的决策模型,能省下多少成本?
有人把 TypeSafe AI 的 Jev 接入开源智能体运行框架 TrueForge,用 40 条客户请求做了一次对照测试:接入 Jev 和仅使用 Claude Opus 的方案,都答对了 37 条。按文中的价格估算,同样的匹配决策交给 Opus,成本约为 Jev 的 150~250 倍。
这个倍率对应的是匹配决策环节,不代表整个工作流的成本降幅。Jev 还会为答案提供置信度,让框架把不确定的结果送去复核。
智能体的 token 花在了哪里
AI 智能体通常在一个循环里工作:模型判断下一步做什么,调用工具,处理结果,再继续执行,直到任务完成。
工具调用让模型能够使用外部工具;结构化输出让模型按约定格式返回数据。这两项能力让模型更容易接入应用,与软件协作。
智能体运行框架(Agent Harness)把这些环节组织起来,决定模型能调用哪些工具、如何处理工具结果、接收什么上下文,以及接下来执行什么。上下文越多、模型调用越频繁,运行成本就可能越高。
以一家软件公司的客户跟进流程为例:客户团队把功能需求和 bug 记录在 Notion,工程团队则在 GitHub 跟踪研发任务。
假设 Notion 里有 40 条客户请求,GitHub 里有 300 个 issue(研发任务与问题记录),其中 200 个未关闭、100 个已关闭。每个 issue 包含标题、讨论和标签等内容,平均约 230 tokens,合计约 69,000 tokens。
把客户请求与研发记录对应起来,意味着:
- 40 条请求与 300 个 issue,共有 12,000 种配对可能。
- 关键词难以直接确定匹配,因为客户和工程师往往使用不同的说法。
- 提示词缓存可以降低重复读取的费用,但模型仍然要处理这些内容。
- 更便宜的模型可以降低每个 token 的价格,却不能据此判断每次匹配有多可靠。
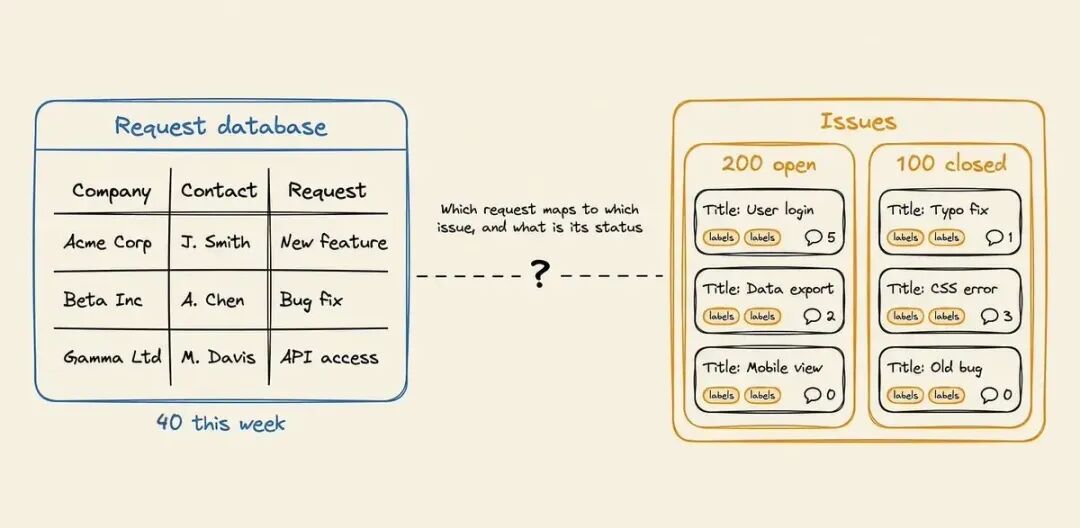
影响一次运行成本的主要有三个因素:模型接收多少上下文、框架调用模型多少次,以及每个判断交给哪个模型。前两项由框架管理,第三项则涉及模型分工。
Jev:从给定选项中做决定
许多智能体任务需要的输出很简单:选一个类别、确定优先级,或从候选项中找到匹配项。让生成模型为每一次选择都生成文本,会产生额外开销。
Jev 是 TypeSafe AI 面向这类任务推出的决策模型,被该公司称为首个“System One”模型。据 TypeSafe AI 介绍,在以决策为主的智能体工作流中,Jev 的运行速度是大语言模型的 40~200 倍。
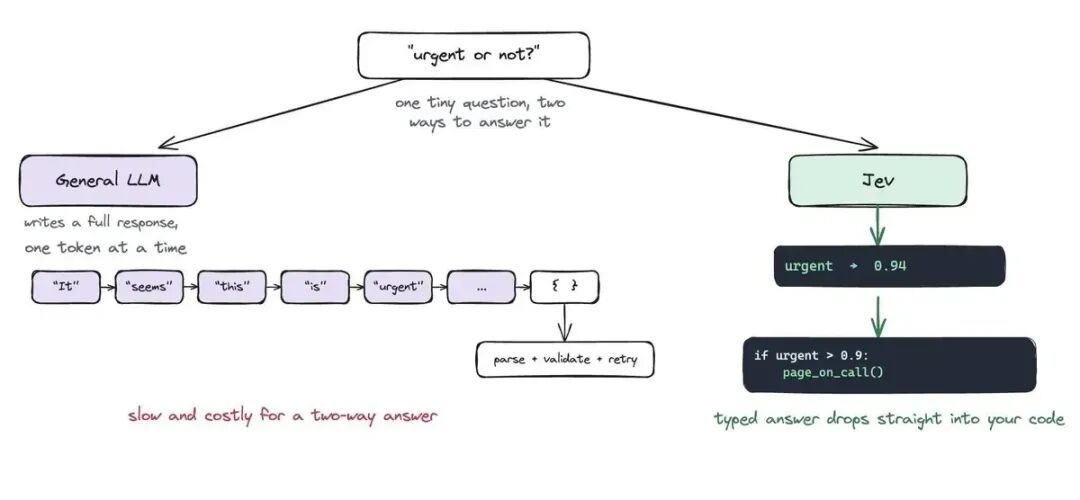
它接收一份状态信息和一个或多个带类型的问题,返回软件可以直接使用的结构化答案:
- Choice:从指定选项中选一个。
- Score:把当前状态归入一组有序等级。
- Noul:返回某个是非判断为真的概率。
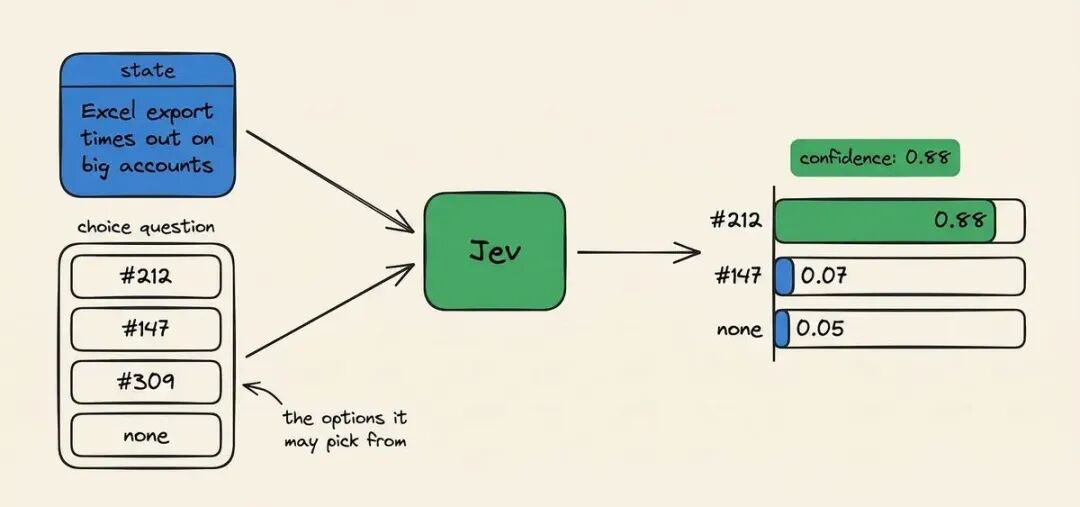
在客户请求匹配中,“状态”就是客户请求及其候选 issue;问题则是哪个 issue 与之匹配,同时允许选择 none,表示没有匹配项。
返回结果可以是:
{
  "type": "choice",
  "choice": "#212",
  "confidence": 0.88,
  "probabilities": {
    "#212": 0.90,
    "#147": 0.06,
    "none": 0.04
  }
}
TypeSafe AI 称,Jev 的置信度经过了校准。也就是说,从大量预测来看,标为 0.88 置信度的答案,正确率应在 88% 左右。如果这一关系在当前工作流中也成立,就可以用置信度决定哪些结果需要复核。
一次请求还能附带其他问题,比如客户的紧急程度。Jev 会并行回答,只增加少量 token,无须再发起一次调用。
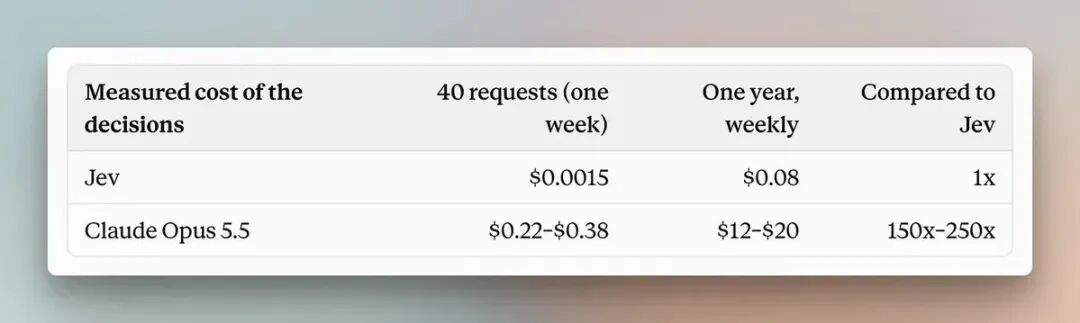
原文给出的计费是每百万输入 tokens 0.042 美元,输出免费。每条请求约 900 tokens,40 条合计约 36,000 tokens,费用远低于 1 美分。
不过,Jev 有两个使用边界:
- 它只能从给定选项中选择。可以返回
none,但不能创建新的 issue。 - 状态信息与最长的那个问题,合计不能超过 32,000 tokens;选项最多 255 个。69,000 tokens 的完整 issue 集合无法直接放进去。
因此,这套流程先筛出 10 个候选 issue,再交给 Jev 选择;其他工作由生成模型完成,整个过程由开源运行框架组织。
TrueForge 如何减少上下文和模型调用
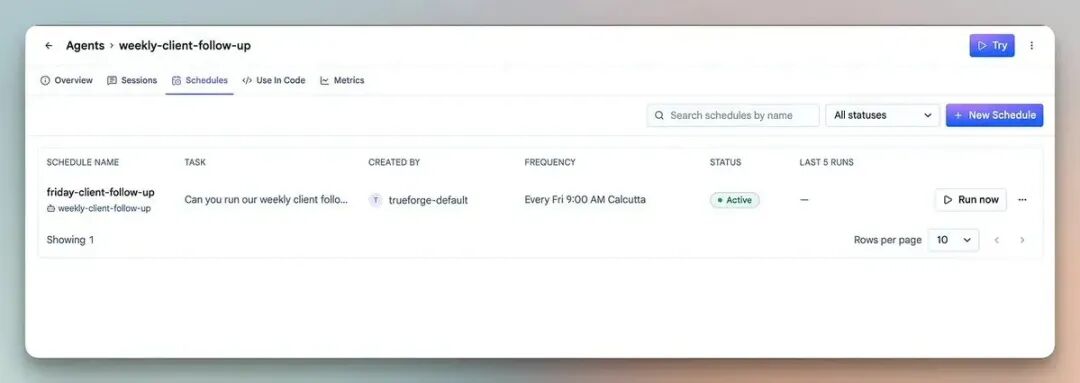
每周自动跟进客户请求,除了调用工具、管理上下文,还需要按时启动、在服务器重启后恢复、在写入前暂停审批,并隔离每位客户经理的会话。
不少智能体运行框架都支持这些功能,成本差别主要在于如何管理上下文,以及需要调用多少次模型。
TrueForge 是 TrueFoundry 开源的智能体运行框架。原文介绍,在 DevRev 的 Enterprise Bench 测试中,TrueForge、Claude Managed Agents 和 deep agents 完成的任务数量接近;TrueForge 使用的 token 约为 Claude Managed Agents 的 1/2.7,不到 deep agents 的四分之一。
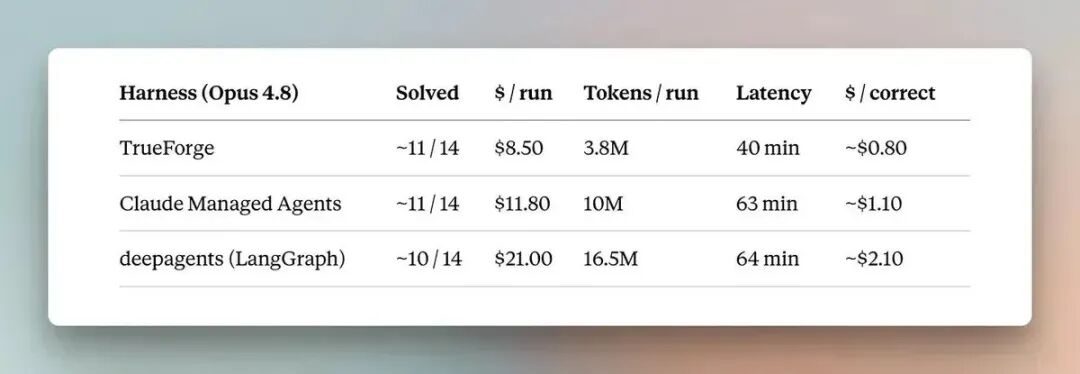
它主要通过四种机制减少每轮上下文和每次运行中的模型调用。
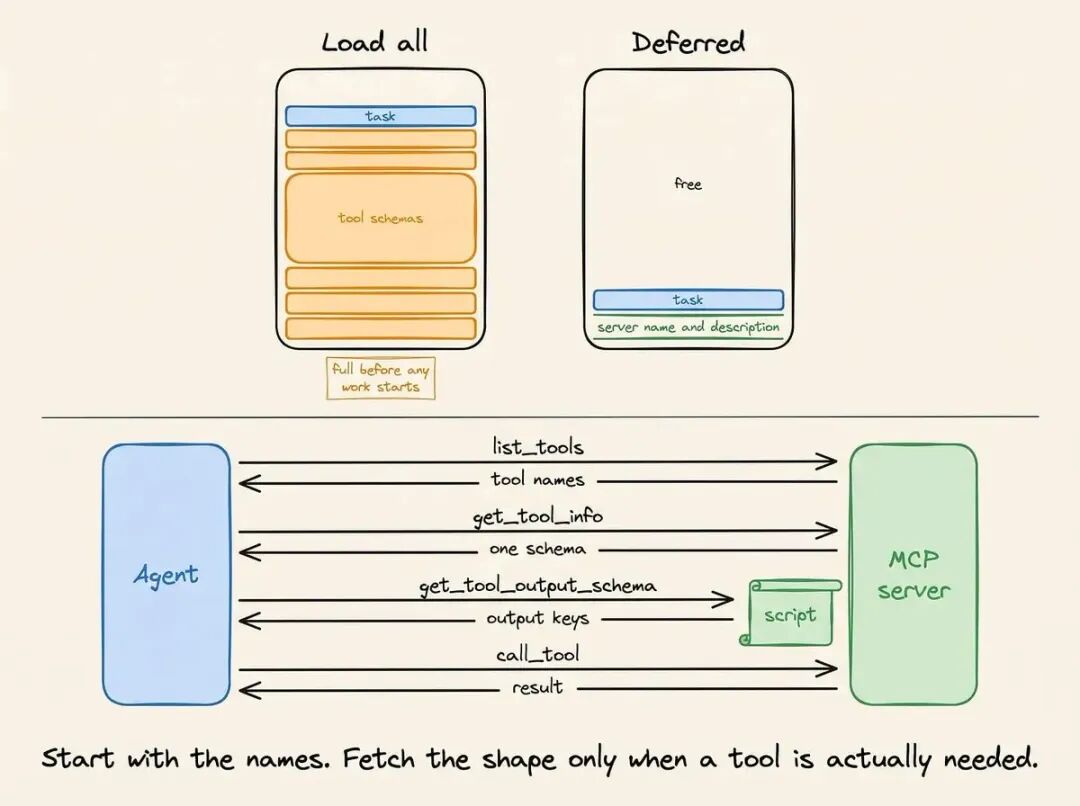
延迟加载工具
TrueForge 启动时不加载所有 MCP 工具的完整定义,而是先提供各服务器的名称和描述,需要时再获取细节:
list_tools:返回某台服务器上的工具名称。get_tool_info:返回某个工具的描述及输入、输出 schema。get_tool_output_schema:只返回输出结构,避免脚本猜测字段名。call_tool:按名称调用工具。
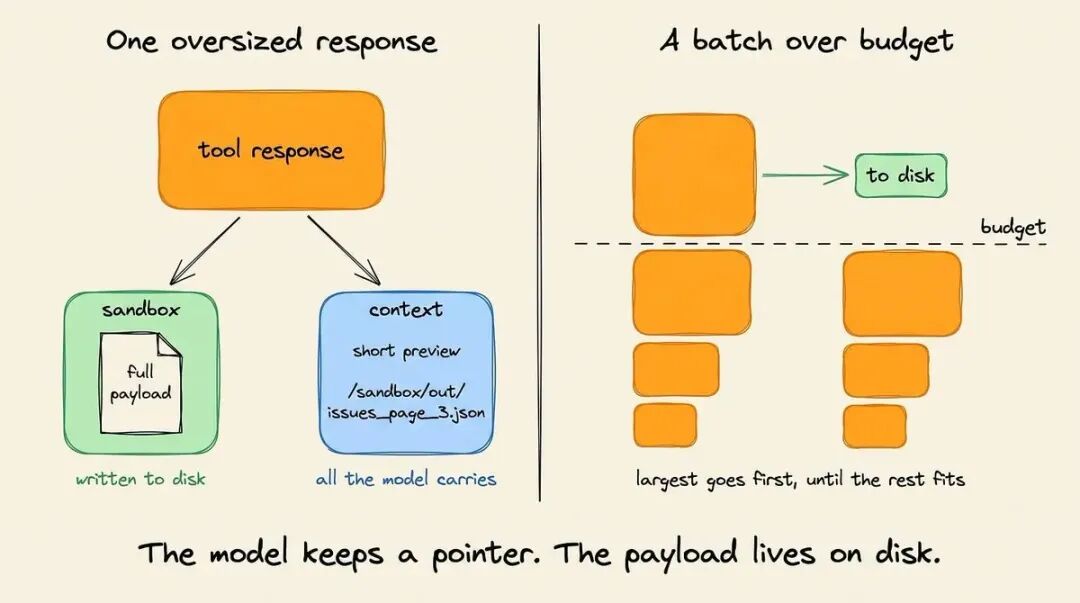
把过大的结果转存到文件
工具返回内容过大、无法放入上下文时,TrueForge 会把内容写入沙箱文件,对话中只保留简短预览和文件路径。如果多个结果导致超限,就优先转存最大的结果。
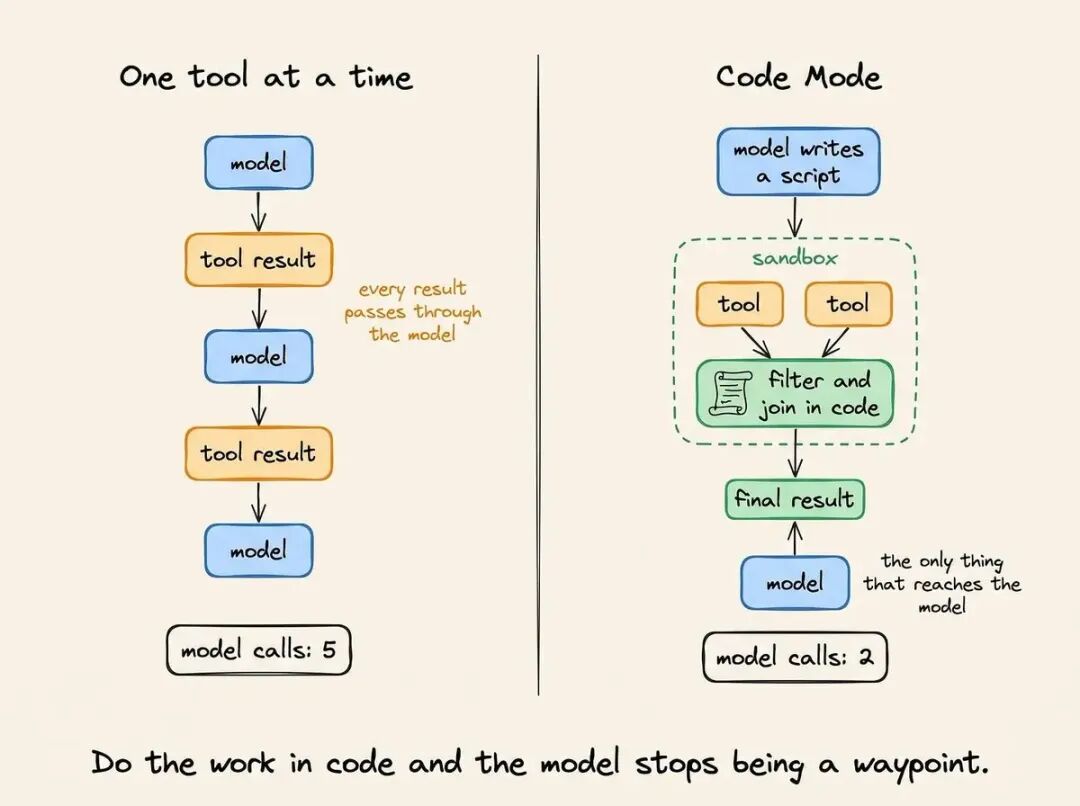
用代码处理工具结果
在代码模式(Code Mode)下,智能体编写脚本调用工具、处理返回值。中间数据留在脚本中,无须逐项进入对话,既能控制上下文增长,也可能减少模型调用。
让子智能体处理独立任务
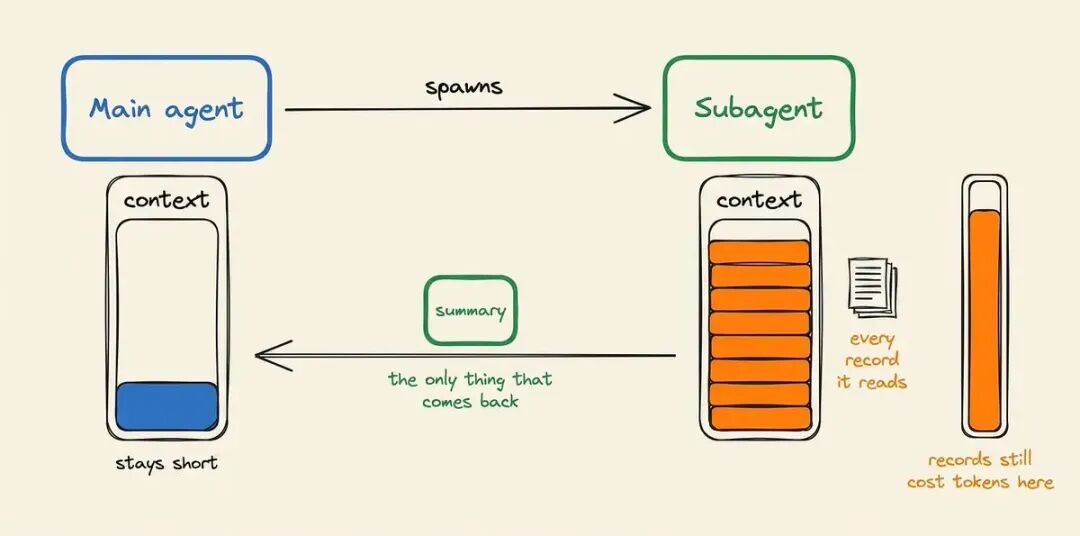
子智能体(Subagents)在自己的上下文里完成一项具体任务,再返回摘要。这能减轻主上下文的负担,但生成模型仍然要消耗 token,读取分配给子智能体的每条记录。
处理客户数据时,部署方式也有影响。托管框架在供应商的基础设施上运行,数据也可能随之进入供应商环境。TrueForge 采用 MIT 许可证,可以运行在自己的环境中。
据原文介绍,它已作为 TrueFoundry AI Gateway 内的 copilot 投入生产,NetApp 和 Automatiq 也在基于它构建智能体。
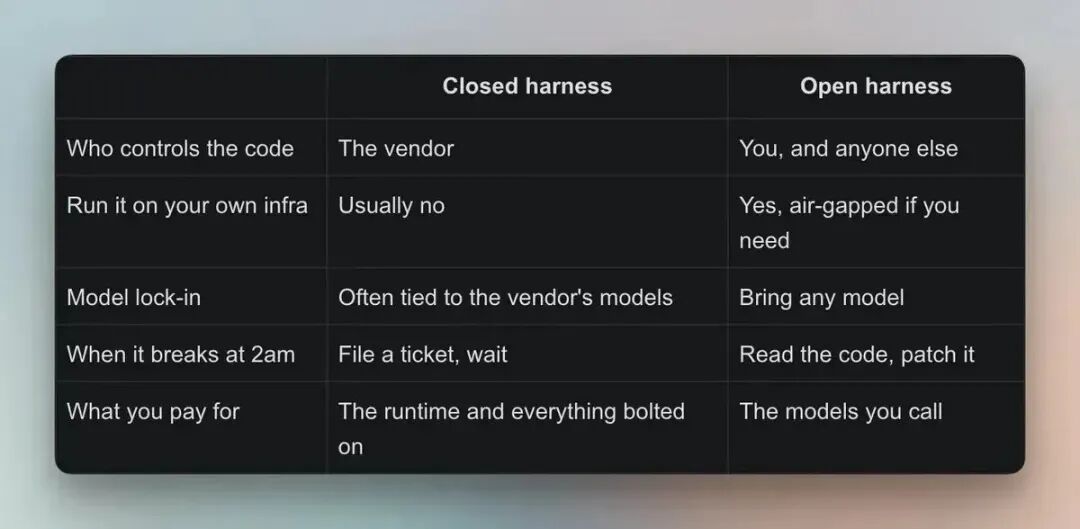
这些机制降低了框架层面的开销。但默认情况下,匹配仍然由擅长生成文本的模型完成。这里可以把匹配判断交给 Jev。
三步完成每周客户跟进
这套流程把工作分成三步。
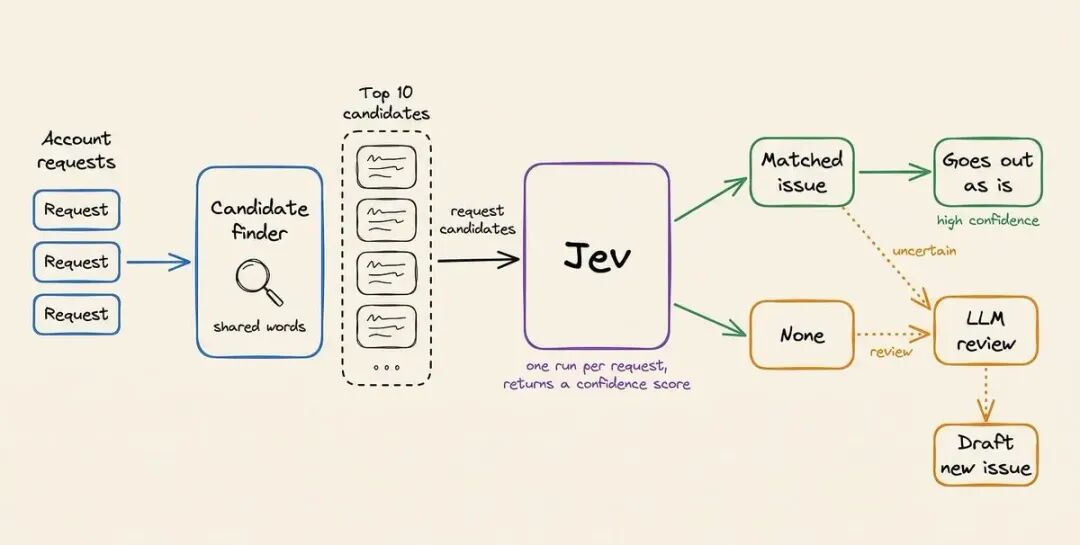
第一步,找候选项。 脚本按客户请求与 issue 共有的词排序,保留前 10 个。这个方法会漏掉一些语义匹配,但能把 300 个 issue 缩小到 Jev 可以处理的范围。
第二步,选择匹配。 Jev 接收每条请求及其候选项,选出一个 issue,或返回 none。
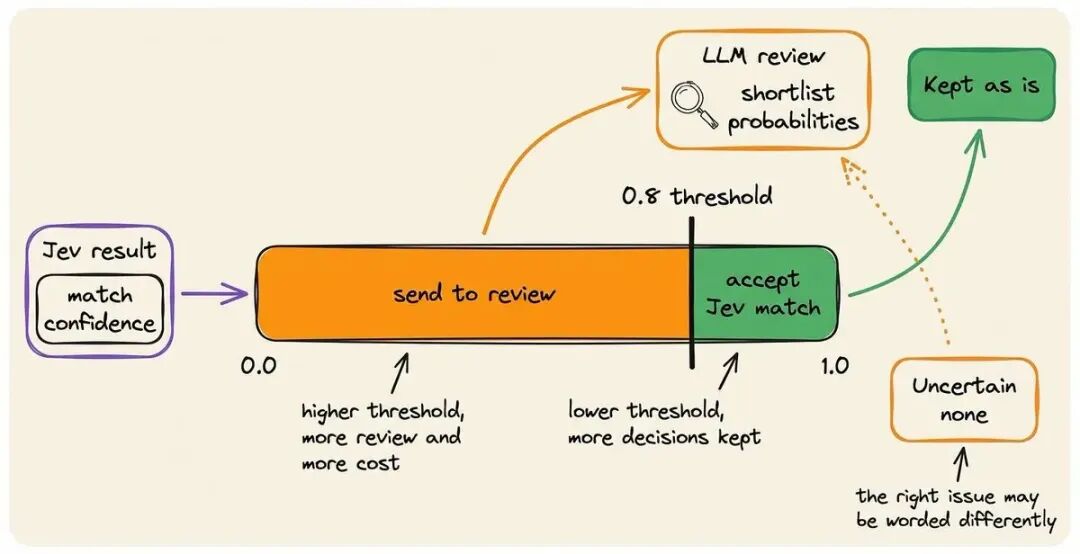
第三步,生成与复核。 如果 Jev 返回 none,生成模型就起草新的 GitHub issue;如果匹配置信度低于阈值,则由生成模型复核。
选出 issue 后,脚本根据字段映射出客户团队可以使用的状态:
- 处理中:issue 未关闭,并且已分配负责人或带有
in progress标签。 - 已记录,尚未开始:issue 未关闭,且既没有负责人,也没有
in progress标签。 - 已修复或不予处理:issue 已关闭,根据关闭方式区分。
40 条请求通过一次批量调用发送。脚本负责获取、处理数据,Jev 负责匹配,生成模型负责起草新 issue 和复核不确定结果。
让模型生成脚本也会带来凭据风险。如果 Notion、GitHub 和 Jev 的密钥放在沙箱里,脚本就能读取它们。从 issue 中获取的文本,也可能影响脚本的行为。
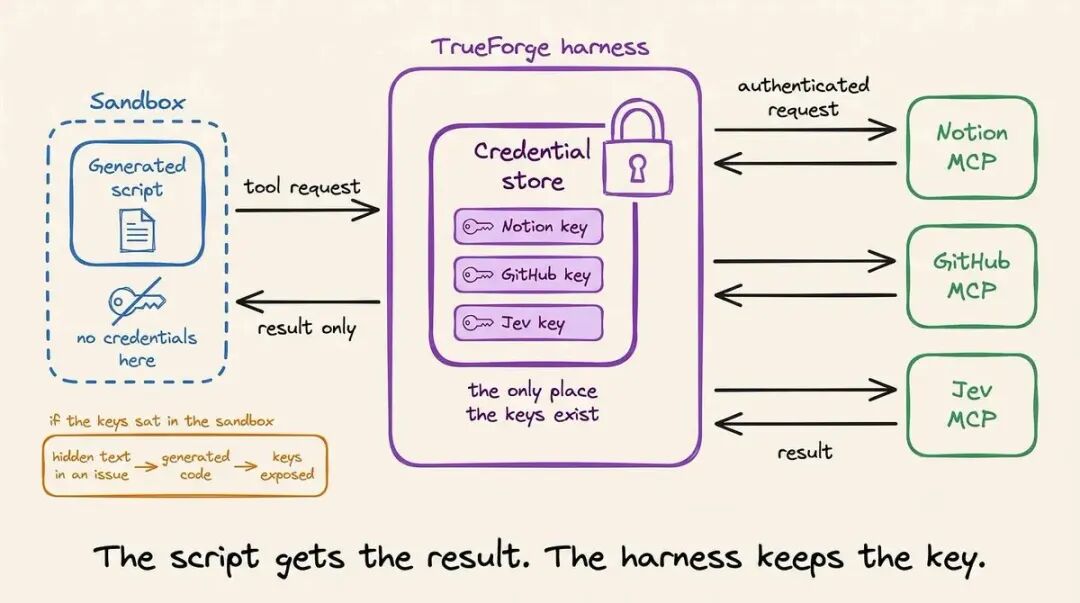
TrueForge 在这里提供了两项保护:
- 凭据放在沙箱外。 工具请求经过运行框架,由框架附加凭据。
- 写入必须审批。 客户团队批准拟议的关联关系和新 issue 之前,Notion 与 GitHub 都不会发生更改。
超过置信度阈值的匹配会被接受。较低置信度的答案,包括不确定的 none,会连同候选列表和概率分布一起交回生成模型复核。
两套方案都答对 37 条,复核表现不同
原作者用同一组 40 条请求测试了两个版本的智能体,两者都使用默认设置的 Claude Opus 5.5。
- 接入 Jev:
weekly-client-follow-up。 每条请求先筛出 10 个候选 issue,再由 Jev 选择。置信度低于 80% 时交给生成模型复核;对于已关闭的 issue,阈值提高到 90%。 - 不接入 Jev:
weekly-client-follow-up-no-jev。 使用相同指令和候选筛选方式,但不连接 Jev,由生成模型读取候选列表并选择匹配。
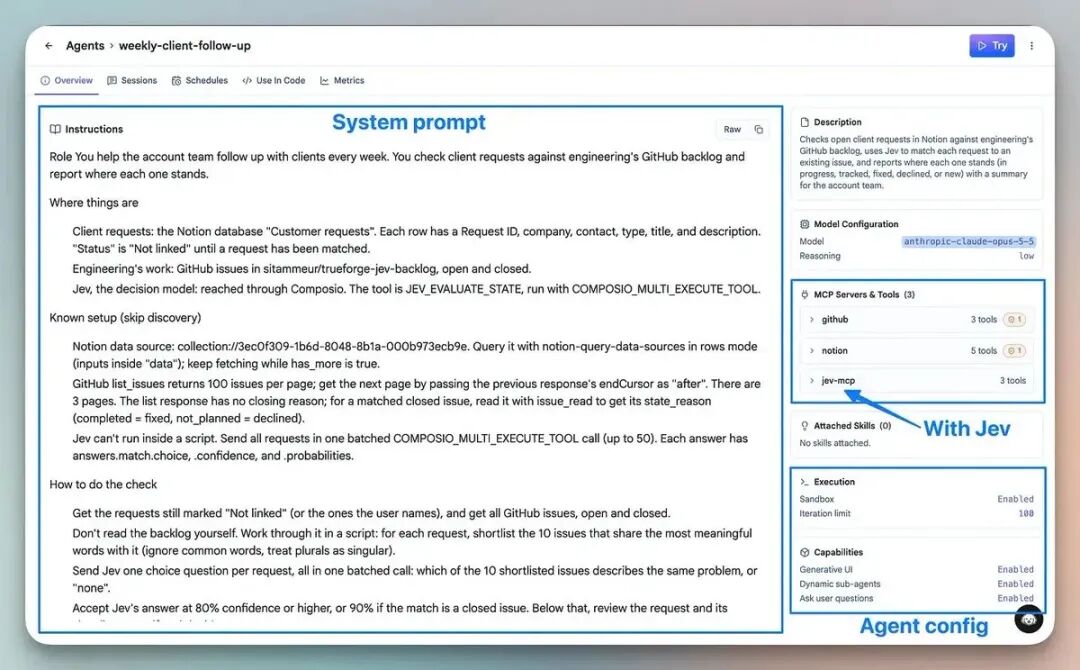
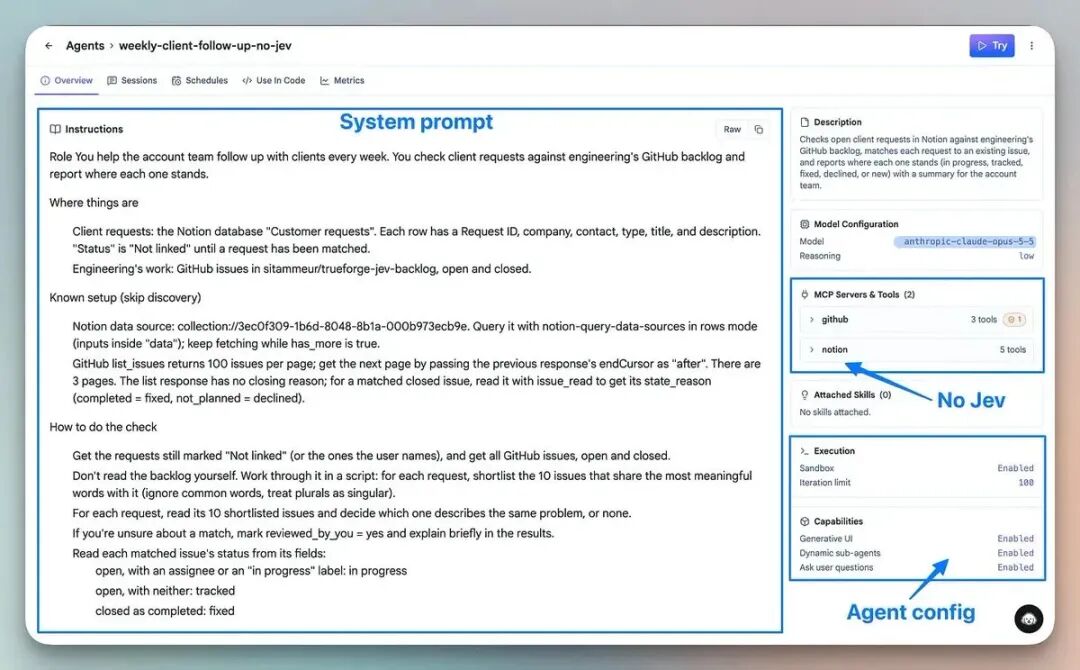
测试集包含直接匹配、近似重复、回归问题、功能需求,以及找不到对应 issue 的请求。每条请求都有标准答案,两套方案按同一标准评分。
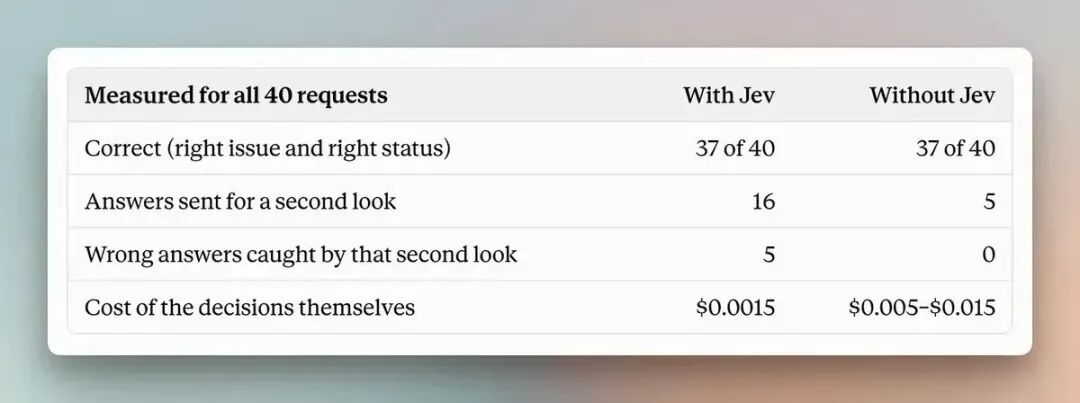
| 指标 | 接入 Jev | 不接入 Jev |
|---|---|---|
| 最终答对数量 | 37/40 | 37/40 |
| 进入复核的答案 | 16 条 | 5 条 |
| 复核发现的错误 | 5 个 | 0 个 |
REQ-004 展示了一种典型错误。
客户说,自从全公司开始使用产品,搜索就“一直转圈,最后也搜不出来”。GitHub 上恰好有一个搜索超时的 issue,但原因不同。
没有 Jev 时,生成模型选中了这个 issue,摘要中会把客户请求标成“已在跟踪”。接入 Jev 后,最高候选的得分只有 0.40,触发复核,最终被正确识别为新问题。
但置信度没有拦住所有错误。REQ-001 是 Jev 方案答错的三条之一:Jev 给错误的 issue 打出了最高置信度,结果直接通过,没有进入复核。
成本比较只针对匹配决策
决策成本大致随请求数量增长。原文比较的是:面对相同候选列表,Jev 和 Claude Opus 5.5 分别完成这 40 次决策的成本。
按每百万输入 tokens 4 美元、每百万输出 tokens 20 美元计算,原作者估算 Opus 的成本约为 Jev 的 150~250 倍。启用扩展思考后,Opus 的思考 token 按输出计费,成本更可能接近区间上限。
整个流程运行在开源框架上,可以复现这组测试,也可以换成自己的 issue 集合。
如何自己运行
TrueForge 可以在本地以单进程运行,使用 SQLite,需要 Node 22.13 或更新版本。
npx @truefoundry/trueforge启动后,打开 本地控制台,在 Settings 中配置运行环境。
本地模式没有登录功能,只应在自己控制的机器上使用。多人使用时,可以采用基于 Postgres 和 Redis 的托管模式,通过 Docker Compose 或 Helm 部署。
接下来的配置步骤是:
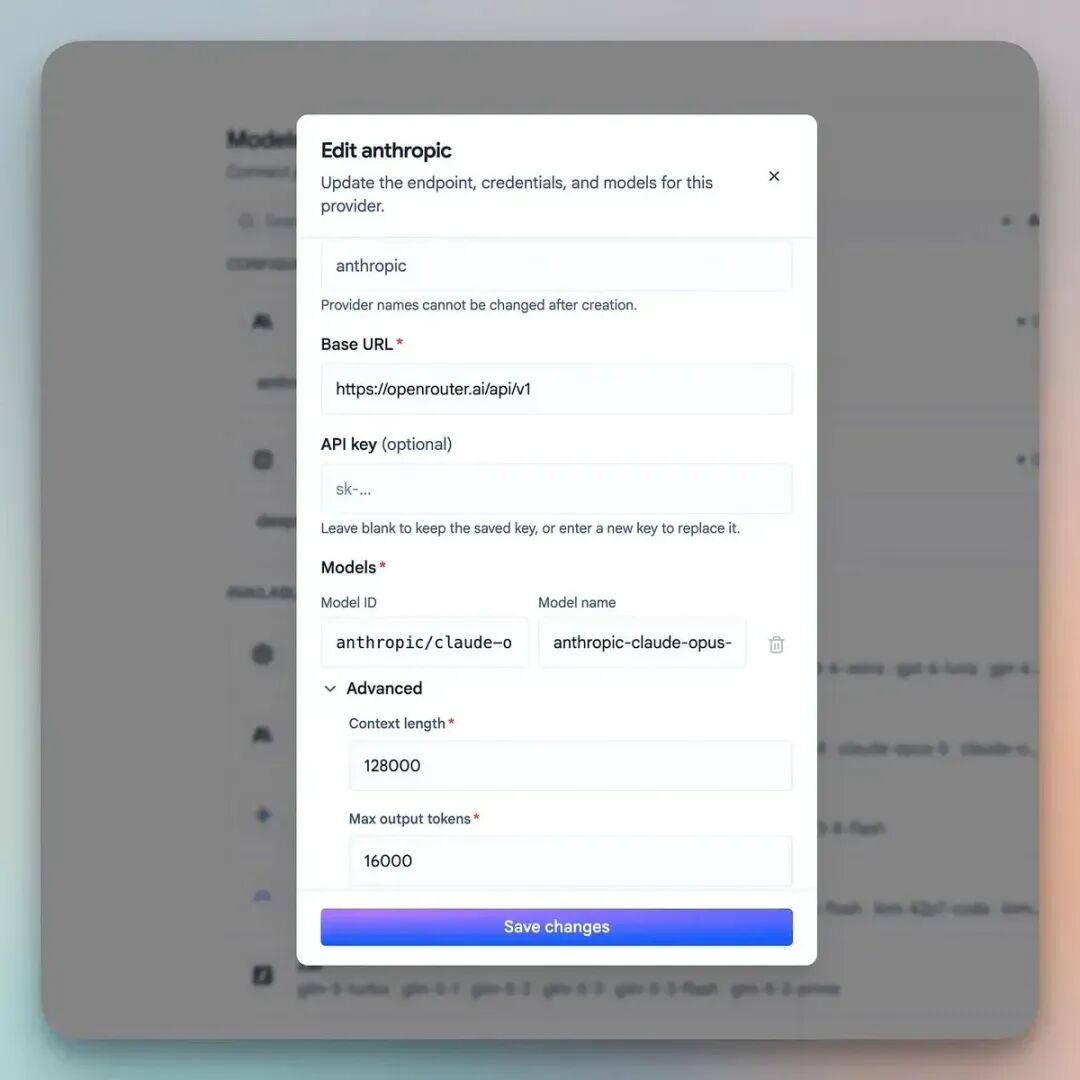
- 在
Settings → Models中添加模型服务商。本例使用 Claude Opus 作为生成模型。 - 在
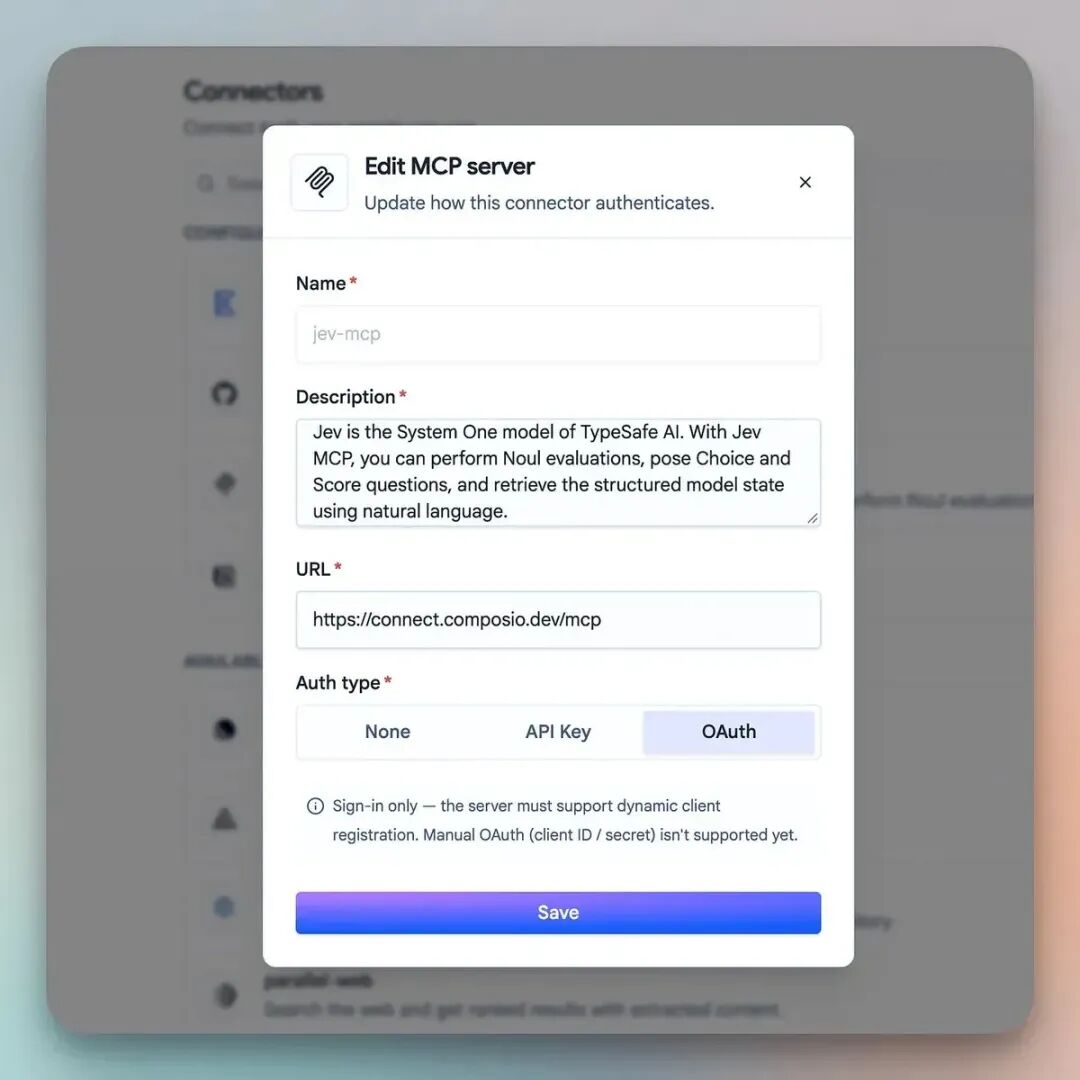
Connectors中连接 GitHub、Notion 和 Jev 的 MCP 服务器。 - 在
Agents中导入或创建智能体配置,启用 Jev 作为决策节点。
JOTO 企业落地观察
- 企业部署需权衡「专用模型」与「通用模型」的协同粒度:Jev 并非替代 LLM,而是将明确有限选项的决策环节剥离,这对客服工单分类、合同条款比对等高重复性判断场景具备即插即用价值。
- TrueForge 的延迟加载与沙箱文件机制,实质是将「上下文膨胀」转化为「存储换算力」,这对 RAG 知识工程中动态注入长文档片段、避免 prompt 过载具有直接迁移意义。
- 置信度校准与复核阈值设定,构成轻量级 AI 安全治理入口:企业无需自建复杂评估流水线,即可基于决策模型输出建立人工兜底规则,适配金融、医疗等强合规场景。
- 该方案依赖 MCP(Model Control Protocol)标准协议实现工具解耦,意味着企业可在不重写业务逻辑前提下,替换底层模型或切换私有化部署的 Jev 实例,强化智能体工程的长期可控性。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们