HarnessPro:Agent 做得更好,为什么还能少花钱?
HarnessPro 是由清华、Z.AI、上海交大等机构提出的智能体运行框架优化方法,通过分析执行轨迹识别无效开销,在提升任务通过率的同时降低单题成本。其核心是将性能与成本纳入统一评估体系,支持 Lite/Medium/Heavy 三档预算策略,并在 Terminal-Bench 2 等基准上实现平均通过率+2.0 个百分点、单题成本-26.1% 的结果。
HarnessPro 改的是模型外面的工作方式
Harness(智能体运行框架)是模型外面的工作环境:它规定模型能看到什么信息、能调用哪些工具、怎样安排步骤、什么时候检查结果。可以把它理解为一套会影响智能体工作方式的操作规程和工具配置。
HarnessPro 从一次次执行记录里分辨两类工作:哪些推理、工具调用和验证确实帮助任务通过,哪些是在重复检查、无效探索或搬运多余上下文。找出具体浪费后,后续修改才知道应该动哪条规则。
研究团队在每个基准中,用 DPP(行列式点过程,一种兼顾样本代表性和差异性的抽样方法)挑出 10 个训练任务,让难度和失败模式都尽量多样。每轮迭代里,每个候选框架在每道训练题上独立运行 3 次,并记录任务结果、模型用量、工具调用和执行轨迹。轨迹分析智能体把重复运行放在一起看,标出失败发生在哪一步、成本花在哪里,以及证据对应的记录位置。
进化规划智能体再围绕同一份诊断提出三类改法:优先省成本、兼顾性能与成本、优先提高性能。编辑智能体在独立工作区落实修改,保留新旧版本差异;旧框架和新候选会一起参加下一轮筛选。改动范围可以落在任务指令、工具预算、任务分流规则、运行时提醒或验证方式上。
这不是一次调参就结束,而是一个“分析、改动、同卷复测、保留好版本”的回流过程:
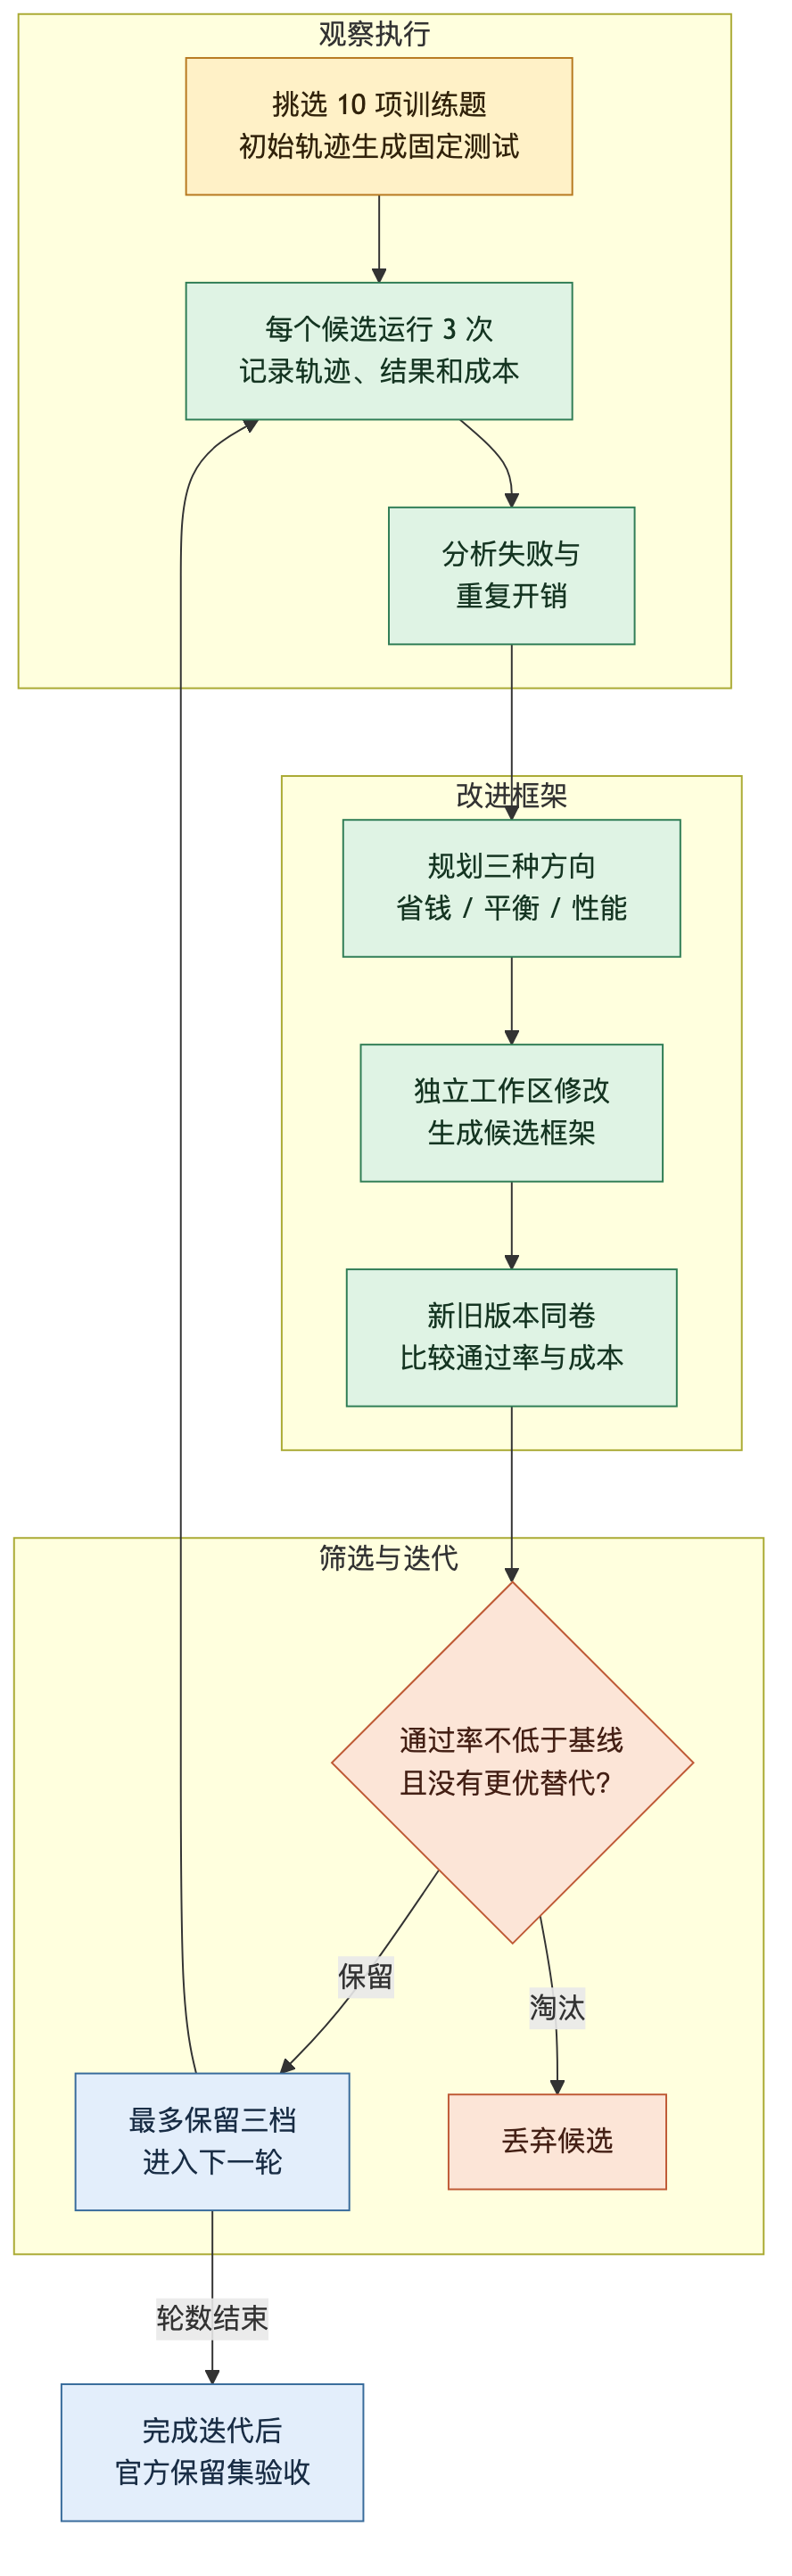
「HarnessPro 从执行轨迹里找出必要工作和重复开销,再调整模型周边的运行规则。」
候选版本要做同一张试卷
迭代期间,官方隐藏测试和标准答案留到最后验收,避免答案泄漏给改进过程,让候选框架朝着“猜中考题”优化。
HarnessPro 用一个测试生成智能体处理这个问题:它根据任务要求和初始框架的执行轨迹,为训练题和验证题生成检查项;这些检查项只生成一次,之后所有候选都用同一套测试。研究团队在一项预实验中报告:对已确认失败的案例,生成测试识别出 83.3%,直接让大模型判断轨迹时识别出 41.7%(失败召回率)。这个结果说明,生成测试在该预实验里更容易抓出有缺陷的实现;后续仍需在更多任务上验证。
每轮候选先在验证题上测通过率和成本。通过率低于原始框架的版本先淘汰;剩余版本中,如果另一个方案在通过率和成本上都不差、至少一项更好,前者也会被淘汰。这种筛选叫帕累托支配:它把“更贵但没有多做对”和“更便宜却没有少做对”的方案排除,留下真正有取舍价值的候选。
官方保留测试集要等全部迭代结束后才启用。这样,训练题负责找问题和提改法,验证题负责比较候选,保留测试负责最终检查;三种任务各司其职,减少改进过程对最终成绩的干扰。
「固定测试让候选在同一把尺子下比较质量和成本,官方保留集只负责最后验收。」
Lite、Medium、Heavy:三种预算偏好
筛选出来的候选不会被压成一个“唯一最好”。HarnessPro 会最多保留三种代表:Lite(低成本档)偏向成本,Medium(平衡档)兼顾通过率和成本,Heavy(性能优先档)更看重通过率。它们使用同一套性能与成本指标,只是筛选时的权重不同:Lite 为(1,2),Medium 为(1,1),Heavy 为(2,1),前一项看通过率,后一项看成本。
权重不是简单地把最高分或最低价者直接选出来。系统先把候选离“最高通过率”和“最低成本”的差距分别归一化,避免百分点和美元直接相加,再按 Lite、Medium、Heavy 的偏好合并两项距离。因此,企业可以按任务预算选择运行框架,而不是要求所有任务都用最高配置,或一刀切地压低推理预算。
论文还展示了运行时怎么把这类策略落到具体动作。在 Terminal-Bench 2 和 SWE-Bench Pro 中,框架会根据公开的任务描述选择执行档位,再为档位设定推理强度和工具预算。在 Terminal-Bench 2 的一个具体例子中,Medium 选中标准任务档位后,工具调用达到 14 次,系统提醒智能体批量调用工具、减少重复检查;达到 26 次,转向完成任务和验证结果;超过 44 次则阻止继续调用。这个例子只对应特定基准和任务配置;企业落地时应从自己的任务轨迹校准阈值。关键在于按任务安排预算,再由运行时规则推动智能体从探索转向收尾。
在 GPT-5.5 + Codex 的三项基准上,HarnessPro-Heavy 相比 RHO 的结果如下:
| 基准 | 任务通过率 | 单题平均成本 |
|---|---|---|
| Terminal-Bench 2 | 76.3% 到 80.8% | 1.09 美元到 0.72 美元 |
| SWE-Bench Pro | 80.0% 到 80.7% | 2.68 美元到 1.97 美元 |
| ProgramBench(程序重建基准) | 68.8% 到 69.6% | 3.59 美元到 2.95 美元 |
研究团队报告的三项基准平均变化是:通过率提高 2.0 个百分点,单题成本下降 26.1%。不过,把 RHO 的推理强度统一调低也能降成本;SWE-Bench Pro 上单题成本从 2.68 美元降到 1.08 美元,通过率却从 80% 降到 59%。这也是按任务调整、保留验证,比统一砍推理更值得讨论的原因。
「三档不是强弱排名,而是按预算偏好留下的三种性能—成本落点。」
论文中的成本按每道任务所有模型调用的输入、缓存输入和输出 token(模型计费单位)计价;它不等同于包含部署、人力、工具基础设施在内的企业总成本。以上是 arXiv 预印本中研究团队报告的基准结果,不是独立复现或生产环境的降本保证。
企业可以先把记分牌改对
这项研究给产品和业务团队的提醒,不是“把 Agent 的推理调低就能省钱”。更稳妥的顺序是先记录,再找出重复劳动,最后用固定的质量门槛验证修改有没有伤到交付。
把这套思路放进自己的 Agent 项目,可以先问三件事:
- 每个任务做成了没有,所有模型调用分别花了多少,工具调用和等待时间又是多少?
- 哪些重复检查、无效探索或冗长上下文,在多次执行中都没有提高正确率?
- 如果要调整预算,哪些验收条件必须守住,候选版本是否能用同一套测试比较?
省钱不是让智能体少做所有事,而是让必要的推理和验证留下来,把能从轨迹中指出来的浪费删掉。谁批准给 Agent 加预算,谁也应该能说清楚:这笔钱换回了多少可靠交付。
「Agent 降本先找重复劳动,再用固定质量门槛验证;不要全局砍推理。」
JOTO 企业落地观察
- 企业部署智能体时,若仅以任务成功率作为唯一验收指标,容易掩盖隐性成本膨胀;HarnessPro 提出的双维评估框架提示团队需同步建立“通过率—token 成本”记分牌,这对构建可持续演进的智能体服务至关重要。
- Lite/Medium/Heavy 三档策略并非配置开关,而是要求企业在上线前完成任务分类与预算映射——这意味着知识工程需前置沉淀任务特征标签(如复杂度、容错率、SLA 要求),否则档位选择将失去依据。
- 该方法依赖高质量执行轨迹采集与结构化归因,对企业 RAG 知识工程提出新要求:需将工具调用日志、中间验证结果、失败锚点等纳入向量库并支持语义检索,才能支撑后续的浪费识别与规则生成。
- 帕累托支配筛选机制意味着企业不能仅依赖 A/B 测试单点优化,而需构建可版本化、可回滚的运行框架仓库;这对 FDE 驻场共创中的变更管理流程和灰度发布能力构成实际检验。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们