Jev怎么用:5类场景与接入指南
Jev 是 TypeSafe 推出的专用决策模型(System One),专为 Agent 中结构化判断任务设计,支持从选项中选择、按条件打分或返回概率。本文通过客服消息分流示例,详解其接口形式、5类适用场景(消息分流、工具选择、资料筛选、回复检查、风险预筛),并基于700条样本实测对比 Jev、DeepSeek 和 GLM 在新闻分类、句对推断、提示词攻击识别上的准确率、耗时与费用,强调需结合置信度分析、影子运行与真实业务规则验证效果。
给自己搭 Agent,常会碰到这种小任务:一条消息应该交给哪个工具,搜到的资料是否相关,一段回答有没有跑题。你只需要一个选项,却又调了一次大模型。Jev 就是为这类判断设计的。
Jev 是 TypeSafe 推出的决策模型,也是它所称的 System One 模型。 你给它一段材料,写清要判断的问题和标准,它返回程序能直接读取的结果:从几个选项中选一个、按等级打分,或者给出某个条件成立的概率。它不负责撰写文章、生成代码或解释判断过程。
为什么要单独做一种模型?看看客服助手的工作就容易理解了。收到消息后,它先判断用户要查账单还是报故障,再调用对应工具,最后组织回复。前一步需要一个分类,后一步需要写出完整句子。Jev 把前面这类范围明确的判断单独接下来,让应用可以分别选择处理判断和生成的模型。
它在 Agent 里的位置,可以是一处消息分流,也可以是一道资料筛选。 例如先判断一段文档是否涉及用户问的产品版本,把相关材料交给大模型;或者检查回答是否遗漏用户明确要求的步骤,再决定要不要重写。这些是可尝试的流程设计,效果还要用自己的样本验证。
普通大模型同样能做分类,也能按指定格式返回结果。因此,是否换成 Jev,不能只看接口形式:需要比较这一处判断的正确率、等待时间,以及加上失败回退后的总费用。如果现有方案已经满足要求,可以继续保留。
还有一个边界要先讲清:结果格式受约束,不代表判断一定正确。 候选项分不清、材料不充分,或者问题超出能力范围,都可能得到错误答案。Jev 的输出要由你的程序决定怎么用;涉及实际操作时,仍需检查权限和执行条件。
官方概念说明:
https://docs.typesafe.ai/concepts/system-one
这次我在本机通过 OpenRouter,用同一批 700 条样本分别测试了 Jev、DeepSeek 和 GLM,共留下 2100 条结果,另外跑通了一条中文消息分流示例。下面先看它怎样处理这条消息,再对照实测结果,判断自己 Agent 的哪一步值得试。
一、先看一条消息,Jev到底替你做什么
假设你给自己的小产品做了客服助手,收到这句话:
我想导出上个月的发票,但点击下载一直报错。
程序需要先决定:去查账单,还是进入技术排障?看到“发票”就走账单流程,会把真正的问题漏掉。这需要理解句子的意思。
用 Jev 时,你把待判断内容放进 state,再把问题和备选答案交给它。下面是我实际发送过的请求。示例消息为教学构造,返回结果来自真实调用。
{ "model": "typesafe/jev-1.13", "state": "我想导出上个月的发票,但点击下载一直报错。", "questions": { "route": { "type": "choice", "instructions": "选择这条请求最先应进入的处理流程。涉及发票但实际问题是功能报错时,优先归入技术排障;信息不足或多个需求无法区分时选人工确认。", "criteria": { "billing": "查询扣款、补开发票、申请退款,不涉及功能故障", "technical": "报错、服务不可用、功能无法正常完成", "human": "信息不足或无法确定优先处理流程" } } } }这次返回的 choice 是 technical,confidence 是 1。程序拿到选项,就可以进入技术排障流程。Jev 没有替用户修好下载功能,也没有写客服回复;这两步仍由后面的工具和生成模型处理。
这张图把判断、执行和回复分开。它是接入设计示意,本文实测只跑到了返回分类这一步。
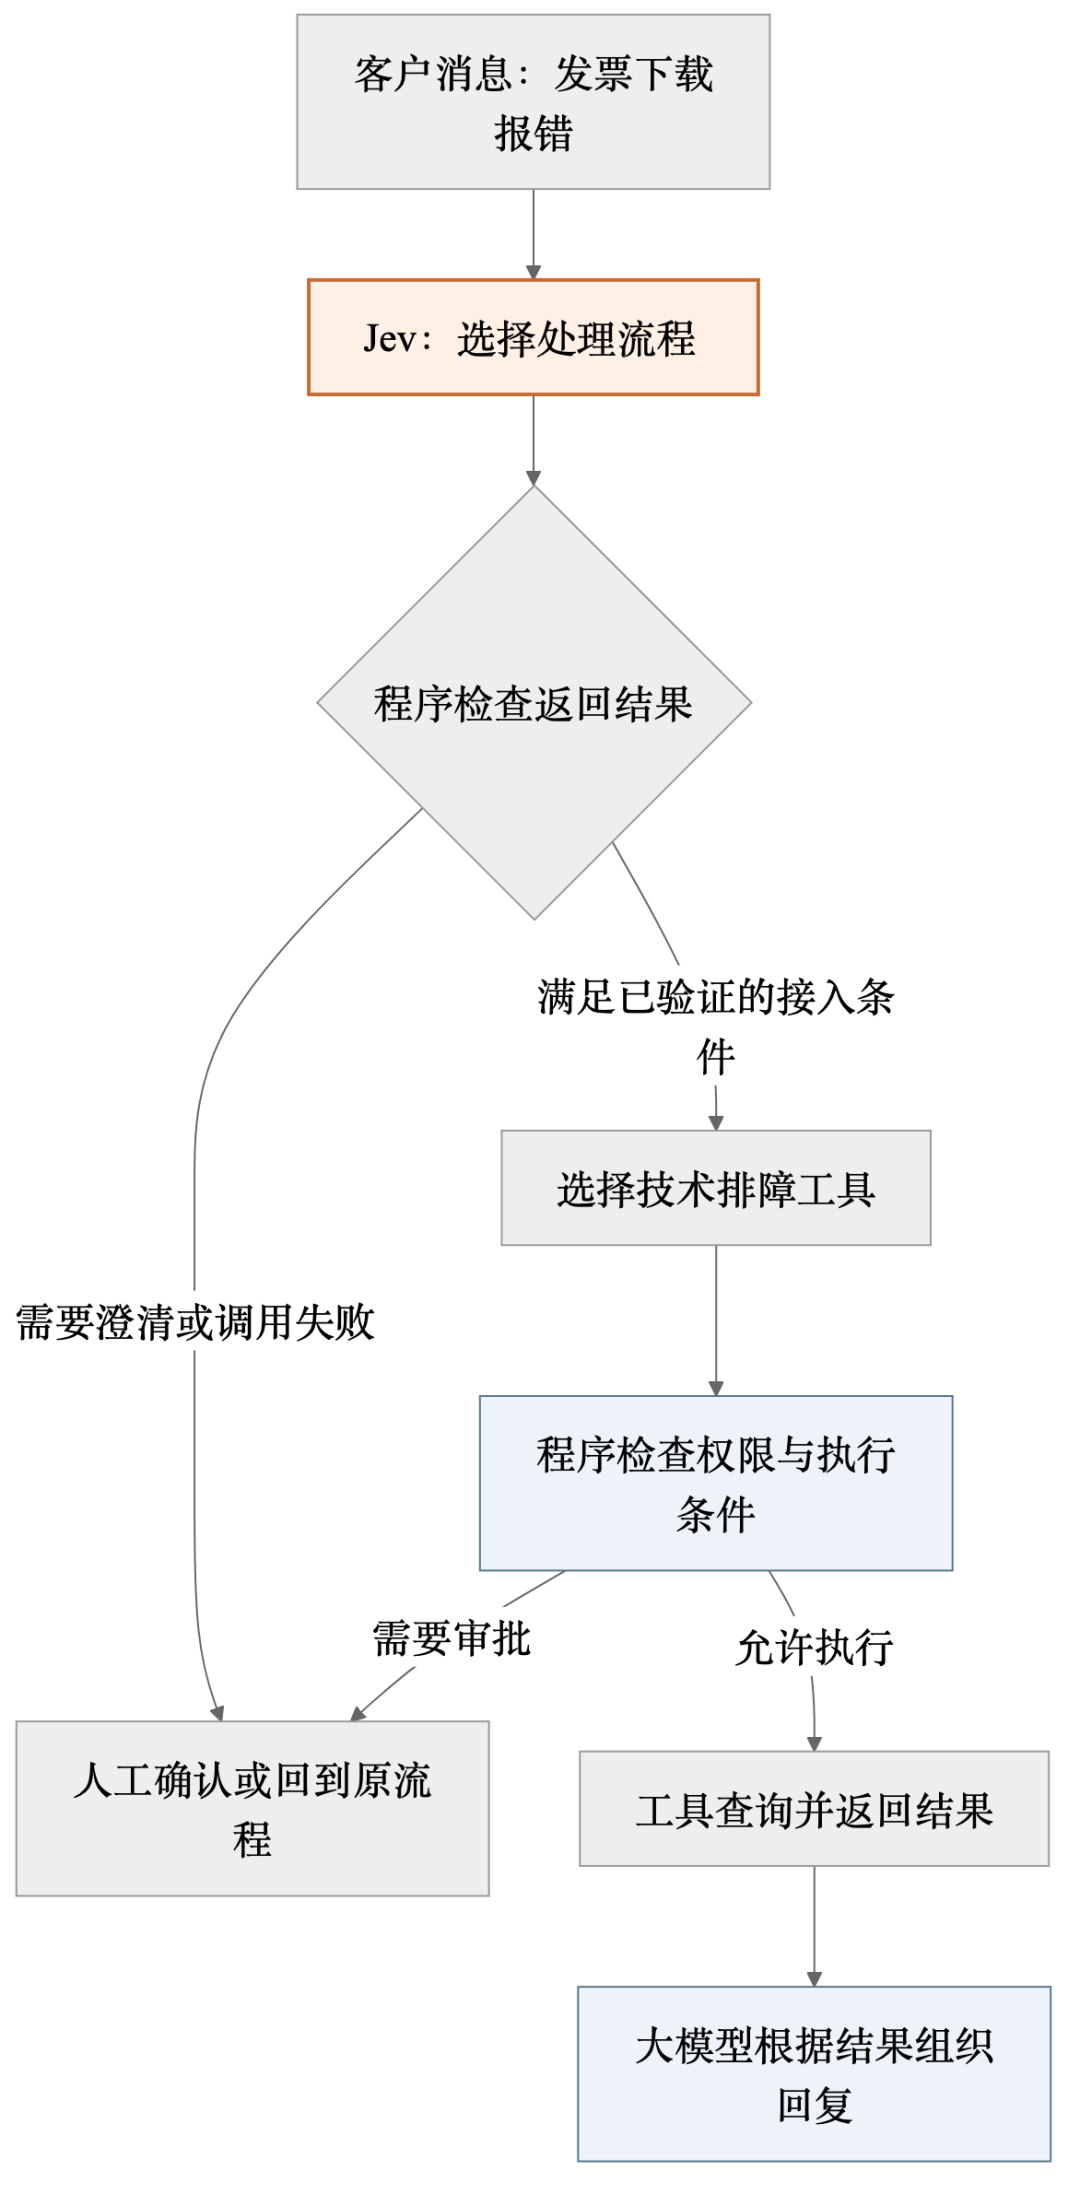
这里要花心思的是分类标准。单独写“账单问题”和“技术问题”,发票下载失败就可能落在两边。示例把交叉情况写进了规则,也留了“人工确认”这个出口。
Jev 有三种回答方式,先按自己需要的结果选即可:
| 你要的结果 | 接口类型 | 可以问什么 |
|---|---|---|
| 从候选项中选一个 | Choice | 这条请求先交给哪个流程? |
| 判断一个条件是否成立 | Noul | 消息是否明确要求退款?返回“是”的概率 |
| 按有序等级打分 | Score | 这段内容与问题的相关程度,按低、中、高评价 |
Choice 和 Score 还会返回各选项的概率分布及置信度;Noul 没有单独的 confidence 字段。这些是接口含义,实际答得对不对需要另外测。官方 API 文档(https://docs.typesafe.ai/api)
把上面的请求保存为 request.json,在已配置 OPENROUTER_API_KEY 的终端里可以这样调用。本次实测用的就是这个接口路径,密钥只在请求头中使用:
curl --fail-with-body https://openrouter.ai/api/v1/systemone \ -H "Authorization: Bearer $OPENROUTER_API_KEY" \ -H "Content-Type: application/json" \ --data-binary @request.json如果已有大模型能稳定返回结构化结果,先保留它做对照。换 Jev 的理由,要从你这一步的正确率、等待时间和总费用里找。
二、这5类判断,可以放进候选清单
对独立开发者,我建议先找频繁发生、输入范围小、错了能纠正的判断。下面是可试的设计方向,不代表这次已经把五类业务都测了一遍。
| Agent里的位置 | 把问题写具体 | 验收时看什么 |
|---|---|---|
| 消息分流 | 查订单、报故障、提建议,应该先走哪条流程? | 人工标注的真实消息中,有多少分错了 |
| 工具选择 | 候选工具已列好,本次要调用哪一个? | 工具选对后,任务是否真的完成 |
| 资料筛选 | 这段资料是否直接涉及用户问的产品版本? | 有没有漏掉关键资料、留下无关内容 |
| 回复检查 | 这段回答是否遗漏了用户明确要求的步骤? | 人工复核发现的漏检和误报 |
| 风险预筛 | 请求是否涉及删除文件、外发数据或改权限? | 危险操作是否漏检,正常任务是否被误挡 |
比如资料筛选,别一开始就把整本手册塞进去问“哪些重要”。先选一个清楚的问题:“用户问的是退款期限,这一段有没有说明期限?”留下相关段落,再交给生成模型组织回答。
工具选择也一样。你要先把各工具的职责写清楚,尤其是能力重叠的地方。否则“查订单”和“查支付”都能查到一部分信息,模型选了其中一个,后面的流程仍可能走不通。
风险预筛要放得更谨慎。它可以为复核提供信号,但文件权限、执行范围和人工审批仍要在程序里落实。后面的实测只测了攻击文本识别,没有证明它能保护一整套 Agent。
还有一类任务应直接留给代码:金额加总、库存计数、日期比较、检查字段是否存在。TypeSafe 自己也提示 Jev 的算术和日期比较短板。你已经能用确定规则计算的结果,没必要再引入一次可能出错的判断。官方能力边界(https://docs.typesafe.ai/model-jaggedness/jev-1.13)
三、700条样本里,Jev有得有失
除了开头的示例,我还用三个公开数据集里的固定样本做了批量对照。新闻分类和句对推断各 300 条,提示词攻击识别 100 条。三个模型使用同一批输入,都经 OpenRouter 调用。
先分清测试覆盖的范围,才知道这些成绩可以用来判断什么。
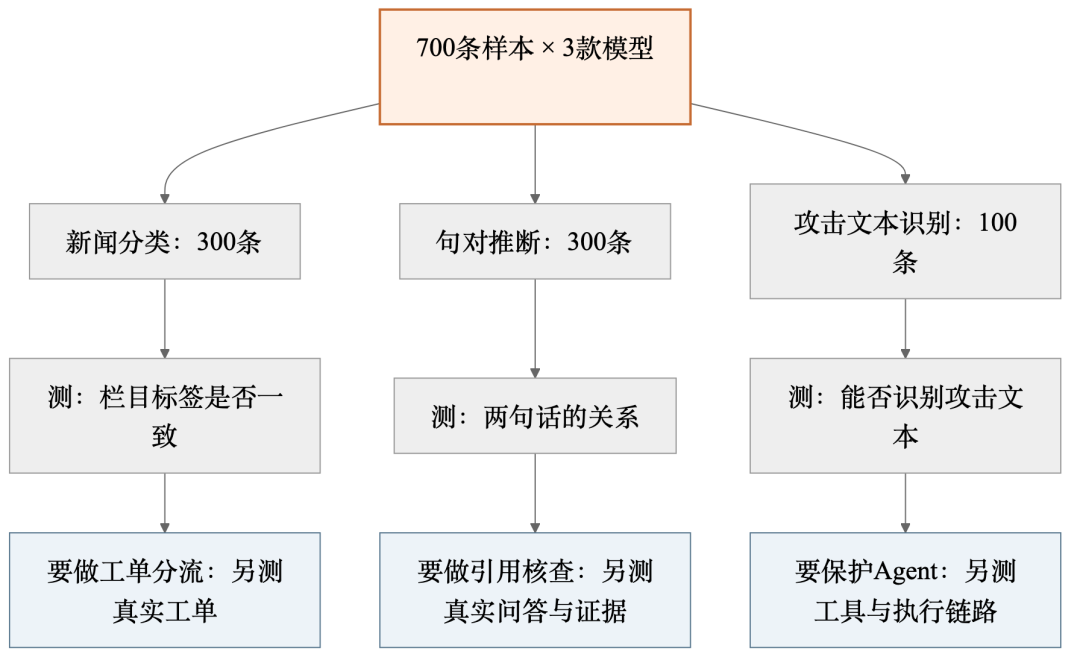
对照模型是 DeepSeek V4.1 Flash 和 GLM 5.3 Flash。DeepSeek 关闭思考,GLM 使用低档思考;二者都要求返回结构化结果。参数约束不完全一样,这组结果用来比较本次接法,不代表模型的能力上限。
| 任务 | Jev 1.13 | DeepSeek V4.1 Flash | GLM 5.3 Flash |
|---|---|---|---|
| 新闻栏目分类,300条 | 48.67% | 52.33% | 53.67% |
| 中文句对推断,300条 | 82.00% | 74.33% | 79.00% |
| 提示词攻击识别,100条 | 95.00% | 99.00% | 96.00% |
表中是与数据集标签一致的比例,解析失败也计入分母;百分比保留两位小数。GLM 在后两项各有一条解析失败,没有悄悄删掉。
新闻分类先暴露了类别边界的问题。 这批样本来自 TNEWS,要求从 15 个栏目中选一个,三个模型都只对了一半左右。栏目间存在交叉,例如跨境电商可以涉及科技,也可以涉及财经。低分既可能来自判断错误,也可能来自分类标准与数据集标注口径不一致。
这对客服分流很有参考价值:先把“退款没到账”和“退款按钮报错”该去哪里约定清楚,再测模型。不能拿新闻分类的成绩直接替代你自己的工单测试。
句对推断是 Jev 本轮更值得继续试的方向。 这个任务给出两句话,让模型判断后一句能否由前一句推出、是否矛盾,或者信息不足。Jev 答对 246 条,对照两款分别答对 223 条和 237 条。
它接近“这段材料能不能支持这个说法”的局部判断。但本轮没有检索网页,没有核对网页出处,也没有检查整篇文章,所以我不会把 82% 写成“事实核查准确率”。如果你的 Agent 需要检查回答依据,下一步应换成真实问答和对应证据重新测。
攻击识别则提醒我别只看百分比。 Jev 的 95% 对应漏掉 5 条攻击样本,DeepSeek 漏掉 1 条。对于一个辅助标记器,这可能值得研究;如果拿它决定是否放行危险操作,漏掉的具体内容就比总分重要。
这 100 条由 50 条攻击文本和 50 条正常文本组成,Jev 以 Noul 返回值不低于 0.5 判为攻击;正常样本还做了来源筛选。79 条含中文字符,21 条不含,不能叫“纯中文安全测试”。它测的是一段文本是否像提示词攻击,距离真实工具调用中的攻击拦截还有一段距离。
三组都是单次运行,样本有限、任务范围也窄。对这三类用途,我会分别处理:继续测句对判断,先修订分类规则,逐条审查攻击识别漏掉的样本。任何一项都还不足以支持直接替换生产流程。
快和便宜,也要按自己的调用算
下面每格依次是“单次调用耗时中位数 / 每千条估算费用”。费用单位为美元。
| 任务 | Jev | DeepSeek | GLM |
|---|---|---|---|
| 新闻分类 | 1.61秒 / $0.0262 | 3.13秒 / $0.0519 | 1.62秒 / $0.0254 |
| 句对推断 | 0.94秒 / $0.0177 | 1.79秒 / $0.0279 | 2.24秒 / $0.0347 |
| 攻击识别 | 2.66秒 / $0.0241 | 3.51秒 / $0.0533 | 3.44秒 / $0.0418 |
Jev 的新闻分类费用略高于 GLM,耗时也接近。到了句对推断,它的耗时和费用才同时更低。差异取决于任务,不能浓缩成一句“全面更便宜”。
这些耗时包含本机网络和网关链路,三款模型分批运行,也没有把重试等待算进去,不能当成纯推理速度排名。费用按记录的 token 数乘当时标价估算,没有核对实付账单。
截至 9 月 20 日,Jev 官方标价为每百万输入 token 0.042 美元,输出免费。免费的是输出部分,一条请求里带的材料和规则仍计入输入。官方价格(https://docs.typesafe.ai/models)
如果每次只省一点调用费,却需要人工花时间纠正分流错误,这笔账可能并不划算。我会把回退调用和人工处理一起记下来,再比较改造前后的总费用。
四、置信度高,仍然要看判错了什么
开头那条消息返回的 confidence 是 1,看起来很让人放心。但这一条成功,只证明示例跑通了。
我把批量结果里 confidence 不低于 0.9 的答案单独拿出来看,出现了两个很不一样的结果:
| Jev的高置信度子集 | 条数 | 与标签不一致 | 子集准确率 |
|---|---|---|---|
| 新闻分类 | 180 | 68 | 62.22% |
| 句对推断 | 147 | 9 | 93.88% |
同一个阈值,换一个任务,留下的错误比例差别很大。新闻栏目本身有模糊边界,不能把 68 条全部简单理解为模型犯了明显错误;但它足以说明,把“0.9以上自动执行”当通用规则并不可靠。
官方的解释是,confidence 来自选项概率分布:概率集中在一个选项上,置信度就更高。它描述模型在这些选项之间的确定程度,不能直接读成这条答案有多少正确率。官方 Confidence 说明(https://docs.typesafe.ai/confidence)
接入时,我建议先让 Jev 只记录建议,不改变原流程。这通常叫影子运行:用户看到的结果仍由现有系统处理,你在旁边比较两者的判断。
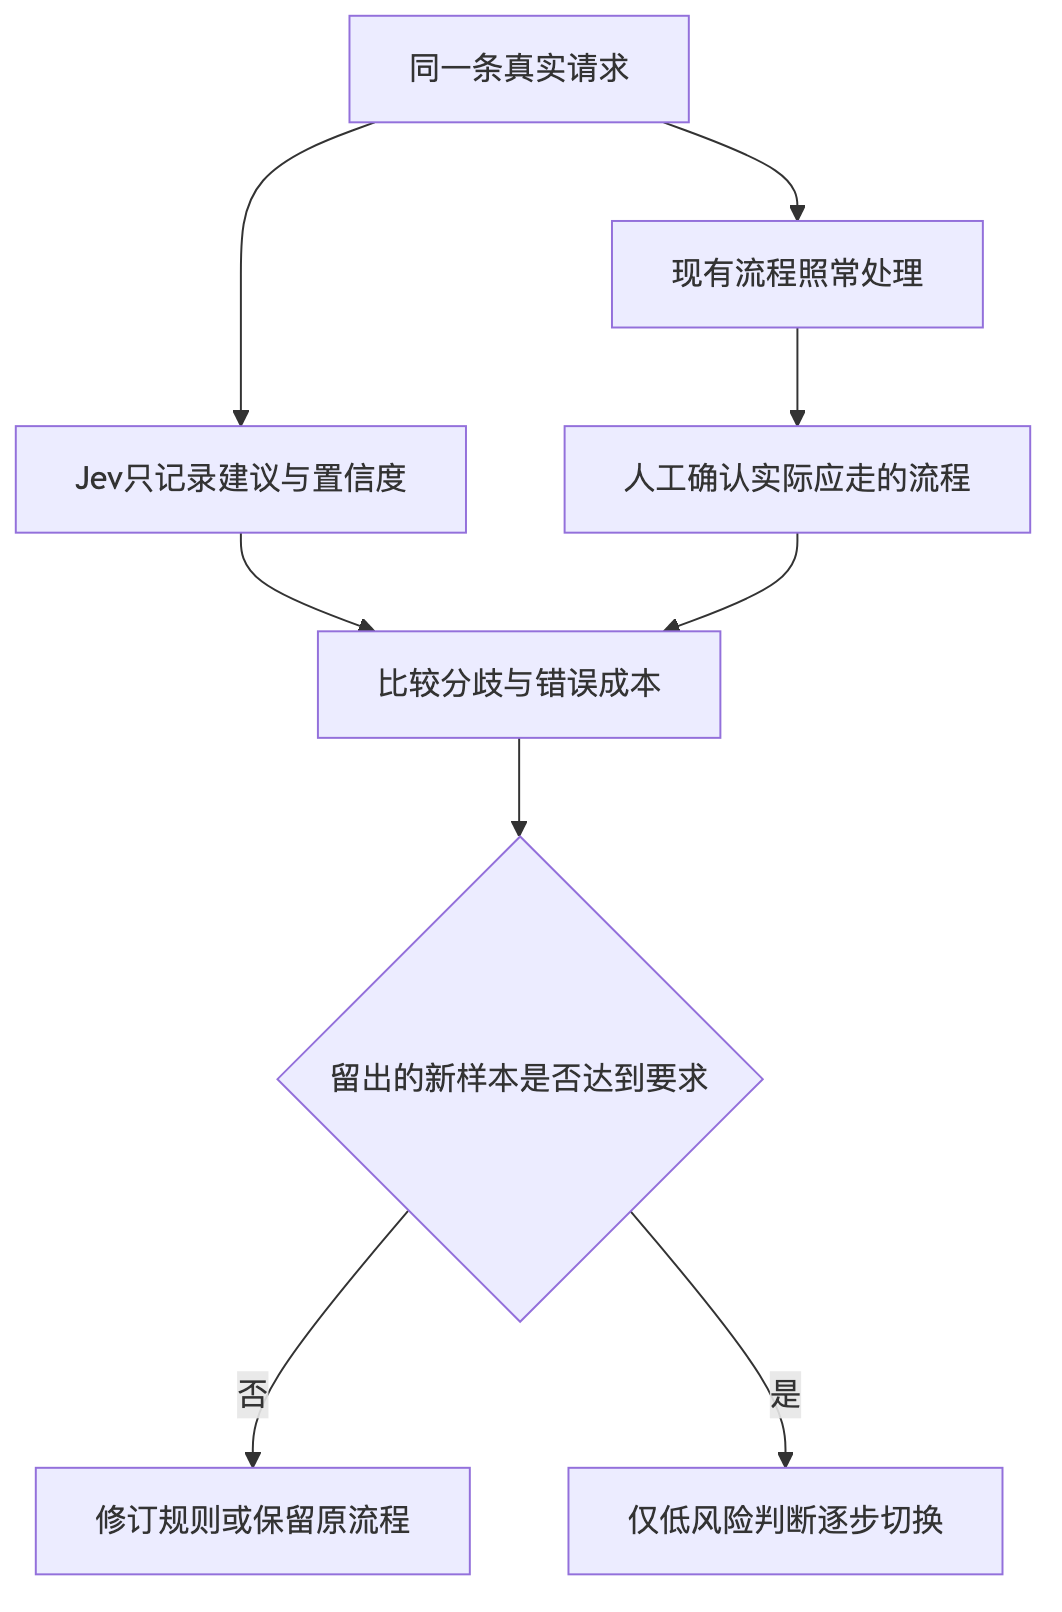
我会按下面的顺序做一次小范围接入:
| 步骤 | 具体动作 | 留下什么 |
|---|---|---|
| 定义问题 | 只选一处判断,写清候选项及交叉情况 | 人工能重复使用的分类规则 |
| 准备样本 | 收集真实请求,覆盖常见、模糊和高风险情况 | 人工标签及分歧说明 |
| 分开调试与验收 | 用一部分修题干、调阈值,另一部分留到最后 | 未参与调参的验收结果 |
| 计算实际收益 | 合并模型调用、失败回退和人工处理 | 每条任务的总耗时与总费用 |
| 小范围切换 | 仅放开通过验收的低风险分支 | 可回退的配置和持续抽检记录 |
不要用同一批样本一边调规则,一边证明规则有效。上面的 0.9 也是测试结束后回头分析的分界线,我没有把它当成经过独立验证的上线参数。
超时、限流、结果缺字段,也应该有明确处理:回到原流程、排队重试或交给人工。返回失败不能默认当成“允许执行”,高风险动作继续走既有审批。
此外,官方边界页还提示了字面理解、多层间接推理、无关长上下文、对抗内容和规则互相矛盾等问题。分别问正反两个问题,也不能指望结果自动互补。我的处理原则是缩小材料范围、把问题拆清楚,再由代码检查组合结果。能力边界与建议(https://docs.typesafe.ai/model-jaggedness/jev-1.13)
五、现成项目怎么选,先分清三条路
查 Jev 相关项目时,容易把“调用 Jev 的工具”和“自己实现类似接口的模型”混在一起。它们解决的是不同问题。
按你当前要解决的事选择入口,先别把三条路线当成同一种产品。
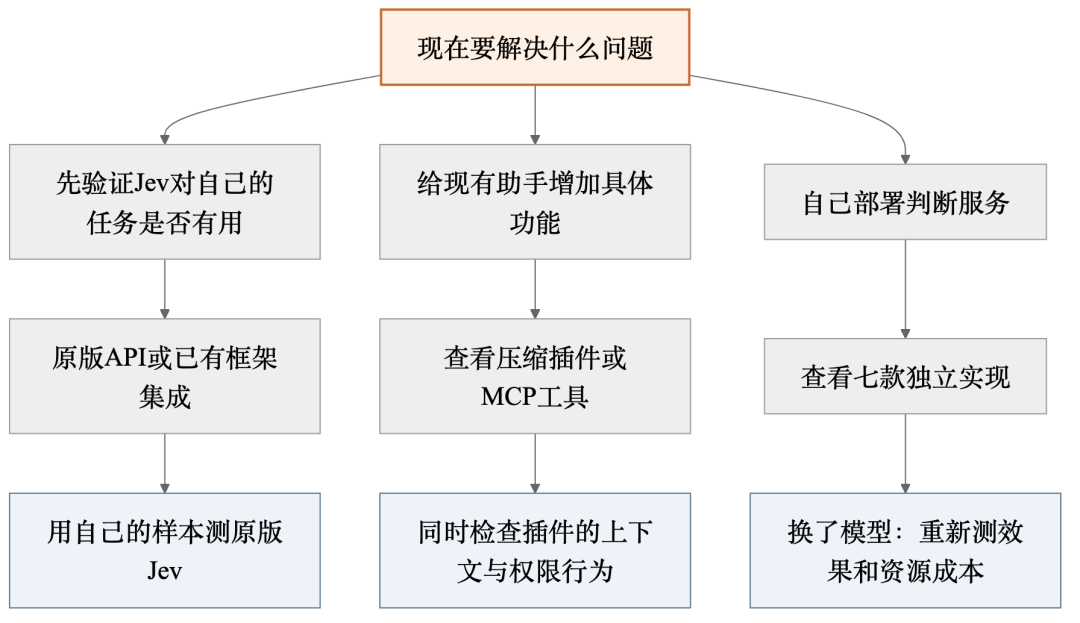
想先验证用途,就直接调用原版服务。 TypeSafe 有自己的 API;本文跑通的是 OpenRouter 上的 Jev。已经使用 LangChain 的项目,也可以查看 langchain-typesafe 的 TypeSafeClassifier 接法,无需为了 Jev 重做整个 Agent。LangChain 接入说明(https://www.langchain.com/blog/building-a-harness-with-jev)
想找具体产品形态,可以看插件。 例如 fast-jev-compaction(https://github.com/tamaratran/fast-jev-compaction) 用 Jev 评估工具调用及结果,决定哪些保留、丢弃或截短;jev-mcp(https://github.com/jkudish/jev-mcp) 则把判定能力包装成 MCP 工具。本轮只核对项目说明,未安装评测。尤其是删减上下文的工具,要检查有没有把后续任务需要的信息一起丢掉。
想本地部署,则要接受模型已经换了。 下面这七个项目使用各自的开放模型或实现。表里整理的是作者文档披露的路线,不是七款产品的性能排名。
| 项目 | 文档披露的主要路线 | 可以优先了解什么 |
|---|---|---|
| SemIf | 用开放模型实现语义判断,含 Apple Silicon 的 MLX 路径 | 在自己机器上做判断的实现方式 |
| NanoJev | 0.6B 并行决策模型,提供训练相关资料 | 小模型如何组织多项决策 |
| kev | Qwen 系列模型,提供兼容接口和不同大小的权重 | 更换后端时如何保留调用形式 |
| openjev-sglang | Qwen 模型加 SGLang,示例部署使用 B200 | 有算力预算时的服务部署方案 |
| openjev | DiffusionGemma 加 vLLM,同时提供文本生成接口 | 在同一后端提供判断与生成服务 |
| jeff | 400M 参数 GLiFormer,支持本地运行 | 小模型自托管路线 |
| simple-jev | 从兼容开放模型的分数构造分类与评分结果 | 使用已有开放模型做结构化判定 |
项目完整地址:
SemIf:
https://github.com/TheoLeeCJ/SemIf
NanoJev:
https://github.com/TianyuCodings/NanoJev
kev:
https://github.com/jaredpalmer/kev
openjev-sglang:
https://github.com/ekzhang/openjev-sglang
openjev:
https://github.com/razorback16/openjev
jeff:
https://github.com/logan-markewich/jeff
simple-jev:
https://github.com/featherless-ai/simple-jev
SemIf 的 README 明确说了,它复现的是接口模式,没有复现 Jev 未公开的模型和训练。理解其他同类项目时,也要逐一检查基座、限制和测试方法,不能把本文原版 Jev 的成绩移植过去。SemIf 项目说明(https://github.com/TheoLeeCJ/SemIf)
选自托管时还要算常驻资源、启动等待、并发和维护时间。对于调用量不大的个人项目,先用已有接口验证这一步是否值得做,再考虑搬到本地,能少走一段部署流程。
六、下一次测试,留下这些记录
打开你现有 Agent 的调用记录,找一处反复出现、最终只返回标签或是否判断的请求。保留原来的处理方式,把同样的输入复制给 Jev,先看两边在哪些真实例子上意见不同。
如果分歧来自规则没写清楚,先改规则;如果 Jev 在你关心的样本上达不到要求,就保留原模型;如果它能稳定完成这一步,再把回退费用算进去,决定是否切换。
本轮最值得继续追的还有多问题场景:官方支持同一份 state 上并行评价多个问题,这次批量测试的每条请求只问一个问题,还没有验证这项收益。等单项判断验收通过,再测试把相关问题合并成一次请求。官方模型说明(https://docs.typesafe.ai/models)
如果继续测试,记录你选中的判断步骤、现有模型的结果、Jev 的结果,以及每一次回退原因;下一轮针对这些分歧修改规则,再用留出的样本验收。
资料核对及实测日期:2026年9月20日。批量测试采用 TNEWS、OCNLI 和 ChangeMore 提示词攻击识别集的抽样数据;结果限于本文题干、配置与样本。
数据集完整地址:
TNEWS:
https://github.com/CLUEbenchmark/CLUE
OCNLI:
https://github.com/CLUEbenchmark/OCNLI
ChangeMore:
https://huggingface.co/datasets/CTCT-CT2/ChangeMore-prompt-injection-eval
JOTO 企业落地观察
- 企业部署决策模型时,不应仅关注接口格式统一性,而需将「判断标准显式化」作为工程起点——如文中客服分流示例中对“发票+报错”交叉情形的明确定义,这直接决定了模型能否替代人工规则引擎。
- 智能体工程中引入 Jev 类专用模型,本质是将传统 Agent 的「单一大模型串行处理」解耦为「判断-执行-生成」三阶段流水线;企业需同步重构监控体系,对每个阶段的失败率、回退路径与人工干预点进行独立埋点。
- RAG 知识工程若采用 Jev 做资料筛选,其效果高度依赖原始 chunk 的语义粒度与问题表述的精确性;文中指出“别把整本手册塞进去问哪些重要”,提示企业必须前置投入知识切分策略与 query 重构规范建设。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们