别再往 CLAUDE.md 里加规则了:任务专用 Agent harness 的五层搭法
本文基于 Google 研究者参与的 Harness² 论文(arXiv 2610.14224),系统阐释 Agent harness 的五层结构:常驻提示、skill、脚本、子 Agent 和 hook。指出过度依赖 CLAUDE.md 导致上下文预算耗尽、规则被忽略等问题,并强调需通过基线对照与独立验证器评估改动效果,避免‘越改越差’。
Agent 不听话时,大多数人的第一反应是往 CLAUDE.md 里再加一条规则。一篇 Google 研究者参与的论文给了另一个思路:
- 常驻提示只留每个任务都要的几行;
- 流程进 skill,判对错进脚本;
- 长阅读交给子 Agent,硬规则写成 hook;
- 每次改动都和基线对照,用独立的验证器打分。
文末用一个前端多语言文案的小例子,把这五层搭了一遍。
一、为什么 CLAUDE.md 越写越长,Agent 反而越不听话?
用 Claude Code 或 Codex 久了,很多人都有一份越来越长的 CLAUDE.md 或 AGENTS.md。
Agent 改了不该改的文件,加一句「不要动 package-lock.json」。它忘了跑测试,再加一句「改完必须跑测试」。几个月下来,几十条规则。
问题是,这份文件每一步都会发给模型。规则越多,模型每一步要读的说明就越多,留给它自己思考和输出的预算就越少。
而且写在提示词里的规则,模型可以不看。它注意力一分散,「不要 push」照样可能被忽略。
这里先讲清一个词:harness。
harness 直译是「马具」,在这里指模型外面的那一整套东西:系统提示、工具、记忆、skill、子 Agent、各种拦截规则,以及把它们串起来的循环。
模型是马,harness 决定它往哪儿跑、能碰什么、什么时候停。Claude Code、Codex、OpenCode 各自带了一套默认 harness。
默认 harness 要照顾所有人,所以对你手上的具体任务,它不一定是最好的。
论文里有一组对比:同一个模型 Gemini 3.5 Flash,分别放进 CodeBuddy、OpenCode、Codex、Claude Code 四个现成 harness 里跑。
结果没有谁处处领先:Claude Code 在编码和办公文档上最好,Codex 在网页任务上领先。
换句话说,harness 本身就是一个可以调的变量。往 CLAUDE.md 里加规则,只是调它最粗的一种办法。
二、harness 由哪几层组成,每层该放什么?
先交代来历。这篇论文叫 Harness²: Recursive Agent Harnessing for an Open World,2026-10-09 提交到 arXiv。
作者署名是 Google Cloud AI Research 和美国西北大学(Northwestern University)。代码放在 GitHub 的 google-research 组织下,Apache-2.0 协议。
README 末尾写明「This is not an officially supported Google product」。所以准确的说法是:Google 研究者参与的研究项目,不是 Google 的官方产品。
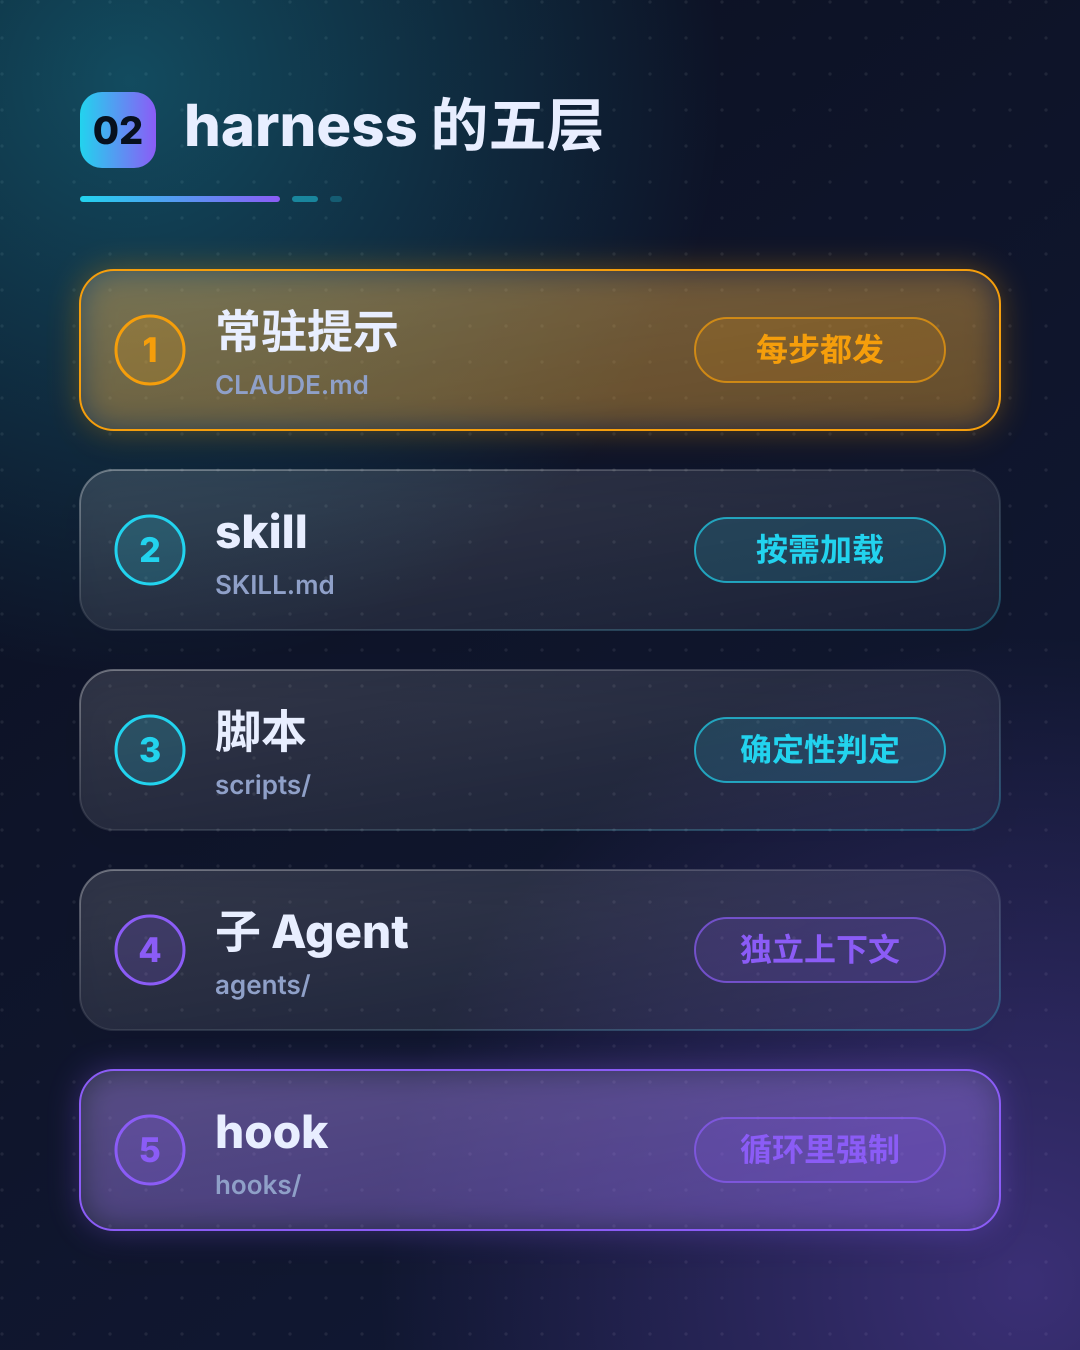
论文把 harness 拆成 8 个可以改的文件。Remy 那篇解读按它们什么时候进入模型的视线,归成了五层,我们沿用这个讲法。
第一层:常驻提示。 系统提示、硬性约束、长期记忆、工具用法说明,都属于这一层。它们每一次调用都会发给模型。
论文提到,在 Codex 里这一层就是 AGENTS.md;在 Claude Code 里,对应的是 CLAUDE.md。
第二层:skill。 skill 是一份「做某类事的操作手册」:步骤、检查项、约定。
平时只有一行简短描述挂在那里,任务需要时才把全文加载进来。不用的时候,几乎不占上下文。
第三层:脚本。 能用代码判对错、算数的事,写成一个小脚本,让 Agent 去运行,而不是让模型一个 token 一个 token 地「想」出来。
比如核对几百个单元格、对两个 JSON 的 key,脚本每次给出的结果都一样。
第四层:子 Agent。 子 Agent 就是主 Agent 派出去的一个「助手」,有自己独立的上下文窗口。
它去读一大堆材料,只把结论交回来。主 Agent 的上下文里不会塞进原文。
第五层:hook。 hook 是挂在工具循环上的一段普通程序。在 Claude Code 里,它可以在工具调用前、调用后、Agent 准备结束时自动运行。
它是让模型「记住」规则,而是在规则被违反时直接拦下来。
论文给改 harness 的那个模型写了一份很长的提示词,里面把这几层的取舍讲得很直白。
常驻文字是最贵的选项:每个字每一次运行都在上下文里,和 Agent 自己的输出预算抢位置。
而这类任务里代价最高的失败,恰恰是「推理到预算耗尽,什么都没交付」。多加说明文字,只会让这种失败更常见。
所以它给了一个优先顺序:
- 有明确触发场景的流程,默认写成 skill;
- Agent 手算算错了、或者算得很慢的确定性操作,写成脚本;
- 输入很大、答案很小的调查,交给子 Agent;
- 工具循环里反复出现的机械问题,用 hook(论文里叫 plugin)处理;
- 常驻文字放最后,只给真正每次都适用的短规则。要加一句,就删掉一句。
关于子 Agent,它还特意提醒:子 Agent 看不到主对话,只交回文字。所以只有「输入大、答案小」的活才划算,输出和输入一样大时就不值得。
关于 hook,原话是:「Prose can be stopped reading; a hook cannot.」文字可以被跳过不读,hook 不行。
论文附录里有一个例子:一个研究型任务里,Agent 一直查资料直到时间快用完,文件还没写。
改进后的 harness 加了一个 plugin:连续若干次工具调用都没有产出文件,就往工具结果里追加一条警告,催它收尾。
这就是一个「看门狗」式的 hook。后面的前端例子里,我们会照着做一个。
三、改了 harness,怎么知道是真的变好了?
拆完五层,下一个问题马上就来:我改了一处,怎么知道是变好了还是变坏了?
先讲两个词。
基线:改动之前的那个版本。拿同一个任务,用旧 harness 跑一遍,结果就是对照的参照物。
验证器:一段给结果打分的程序,判断交付物合不合格。关键在于,它不能是被调的那个 Agent 自己写的。
为什么要强调这一点?因为 Agent 给自己写检查脚本时,很容易把自己的错误假设也写进检查里。自己出题自己批改,当然全对。
论文要解决的正是更难的版本:真实任务往往没有标准答案,事先也没有现成的验证器。
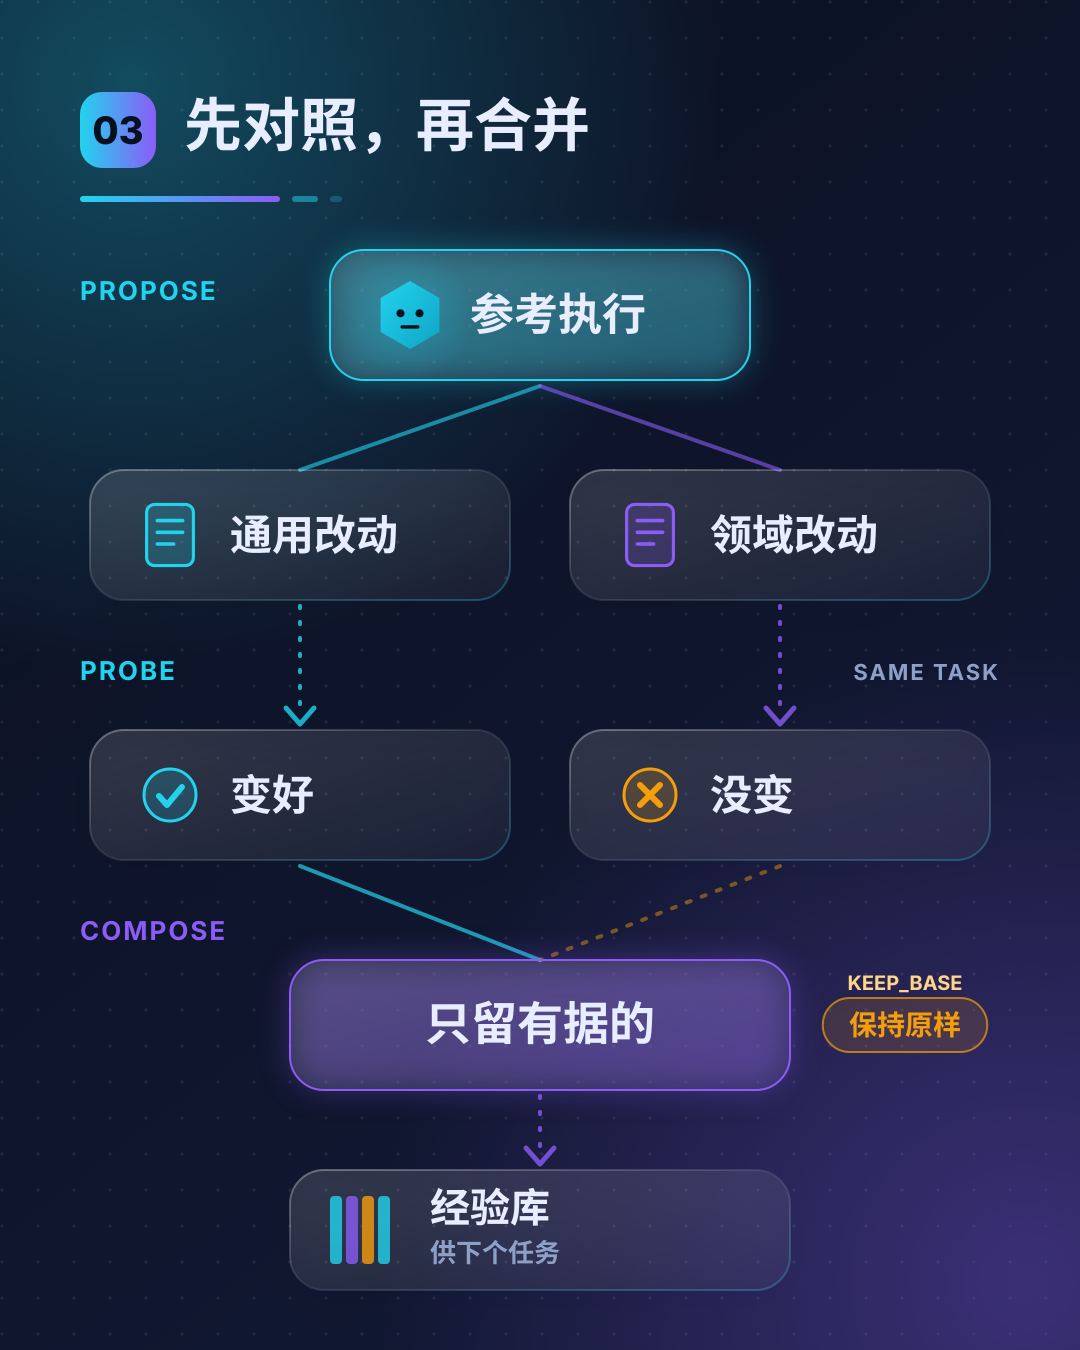
它的办法叫 Propose–Probe–Compose,三步:
Propose(提议):先用当前 harness 跑一遍,得到一次「参考执行」。它不说明答案对不对,只暴露 harness 在哪儿卡住了。
然后两个编辑器读这份记录:一个改通用流程,比如规划、工具使用、上下文管理;另一个以领域专家的身份,补领域规则。
Probe(试跑):两个候选 harness 在同一个任务、同样条件下各跑一遍,和参考执行对比行为。
Compose(合成):只合并能对上某个具体失败的改动;没有一个改动帮上忙,就保持原样。
论文的提示词里管「保持原样」叫 KEEP_BASE,并说它「是一个真实的答案,不是失败」。
这里比的是行为,不是哪个答案读起来更漂亮。比如参考执行漏算了一笔,候选版本补上了,这条改动才有依据留下。
如果跳过对照,直接让模型改 harness 会怎样?
论文做了这个实验:不给参考执行、不试跑、也不给经验库,直接改。在 WorkBuddy-Bench 上,Gemini 3.5 Flash + OpenCode 这组设置下:
- Code 子集从 73.4 掉到 63.2;
- Web 子集从 69.9 掉到 65.0。
Remy 的解读把这件事写成「成绩掉 10%」。按论文原文,是 Code 子集掉了约 10 分,不是整体掉 10%。
经验怎么带到下一个任务?
论文名字里的平方,指的是第二层递归:每个任务做完,系统会回顾这次改动,把有执行对比支持的教训写进一个按领域分的经验库。
经验库里存的是完整的组件文件,加一份 EXPERIENCE.md,说明为什么选它、解决了什么反复出现的问题。
下一个任务仍然从通用的基线 harness 开始,只按需参考经验库,不直接继承上一个任务调出来的那套。
原因很简单:为任务一高度定制的 harness,放到任务二上可能反而碍事。
论文仓库带了一个离线 demo,不需要模型凭证,用确定性的编辑器加真实的 Python 执行。我们在本地跑了 --k 2,约 1.3 秒跑完。
输出显示:2 个账本任务都完成;两种递归模式合计 28 次执行、32 次编辑器调用。
并行模式下,每个任务的执行目录正好是 base、inv(通用改动)、dom(领域改动)、agg(合成)各 2 份,就是上面三步的形状。
第一个任务结束后,经验库里多了 1 条经验,第二个任务开始时就能读到。那条经验大意是:
- 线索:账本里同时有收入和支出时;
- 教训:汇总脚本里两种符号都要算进去;
- 依据:去掉「只算正数」的过滤后,试跑的总额补上了参考执行漏掉的那几笔。
这只是 demo,但它把「只留有执行证据的改动」这件事,具体到了一行 diff。
四、论文的数字说明了什么,又没说明什么?
先看主结果。论文在三个专业基准上测:WorkBuddy-Bench(办公、网页、代码)、JobBench(职业工作)和 Harvey 的法律基准 LAB。
只做一步 Propose–Probe–Compose,GLM-5 和 Gemini 3.5 Flash 在所有配置下都有提升:
- WorkBuddy-Bench 最多提升 11.5 分;
- JobBench 最多提升 4.5 分;
- LAB 的部分通过率最多提升 11.8 个百分点。
有一个结果常被引用:一步之后,GLM-5 在 WorkBuddy-Bench 上达到 75.7(OpenCode)和 75.3(Codex)。
这高过了 Gemini 3.5 Flash 在对应默认 harness 下的 72.4 和 74.5。论文的说法是:harness 改进后的较弱模型,可以超过用原始 harness 的较强模型。
和现成 harness 比:同样用 Gemini 3.5 Flash,从 OpenCode 出发、预算 k=5 时,Code、Web、Office 分别比最强的现成 harness 高 4.6、5.8、4.9 分。
论文也注明,这用了额外的测试时算力。
再看哪一层贡献最大。论文从改好的 harness 里分别拿掉某一组组件:
- 拿掉 skill,Code 和 Web 掉得最多(3.6 和 6.9 分);
- 拿掉脚本,Office 掉得最多(7.4 分)。
这和第二节的直觉一致:流程类知识靠 skill,表格类的核对靠脚本。
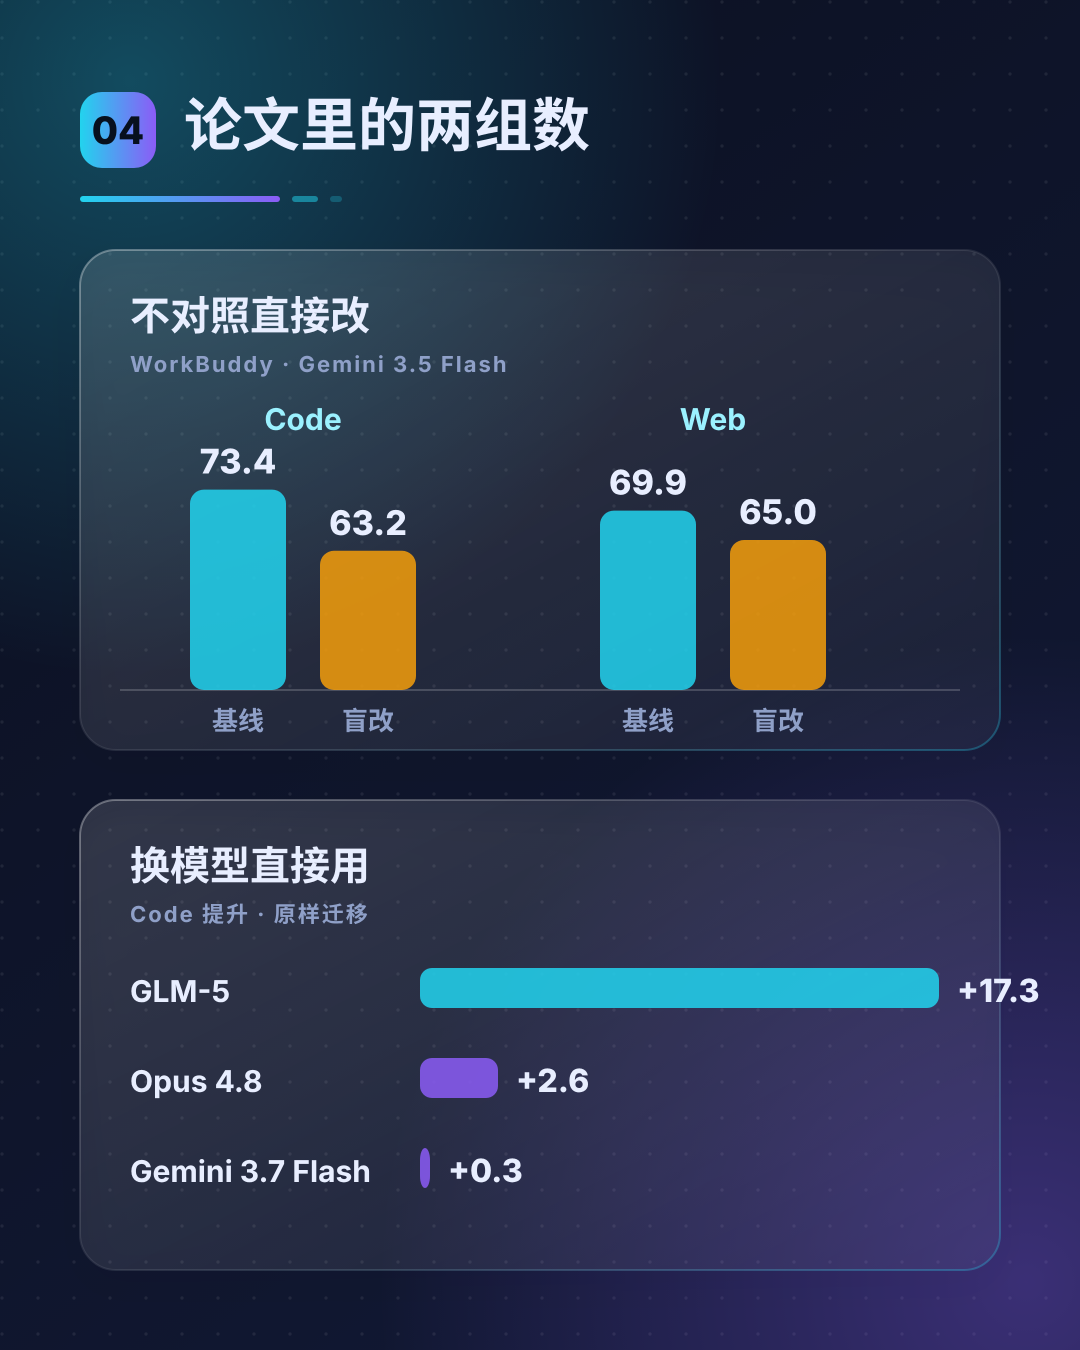
还有一组数关于「换模型」。把为 Gemini 3.5 Flash 调好的 harness,原样交给另外三个模型:
- GLM-5 在 Code 上提升 17.3 分(58.5→75.8);
- Gemini 3.7 Flash 在 Code 上只提升 0.3 分,Office 提升 6.4 分;
- Claude Opus 4.8 在 Code 和 Office 上分别提升 2.6 和 1.1 分。
三个模型都有提升,但差别很大。论文原话是「收益随执行模型和领域变化很大」。所以「调一次,哪个模型都受益」这种说法,要打个折扣。
论文自己也写了局限:
- 递归要额外的执行和编辑器会话,预算越大越贵;
- 没有标准答案时,判断靠行为对比和模型判断,会受随机波动和共享的模型偏差影响;
- 附录列了 9 个变差的案例,其中一个是 55 分的输出被选中,95 分的落选。
论文的应对建议是:选择时兼顾覆盖面和精度,试跑时去质疑共享的假设,并用重复执行区分改动效果和随机波动。
五、放到前端项目里,五层怎么搭?
论文里的执行器跑在 OpenCode 和 Codex 上。下面是我们把同样的思路搬到 Claude Code 上的一个最小示例。
任务很小:一个 Vite + React 项目,src/locales/ 下有 en.json 和 zh.json,中文少了一个 key cart.checkout。要求 Agent 补齐中文文案。
为了让完成门有东西可拦,这个缺口是我们故意留的。
常驻提示只有 5 行。下面是精简后的样子,意思和原文件一致:
# 前端示例(常驻提示,保持 ≤15 行)
- Vite + React + TypeScript,用 npm
- 只改 src/,不动锁文件和 .env*
- 改 UI 文案走 skill i18n-check
- 读长日志交给子 Agent log-reader
- Stop hook 校验不过,不要说完成
每次想往这里加「永远不要做 X」时,先问一句:这条能不能变成 skill 的一步,或者一个 hook?
skill 叫 i18n-check。description 写清什么时候用:新增或修改 UI 文案、出现 t('...') 调用、用户提到翻译时。
正文只有四步:运行脚本、读输出、只补缺的 key、再跑一遍直到通过。
脚本 check-i18n.mjs 放在 skill 目录里,比较各语言文件的 key 集合,查空值和 TODO。通过退出码 0,不通过退出码 1。
子 Agent log-reader 只给 Read、Grep、Glob 三个工具,用来读大段构建或测试日志,规定只交回一张不超过 15 行的错误摘要表。
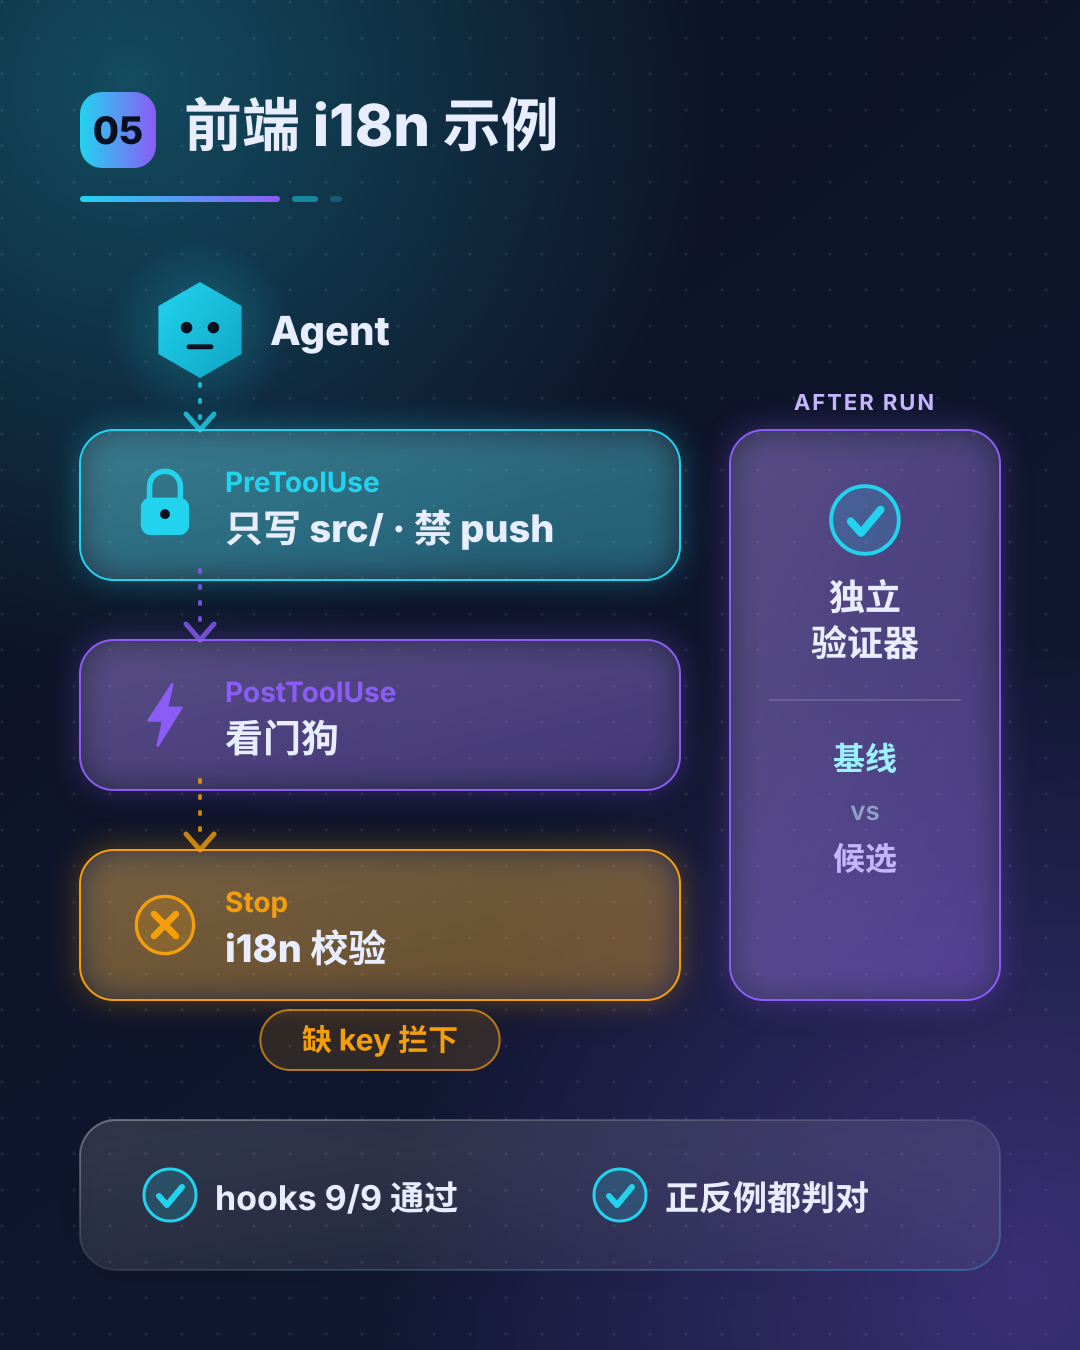
hook 有四个,写在项目级的 .claude/settings.json 里:
- 工具调用前(PreToolUse):Bash 里禁止 git push、npm publish 和改锁文件;
- 工具调用前:Edit/Write 只允许写
src/; - 工具调用后(PostToolUse):看门狗,连续 N 次调用没改
src/,就往上下文里塞一条提醒; - 结束前(Stop):完成门,i18n 校验不过就不让结束。
拦 push 的 hook 核心就几行(简化后):
cmd=$(jq -r '.tool_input.command')
if grep -Eq 'git +push|npm +publish' \
    <<<"$cmd"; then
  echo "禁止 push/publish" >&2
  exit 2  # 2=拦下,stderr 给模型看
fi
exit 0
注意退出码。按 Claude Code 文档,exit 2 才是拦下;exit 1 属于「非阻断错误」,工具照样执行。
我们还给策略类 hook 加了 "onFailure": "block"。这样脚本路径写错、崩溃或超时,也是拦下,而不是放行。
完成门的核心逻辑(简化后):
in=$(cat)
# 已被拦过、正在续跑,就放行
[[ $(jq -r .stop_hook_active \
    <<<"$in") == true ]] && exit 0
node check-i18n.mjs src/locales \
  || jq -n '{decision:"block",\
      reason:"i18n 校验未通过"}'
stop_hook_active 为 true,表示 Agent 已经是因为 Stop hook 在续跑。不查这个字段,条件永远满足不了时就会一直卡住。文档里另有连续续跑 8 次的上限。
不开模型,先测 hook
hook 是普通脚本,可以像单元测试一样测:把 Claude Code 会喂给 hook 的 JSON 手工喂进去,看退出码和输出。
我们写了 9 个用例,实跑结果:
PASS bash: git push 被阻断
PASS bash: npm run build 放行
PASS bash: 删锁文件被阻断
PASS write: src 外被 deny
PASS write: src 内放行
PASS watchdog: 3 次无产物后提醒
PASS watchdog: 写 src 后计数清零
PASS stop: zh 缺 key 时阻止结束
PASS stop: stop_hook_active=true 放行
--- 9 passed, 0 failed
完成门被触发时,输出的 reason 里会列出具体问题:zh.json 缺 cart.checkout。Claude Code 会把它交给模型,让它接着修。
再确认 Claude Code 真的会加载这套配置。claude --init-only 只跑启动阶段的 hook,不开会话、不调模型。
我们临时挂了一个 SessionStart hook 把收到的 JSON 存下来。结果:hook 被调用了,事件名是 SessionStart,来源是 startup;调试日志里显示加载了 1 个项目级 skill。
PreToolUse、PostToolUse 和 Stop 要在真实的模型会话里才会触发。这三类我们没有做端到端运行,只用上面的模拟输入测过。
独立验证器和基线对照
最后是打分。eval/verify.mjs 和 skill 里的校验脚本是两份独立实现,而且多查了两件事:英文原文没被改、只改了 src/。
我们手工构造了一正一反两个工作区来测它。反例在中文里写了 TODO,还改了 vite.config.ts。输出整理如下:
$ node eval/verify.mjs ws-bad .
 no_placeholder: false
 only_src_changed: false
 pass: false  (exit=1)
$ node eval/verify.mjs ws-good .
 pass: true   (exit=0)
正例是正确补上了「去结算」。两个结论都判对了。
基线对照脚本 eval/run.sh 也写好了:同一句任务提示,旧 harness 和新 harness 各跑 N 次(默认 5 次),每次从干净副本开始,用这个验证器打分。
这一步要真实的模型会话,我们还没跑,所以这里不给通过率。
用的时候,一次只改一处。比如候选版本只多了一个完成门,然后去看每次是哪条检查没过,而不只是看通过了几次。
六、常见坑
- 每次失败都往 CLAUDE.md 加一句。 常驻提示每一步都发,越长越容易把预算耗在读说明上。新知识优先放 skill、脚本或 hook。
- 把要强制的规则只写在提示词里。 文字可以被跳过,hook 不能。真正不能破的规则,写成 hook 或权限配置。
- hook 用了 exit 1。 那只是非阻断错误,工具照样执行。要拦就用 exit 2 或返回 deny 的 JSON,再加上
onFailure: block。 - Stop hook 没查 stop_hook_active。 条件修不好时,会话会一直被拦着续跑。
- 不对照基线就保留改动。 论文里跳过对照直接改,Code 子集从 73.4 掉到 63.2。
- 让 Agent 自己写的检查器来判分。 它会把自己的错误假设写进检查。打分要用独立的验证器。
- 每个任务只跑一次。 单次结果有随机性,论文的失败案例里就有选错候选的情况。重复几次再下结论。
- 评测时 Agent 能上网、能读到评分材料。 仓库文档记录过,一个 Codex 执行未经指示就下载了公开的评分细则。仓库默认不限网,要自己加限制。
- 把上个任务的 harness 直接继承下去。 论文的做法是每个任务从干净基线出发,只按需取经验库里的东西。
- 以为换个模型也一样受益。 迁移收益从 0.3 分到 17.3 分不等,要在自己的模型和任务上重测。
七、要点清单
- harness 是模型外面的那一整套东西,它本身就是可以调的变量;
- 同一个模型换个 harness,各领域的强弱就变了;
- 常驻提示只留每个任务都要的几行,要加一句就删一句;
- 有触发场景的流程写成 skill,能用代码判的写成脚本;
- 输入大、答案小的阅读交给子 Agent,只收回结论;
- 必须遵守的规则写成 hook:调用前拦截、调用后看门狗、结束前完成门;
- hook 先用模拟输入单测,策略类 hook 用 exit 2,并设 onFailure: block;
- 每次改动都和基线在同一任务上跑多次,用独立验证器打分;
- 只合并能对上具体失败的改动,没有就保持原样;
- 评测时限网、藏好评分材料;经验按领域入库,新任务从干净基线开始。
结语
回到开头的问题:CLAUDE.md 越写越长,Agent 反而越不听话,怎么办?
答案不是写得更好,而是少写一点,把规则放到它该在的那一层:流程进 skill,判断进脚本,长阅读进子 Agent,硬规则进 hook。
然后,每改一处,都拿基线和独立验证器对一下。论文里最有用的一课也许就是这个:不对照就改,可能越改越差。
前端示例的完整文件见附件,可以复制 .claude/ 目录到自己项目的一个新分支上试。
参考链接
- Harness²: Recursive Agent Harnessing for an Open World(arXiv 2610.14224,2026-10-09)https://arxiv.org/abs/2610.14224
- google-research/harness2(代码、README、docs/EXPERIMENTS.md)https://github.com/google-research/harness2
- Remy:How to Build a Task-Specific Agent Harness (Skills, Hooks)(2026-10-27)https://goremy.ai/blog/articles/how-to-build-task-specific-agent-harness-skills-hooks
- Claude Code 文档:Hooks reference https://code.claude.com/docs/en/hooks
- Claude Code 文档:Create custom subagents https://code.claude.com/docs/en/sub-agents
- Claude Code 文档:Agent Skills https://code.claude.com/docs/en/skills
*本文为学习整理,论文和原文版权归各自作者所有;文中前端示例为我们在本地的实测结果。*
JOTO 企业落地观察
- 企业部署 Agent 系统时,若将全部业务规则堆入常驻提示,会导致上下文膨胀、推理预算快速耗尽;Harness² 提出的分层机制,为企业提供了可工程化落地的轻量级治理框架——将高频共性规则保留在常驻层,领域特异性逻辑下沉至 skill 与 hook,既保障稳定性,又支持按需演进。
- Hook 作为强制执行层,其价值不在于替代模型推理,而在于建立不可绕过的安全边界;对企业而言,这意味着可将合规红线(如禁止访问生产数据库、禁止外传敏感字段)固化为可测试、可审计的独立程序模块,而非依赖模型“自觉遵守”的脆弱提示。
- Propose–Probe–Compose 方法论强调基线对照与独立验证器,这对企业智能体工程具有直接指导意义:任何 harness 调优都必须绑定可复现的任务实例与客观验证逻辑,避免陷入“主观觉得变好”的经验主义陷阱,为 RAG 知识更新、Agent 行为迭代提供可度量的闭环验证路径。
- 论文指出 harness 迁移收益因模型与任务而异,这对企业 FDE 驻场共创提出关键提醒:不存在开箱即用的最优 harness 配置;必须在客户真实数据、真实工具链、真实 SLO 要求下,通过小步对照实验(而非一次性大改)持续收敛出适配其技术栈与业务语义的 harness 分层方案。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们