关于Jev的一点浅见
Jev是由TypeSafe AI发布的结构化判断模型,不生成文本,仅执行Choice/Score/Noul三类原子判断,延迟70–500ms,输入成本约$0.042/百万token、输出免费,宣称比主流LLM快40–200倍、便宜40–400倍。其适用场景聚焦高频、窄范围、结构化决策,已在浏览器自动化、邮件分类、游戏实时控制、Agent监督、大规模数据过滤等领域出现上百个开源Demo。
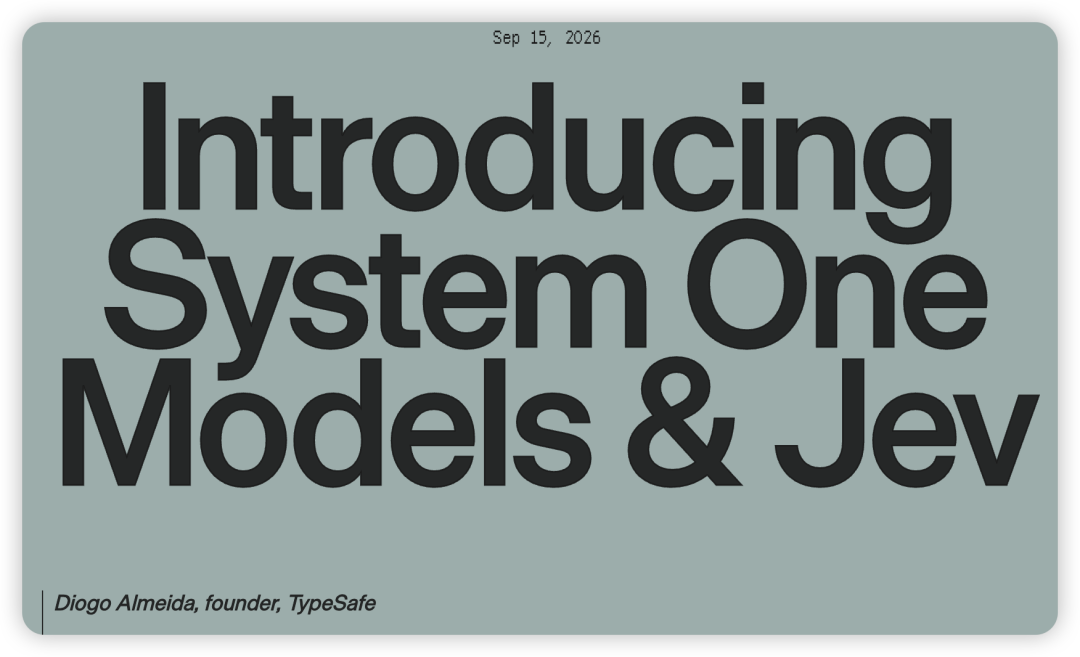
本周业界讨论最热烈的话题无疑是Jev,它是一个由TypeSafe AI(前 OpenAI 研究员 Diogo Almeida 创办)发布的号称“System One”模型。
Jev不生成文字,只做结构化判断,包括Choice 选择、Score 打分、Noul 是非概率,延迟 70–500 ms,输入约 $0.042/百万 token、输出免费,号称比目前主流生成式LLM 快 40–200 倍、便宜 40–400 倍。
一、使用场景
社区在Jev发布后 3–4 天内迅速出现了大量实验,GitHub 上已有上百个公开案例,如 JackZeng/Jev_apps 收集了 100+ 个高赞Demo:
1. Browser/Computer Use自动化(最火讨论最热烈)
- Browser Use Ultrafast:Jev 每步从页面 DOM 元素中选下一步操作(点击/输入等),需要文字时再调用小 LLM。示例 ”苏黎世→伦敦“ Google Flights 搜索约 7.1 秒、$0.0039,成为标志性 demo。
- 语音控制浏览器:说话 → 转写 → Jev 判断动作 → 浏览器执行,单次决策约 $0.0002、~300 ms。
- Computer Use 低成本加速:Stagehand 结合无障碍树、Cua 受限动作菜单、Mac 桌面 OCR + Jev 点击、并行浏览器对抗测试、Amazon 商品筛选等。
2. 邮件 / 工单分类与路由(实用性强)
- 分类场景:对 1700 封邮件同时判断类别、优先级、垃圾邮件概率、是否需要回复,总成本约 18 美分。
- 客服场景:一封邮件同时判断部门、紧急程度、退款风险、是否需人工介入。高置信度可直接自动处理。
3. 游戏实时决策(展示低延迟)
- 官方/社区 Doom Demo:约 10 Hz 调用,每小时成本约 $7。
- Super Mario:直接从模拟器 RAM 提取对象 JSON,无需截图。
- 毫秒级决策案例:俄罗斯方块、Wikiracing、1v1 FPS(约 9 Hz 判断移动/瞄准/开枪)、Subway Surfers 并行等。游戏成为最直观的“毫秒级决策”案例,这个方向感觉可以很快在实际产品看到。
4. 交易 / 量化决策 (高风险场景,慎用)
- jev-trader:Jev 根据价格数据每区块(约 300 ms)判断买/卖,在 Monad 链上 Kuru 订单簿真实下单,模型延迟约 81 ms。
- 流动性池毒性流判断、均值回归等(多为 advisory 模式)。
5. Agent 监督、代码审查与安全防护
- 代码审查(jev-review):对 Git diff 做分阶段风险判断 + 本地仪表盘。
- Agent 监督(Foreman、pi-warden 等):检查任务是否完成/卡住/偏离、工具调用是否危险。
- 上下文压缩:用 Jev 决定保留/删除内容,避免传统摘要的信息损失。
- 安全:Prompt Injection 检测(准确率自报 96.5%)、工具调用防火墙、内容 moderation。
6. 大规模数据分类与过滤
- 新闻/内容 triage:一天选别约 1 秒、$0.001。
- 其他分类:儿童零食评分(3000 条约 28 秒、$0.11)、PostgreSQL 自然语言 WHERE 过滤、社交媒体帖子筛选(去诱饵/广告)、论文标题摘要筛选等。
其他一些Promising的Demo
- 模型/工具路由:决定下一个调用哪个 LLM 或工具。
- 无人机:摄像头状态 → Jev 建议动作(安全由代码保证)。
- 实时交互:像素级画画、NPC 模拟等。
二、适用场景共性
从本周的各种案例看,大家重点是把 Jev 当作“软件里的快速分拣员/决策原语”,与LLM 分工协作:Jev 负责高频小判断,LLM 负责生成/规划。成本与速度优势让“对所有数据跑一遍”的老大难问题变得可行。
需要注意的是,目前都还是Demo为主,相信很快会有真实使用的案例出现。
这些 Jev 使用场景的共性可以归纳为以下几点:
1. 核心都是「高频、窄范围的结构化判断」
所有场景几乎都不是让模型“写文章、写代码或聊天”,而是反复回答类似「选哪个」「打几分」「是或否」的问题。
Jev 被当作软件内部的快速决策原语(Choice / Score / Noul),输出带校准概率的结构化结果,直接被代码消费。
2. 对延迟和成本极度敏感
- 浏览器操作、游戏、交易、实时 Agent 监督等,都需要毫秒级响应(70–500 ms)。
- 邮件分类、大规模数据筛选、内容过滤等则需要大量并行判断,单次成本必须压到极低(往往 $0.0001–0.001 量级)。
现有LLM 在这些场景下要么太慢,要么太贵,Jev 正好填补了这个空白。
3. 「程序主导 + Jev 做局部判断」的架构模式可以快速实践
典型流程几乎一致:
- 程序准备当前状态(页面元素、邮件内容、游戏状态、代码 diff、市场数据等)
- 向 Jev 提出一组预定义的类型化问题
- Jev 返回选择/分数/概率
- 程序根据结果和置信度决定下一步动作(执行、路由、升级人工、终止等)
Jev 从不主导全局逻辑,只负责原子判断;复杂的编排、执行、重试、安全边界全部由代码掌控。
4. 经常与传统 LLM 分工协作
很多热门案例都采用「混合架构」:
- Jev 负责高频小决策(选按钮、路由、过滤、评分)
- 传统 LLM 只在需要生成文字、做复杂规划或解释时才被调用
这样既能大幅降低成本和延迟,又能保留生成能力。
5. 置信度成为关键控制开关
几乎所有场景都利用 Jev 返回的概率/置信度做阈值:
- 高置信度 → 自动执行
- 低置信度 → 升级到更强模型或人工审核
这让系统在自动化程度和风险控制之间取得平衡。
6. 场景天然适合「批量 + 并行」
因为多个问题可以一次并行评估,且输出免费,所以社区很自然地把 Jev 用在:
- 对海量数据做 map-reduce 式判断
- Agent 循环中的每一步决策
- 实时高频控制回路
目前看,Jev适用的场景都把「判断」从昂贵的文本生成中剥离出来,变成软件可直接调用、毫秒级、低成本、带概率的结构化原语。Jev 最适合那些「决策本身简单但发生频率极高」的自动化环节。
三、对Agent应用的启发
Agent 应用更好利用 Jev 的核心思路是:
把 Jev 当作 Harness(执行框架/ harness)里的轻量决策层,而不是让它取代主 LLM。Jev 负责高频、窄范围、结构化的判断,主模型负责规划与生成。
1. Harness Engineering(最受关注的方向)
LangChain 创始人 Harrison Chase 提了一个观点:
“Jev isn’t meant for text generation, it’s for simpler constrained output. Turns out, that can actually be very useful when building a harness!”
社区也把 Jev 主要用在 harness 周围,而不是塞进 Agent 内部。
典型用法:
- 模型路由(Model Routing):每个 turn 开始前,用 Jev 的 Choice 判断“当前任务该用便宜快模型还是强模型”。LangChain 已进行了一些实验性 middleware(ModelRouterMiddleware),可按任务复杂度选模型,显著降成本。对于支持多模型的Agent产品来讲,意图分解和模型路同可能是一个提升margin的有效手段。
- Skill / Tool 选择:技能库很大时,先用 Jev 对所有可用 skill 打分/选择,只加载相关的,大幅缩小上下文。Hermes 等项目已集成 Jev 做 skill selection、memory filtering、compaction selection。
- 上下文压缩(Compaction):对 tool call 历史或记忆块做 keep/delete 判断(Noul),避免传统摘要丢失信息。需要注意的是,简单逐行过滤可能破坏模型原有的上下文理解,需要充分验证。
- 卡住检测 / 完成验证:判断 agent 是否重复同一策略、任务是否真正完成、输出是否有证据支持。
- 风险 Guardrail:在 tool 执行前用 Noul 检查“是否危险/不可逆/偏离意图”,高风险直接拦截或升级人工,如 AutoModeMiddleware、AgentGhost、pi-warden 等项目。
实践建议:Jev 只做“判断”,代码负责阈值和副作用。置信度低时自动升级到更强模型或人工。
2. 意图分类(Intent Classification)
非常适合 Jev 的 Choice / Noul。
- 客服场景:用户请求进来后,先问 Jev:“这是账号查询?产品问题?政策解读?高风险/模糊请求?”再决定走哪条路径。之前尝试过用各种形式化方式去做更好的Planning/Routing,现在有了真正可用的手段。
- 可并行问多个问题(紧急程度、是否需要人工、是否 spam 等)。
- 也有人尝试用在语义路由,如 Hono + Jev 的中间件,直接用自然语言定义路由规则,而不是硬编码 path。
如果可靠性有保证,从效果上看收益会是“毫秒级 + 极低成本”,比用 生成式LLM 做分类便宜几个数量级。
3. 路由(Routing)
包括任务路由、模型路由、sub-agent 路由、异常路由。
- 任务/请求路由:把请求分到不同 handler / 工作流 / 人。
- 多 agent 路由:在并行跑多个 coding agent 时,决定哪个 agent 接手子任务,或用置信度做“多数表决”式权限控制。
- 级联路由:简单请求 → 便宜模型;复杂/低置信度 → 强模型或人工。
社区常见模式是“Cascade”:Jev 先做快速分诊,再决定是否需要调用昂贵模型。
4. 工具策略选择(Tool Selection / Strategy)
- 工具调用前:用 Choice 从封闭工具集里选最合适的工具,或判断“是否需要调用工具”。
- 工具执行时:工具执行前再做一次风险检查,是否 irreversible、是否匹配用户意图等。
- 工具执行后:工具结果回来后:判断结果是否足够、是否需要重试、是否继续。
AgentGhost、各种 MCP 封装等多个项目尝试把 Jev 包成“工具调用前的语义防火墙”,输出 ALLOW / ASK / DENY。
四、借力Jev的简单原则
- 只做原子、有界判断:问题设计成预定义选项,不要让 Jev 生成文本或做复杂推理。
- 并行问多个问题:一次调用同时拿意图、风险、复杂度、是否需要工具等结果,成本几乎不增加。
- 置信度驱动策略:高置信度自动执行,低置信度升级,这是 harness 可靠的关键。
- 代码拥有最终控制权:Jev 返回概率和选择,程序决定阈值和动作。
- 与主 LLM 明确分工:Jev = 快速反应的System 1,生成式主模型 = 深度思考的System 2。
- 先在 Harness 的一些边界层探索:入口意图分类、每步工具守卫、模型路由、完成检查,这些地方可能是 ROI 最高。
JOTO 企业落地观察
- 对企业部署意味着,Jev 类模型可作为轻量级决策层嵌入现有系统边界,替代部分传统规则引擎或小型分类模型,尤其适用于需毫秒级响应且判断维度固定的场景,如客服工单初筛、API 请求准入控制、前端交互状态跳转等,降低对大模型的依赖和调用频次。
- 这类系统的取舍在于:必须严格限定输入结构与输出空间,无法处理开放域推理或生成需求;企业需重构原有流程,将‘判断’从主逻辑中解耦为独立服务调用,并建立基于置信度的降级机制(如自动升至LLM或人工),这对工程鲁棒性提出更高要求。
- 在智能体工程中,Jev 提供了一种新的Harness分层范式——将高频原子判断下沉为可并行、低成本、带概率的原语,使Agent主循环更聚焦于长程规划与语义理解;但这也要求团队具备清晰的决策边界划分能力,避免因过度拆分导致状态管理复杂度上升。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们