不是所有任务都需要 Agent:Dify 里 Agent 与 Workflow,到底该给 AI 多少自由?
本文厘清 Dify 中 AI Agent 与 Workflow 的本质区别:核心在于“谁决定下一步”——是运行时模型,还是构建者预定义。提出三类方案(纯 Agent、纯 Workflow、混合模式),并通过员工 IT 报障真实场景对比其适用性。强调上线前需对齐结果、边界、质量与归属四要素,并给出可落地的测试与扩量方法。
开场:你可能根本不需要 Agent
这是当下 AI 应用开发里最普遍的浪费——一上来就搭 Agent。
现实是:一次性任务,普通 AI 对话就够了;流程已知、规则明确的任务,工作流自动化往往更靠谱;只有当工作会反复发生、需要判断力、并且有一个你可以评估的明确结果时,Agent 才真正派上用场。
更关键的一句话是:最强的使用场景,从来不把一切都交给模型。它们把模型的灵活性,与预定义的流程、质量检查、人工监督绑在一起。
对 IT 与 AI 平台团队来说,这个选择决定了四件事:这套方案好不好解释、好不好测试、好不好维护、以及在别的团队依赖它时值不值得信任。
一、一句话讲清差异:谁决定下一步
先把定义摆平:
- AI Agent:模型能理解目标、从可用的工具或动作中做选择、并根据结果继续推进。对"如何达成结果",模型拥有裁量权(在给定准则内)。
- Workflow(工作流):按事先设计好的步骤执行。它同样可以用 AI——分类请求、抽取信息、起草回复——但顺序与条件由应用构建者定义。
所以,二者的分界线不是"有没有用 AI"(两者都能用),而是:
谁决定下一步?是工作流构建者,还是运行时的模型。
记住这一句,后面所有选型问题都是它的推论。
二、三种方案,一张表看全
| 方案 | 谁决定步骤? | 什么时候合适 | 主要设计关注点 |
|---|---|---|---|
| AI Agent | 模型根据上下文,从已批准的工具/动作中选择 | 路径因请求而异,且无法提前完整枚举 | 限制选项、权限与暂停条件 |
| Workflow | 构建者定义顺序、逻辑与分支 | 流程可重复,且规则已知 | 明确写出异常分支与失败路径 |
| 混合(Hybrid) | 工作流划定边界,Agent 作为其中一个节点处理特定可变步骤 | 大部分流程可预测,只有一处需要灵活的工具选择 | 让 Agent 的角色保持窄小且可观测 |
第三种模式,是当下生产环境里最被低估、也最实用的一档。
三、跑一遍真实场景:员工 IT 报障
假设员工报告"某个业务系统进不去了"。IT 团队希望:定位问题 → 找到相关指引 → 准备下一步动作。
| 选项 | 在本例中怎么做 | 谁掌控流程 |
|---|---|---|
| AI Agent | 员工描述问题。Agent 检索已审批的文档、追问澄清问题,并自行判断是给出已知修复方案,还是准备一张工单。 | 模型基于请求、技能与上下文,在被允许的工具和后续动作中选择。 |
| Workflow | 员工填写表单。应用校验必填项、对请求分类、检索匹配的帮助文档,再通过预定义分支返回指引或生成工单。 | 团队在运行之前设计好步骤与条件。 |
| 工作流中的 Agent 节点 | 工作流先校验请求并检索上下文;Agent 节点决定调用哪个已批准的诊断工具并返回摘要;工作流检查结果,必要时转人工复核,再路由或建单。 | 模型只在 Agent 节点内部选择动作;前后发生了什么,由外围节点控制。 |
看出差别了吗?第三种模式的价值在于:大部分流程是可预测的,但恰好有一步需要"人类式判断"。
在 Dify 里,这两种组织方式都能落地:你可以把 Agent 建成独立应用,也可以把它作为 Agent 节点嵌入工作流。后者让团队保留一份可共享的 Agent 能力,同时在每条工作流里为它定义聚焦的任务与下游检查。
四、什么时候该用 Agent
在 Dify 中构建 Agent,当且仅当:
- 工作反复发生,且有清晰目标;
- 每个请求都需要被理解(而不是被套模板);
- 下一步依赖上下文,无法提前写死。
建的时候做三件事:
- 给足上下文——知识库、历史、用户身份,别让模型裸奔;
- 给一份克制的工具白名单——工具越多,跑偏的面越大;
- 提前约定人怎么复核、错了怎么办——这是上线前的必答题,不是事故后的补救。
五、什么时候该用 Workflow
当流程遵循一份 SOP,有固定步骤和决策点,就用工作流。工作流的作用,是把这份顺序显式化——画出来、说出来、能评审、能交接。
在 Dify 里,不同节点各司其职:分类请求、抽取细节、检索知识、起草回复、条件分支、代码执行、迭代循环……逻辑一目了然,可测试、可调试,可跨团队交付。
一个务实的判断标准:如果你能画出这张流程图并让同事点头说"对,就这么做"——那它就是 Workflow,别再纠结。
六、什么时候该用"Workflow + Agent 节点"
当 SOP 大部分固定、只有一步需要判断力时,就该上混合模式。
一句很好用的类比:Workflow 做骨架,Agent 做关节。
- 刚性留在需要刚性的地方:校验、权限、预算、审计、最终的写操作;
- 灵活出现在重要的地方:选哪个检索源、怎么拆解问题、要不要再查一轮。
设计纪律只有一条:Agent 的角色要窄、要可观测。 一旦 Agent 节点开始"顺手"改写数据库、发邮件、下订单,你就该把它拆出来,外面套一层确定性流程。
七、上线前的四问清单
动手之前,和使用这个应用的团队对齐四件事:
- 结果(Outcome):什么算一个好结果?
- 边界与鉴权(Boundaries & authentication):谁能用、怎么认证、每个用户能访问哪些工具和数据、哪些动作必须审批?
- 质量(Quality):如何测试结果、错误与升级路径?
- 归属(Ownership):上线后谁维护这个应用及其知识?
第 4 问最常被跳过,也最常在三个月后爆炸。
八、扩量之前,先这样测 Agent
- 小测试集起步,且必须故意包含:表述模糊的请求、互相矛盾的信息、工具不可用的情况、以及超出范围的任务。
- 记录一个真正重要的指标:任务完成率、解决时长、正确升级率、或者需要多少人工修正——选一个,别全选。
- 成功和失败都要记录。只记成功案例的测试集,等于没有测试集。
- 早期动作保持低风险:让 Agent 先"建议"或"起草",等结果证明可靠,再逐步扩大它的权限。
九、一张决策捷径
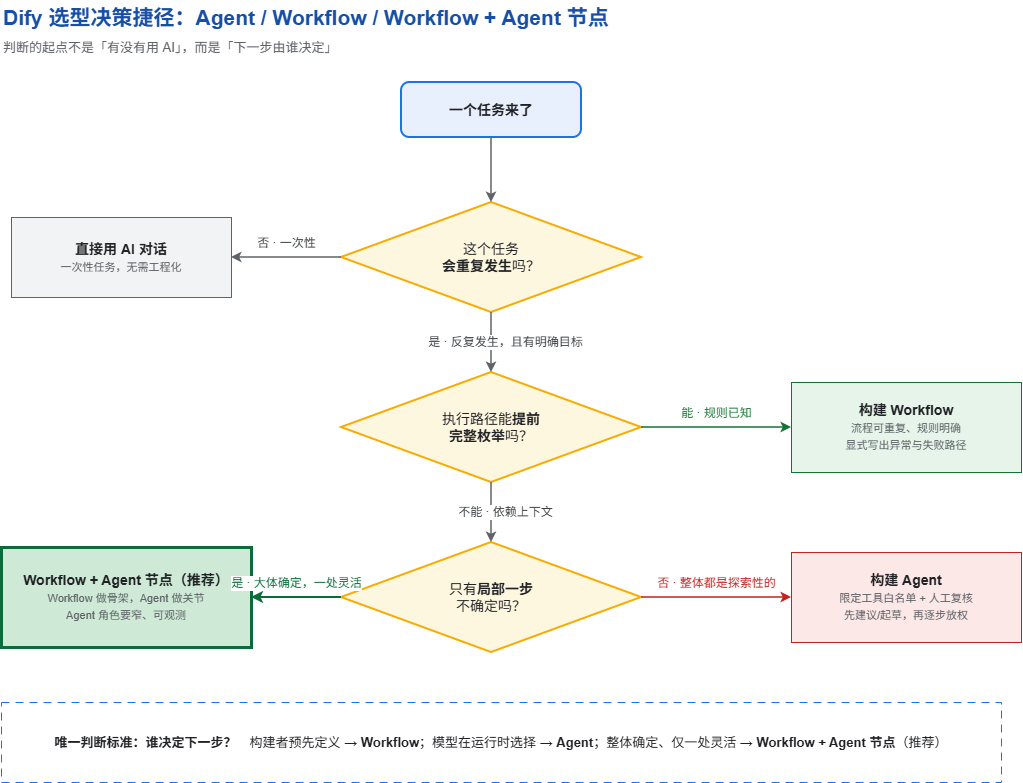
这个任务会重复发生吗?
├─ 不会,一次性 → 直接用 AI 对话
└─ 会 → 路径能提前完整枚举吗?
        ├─ 能,规则明确 → Workflow
        └─ 不能,依赖上下文 →
               ├─ 只有局部一步不确定 → Workflow + Agent 节点(推荐)
               └─ 整体都是探索性的 → Agent
十、三条给平台团队的建议
- 别让"是否用了 LLM"参与决策。 Workflow 里也能放 LLM 节点,Agent 也要靠工作流兜底——这个维度没有区分度。
- 副作用越大,控制权越要前移。 涉及写库、发信、付款、审批的动作,放进确定性流程,并加上幂等与人工审批。
- 从最小的可用版本开始。 选一个边界清晰的任务,用真实输入测过,再往外分享。
结语
真正难的问题从来不是"选 Agent 还是选 Workflow",而是——
你的系统里,哪些部分需要推理,哪些部分需要轨道。
这个问题会在 AI 系统设计的每一层反复出现。而越来越多的答案是:两个都要,但要仔细地组合。
在 Dify 里,这个判断的落地方式很直接:需要模型自主选择工具就建 Agent;步骤已知就建 Workflow;"大体确定、一处灵活"就用 Agent 节点。
选对了,你的应用逻辑就保持可见,团队也能清楚地说出自己的 AI 应用是怎么工作的。
JOTO 企业落地观察
- 企业部署 AI 应用时,不应以“是否启用 Agent”为技术选型起点,而应首先识别任务中“可预测性”与“需动态判断”的边界——这直接决定 RAG 知识工程中 chunk 粒度、元数据标注策略与重排序逻辑的设计优先级。
- 混合模式(Workflow + Agent 节点)对 FDE 驻场共创提出新要求:需在工作流编排层预留标准化接口,使 Agent 节点可被统一注入、替换与灰度,而非嵌入硬编码逻辑。
- “上线前四问清单”实质是将 AI 系统纳入企业 ITIL 流程的前置锚点;其中“归属”问题若未在智能体工程初期明确,将导致知识库更新滞后、工具权限漂移与审计日志断链等典型治理失效。
- Agent 节点的“窄小可观测”原则,倒逼企业在 AI 安全治理中放弃黑盒式日志采集,转向结构化动作追踪(如:工具调用 ID、输入上下文哈希、输出决策依据字段),为事后归责提供可验证证据链。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们