用 WorkBuddy 做 AIOps 的 10 个案例
本文梳理 WorkBuddy 在 AIOps 领域的 10 个真实案例,涵盖全链路根因分析(RCA)、数据库锁阻塞链还原、HTTP 200 但用户无响应的跨层诊断、WebShell 攻击链还原、主机入侵取证、Windows 蓝屏驱动指纹追溯、P0 事故时间线重建、带流量控制的一键发布、MySQL 混沌演练韧性分析,以及发布后数据异常回退定位。核心价值在于 Agent 作为编排与推理层,串联监控、日志、CMDB、云平台等已有系统。
WorkBuddy 的真正定位:AIOps 编排与推理层
如果只是拿 WorkBuddy 做服务器巡检、写 Shell、生成日报,其实有点低估它了。真正值得运维团队关注的,是把它放在监控、日志、数据库、云平台、发布系统和知识库之上,当成一个会分析、会调用工具、会组织证据的 Agent。
换句话说,更有想象力的方向不是让 AI 帮运维执行一条命令,而是让 AI 把原本需要 SRE、DBA、安全工程师和研发多人协作完成的故障分析流程串联起来。
我查了目前公开的 WorkBuddy 实战资料,挑出10 个比较有代表性的案例。
跨 CLB、CVM、MySQL、Redis 做全链路 RCA
这是目前我看到最接近标准 AIOps的 WorkBuddy 案例之一。
某内容平台出现发布失败,5xx 从 0.3% 升到 14%,数据库慢查询暴涨,同时两台后端节点被 CLB 临时摘除。传统排查需要分别查看负载均衡、8 台业务机、MySQL、Redis 等系统,再人工对齐时间。
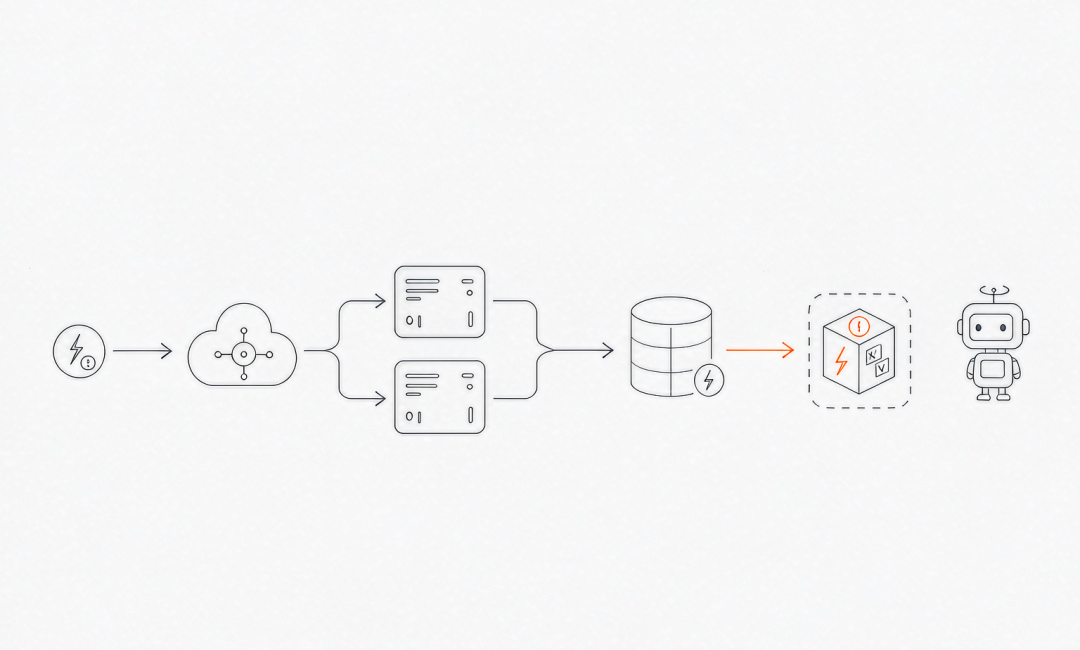
案例中的做法是让 WorkBuddy 调用 CloudQ,先根据架构关系确定故障涉及哪些组件,再把多个系统的日志统一到同一时间轴。最终发现:一个新的慢 SQL 先出现,随后连接池等待超时,接着应用 5xx 升高、节点健康检查失败,而 Redis 指标正常,可以从因果链中排除。
「这类场景真正有价值的地方,是把 AIOps 从看到异常,推进到了跨系统建立异常传播链。」
数据库锁事故自动还原 Blocking Chain
电商秒杀过程中,一条库存 UPDATE 卡住 13 分钟。排查数据库锁,最麻烦的通常不是查到「存在锁等待」,而是从 activity、lock 等多个系统视图里还原:谁持锁、谁等待、等待什么资源,以及最上游的 blocker 是谁。
作者用自己的锁现场采集工具抓取数据,再交给 WorkBuddy,把分散在多个视图中的信息拼成完整阻塞链,并进一步生成处置建议。
这个案例很适合改造成数据库 AIOps:采集工具负责事实,Agent 负责关联与解释,DBA 负责最后审批。
“HTTP 200 但用户没收到答案”的跨层故障诊断
这个案例是一次明确标注为真实生产事故脱敏回放的企业 Agent 故障。
表面现象很诡异:容器是 healthy,模型 API 也是 HTTP 200,但最终用户看到的却是「无法生成回答」,同时还有人怀疑机器人发生了跨群误投。
WorkBuddy 没有直接猜根因,而是把证据拆成容器状态、调用链、模型请求、SSE Chunk、Token、Transcript 以及消息投递记录几个层次,分别判断这个证据能证明什么、不能证明什么。
这种思路非常适合复杂分布式系统:AIOps 不一定非要马上给出唯一根因,更重要的是建立一条可审计、可复核的证据链。
从 WAF / NDR 日志还原完整 WebShell 攻击链
一位负责腾讯云、阿里云双云环境的安全工程师,公开分享过一个 ThinkPHP WebShell 攻击案例。
告警跨越约 4 个小时,单看某一条 WAF 或 NDR 告警很难判断攻击到底走到了哪一步。作者把多轮 HTTP 请求和响应日志交给 WorkBuddy,让它按照「攻击行为—影响范围—风险等级—处置建议」重新组织,最终还原攻击链路,并给出 WAF、CFW 等加固方向。
这实际上已经属于 SecOps 和 AIOps 的交叉场景:不是让 AI 判断「这是不是攻击」,而是把离散告警重新组织成一个事件。
不停业务,对可疑进程进行主机入侵取证
同一位安全工程师还记录过另一个更典型的场景:ECS 上发现一个可疑的 Go 静态编译二进制,监听 8081 端口,并向外发送疑似漏洞利用 Payload。
关键在于生产服务器不能随便 kill、restart 或 strace。
因此作者先给 WorkBuddy 设置production-safe边界,只允许使用 lsof、/proc、网络连接等只读方式逐步取证,而且要求每一步标注风险等级。
「Agent 不是权限越大越好,而应该把只读诊断、低风险操作、高风险变更做成不同授权层。」
Windows 蓝屏:从事件日志追到驱动包指纹
这个案例是Windows服务器,也是一个非常完整的终端运维案例。
一台 Windows 11 工作站三周出现26 次显示驱动超时和 3 次蓝屏。难点是「驱动版本号看起来没变」,单靠设备管理器很难证明驱动到底有没有真正替换。
作者让 WorkBuddy 串起 Windows Event Log、Minidump、LiveKernelReports、setupapi.dev.log、DriverStore、注册表以及 AMD 安装器日志,最后从「驱动版本」继续追到实际安装包和驱动包指纹。
这类方法完全可以迁移到企业终端 AIOps:不要只看状态,而要让 Agent 自动寻找能够证明状态发生过变化的底层证据。
217 条告警、变更与聊天记录,自动重建 P0 事故时间线
某电商 818 大促期间发生 P0 故障,90 秒内产生 217 条告警,最终定位到 coupon_rule 表索引失效。
真正耗时的反而是故障之后:告警 CSV、3 张变更记录表、8 页监控 PDF、180 条应急群消息、值班记录以及历史故障报告散落在不同地方。
WorkBuddy 的作用不是再做一次故障检测,而是把这些异构材料按「发生—发现—定位—恢复」重新建立统一时间线,同时把本次事故与历史故障进行对照,生成复盘材料。
这是 AIOps 经常被忽略的一环:Incident 结束以后,AI 继续负责把机器证据和人的操作记录合并成组织知识。
把人工 Runbook 变成带摘流量和回滚的一键发布
一个日订单数万的订单服务,有 3 台机器、systemd 和 SLB。过去每次发布都要按照 Runbook 手工执行:打包、SCP、SSH、摘流量、重启、健康检查、重新挂流量。
公开案例中,最近 10 次人工发布有 3 次因为漏步骤出现异常。作者把整套流程交给 WorkBuddy 做成发布 Skill,并实际做了发布和回滚验证。
约 4 分钟
单次发布耗时
约 3 分钟
回滚耗时
这里最关键的不是「一键执行」,而是把流量摘除、节点健康验证、逐节点发布、失败停止以及回滚全部变成受控状态机。这样的 Agent 才真正接近 ChangeOps。
MySQL 主节点故障演练,自动生成韧性分析
腾讯云公开过一个 SRE 混沌演练案例:模拟生产架构中的MySQL 主节点故障切换。
过去演练 45 分钟,整理日志、监控指标、故障注入过程和改进建议反而需要数小时。接入 WorkBuddy 与 CloudQ 后,可以直接通过架构图关联演练任务,自动拉取故障注入、恢复时间、监控指标和操作明细,再生成包含薄弱点和治理建议的复盘报告。
这意味着 WorkBuddy 还可以用在「事故发生以前」:通过持续演练,把历史演练结果逐渐变成系统自己的韧性知识库。
发布成功,但线上数据却从 11 条退回 6 条
最后一个案例很小,但思路非常典型。
某 Python 服务发布后,部署系统明确显示成功,但线上数据却从 11 条退回 6 条。最初怀疑是容器重启造成内存数据丢失,继续分析后发现数据其实存储在 JSONL 文件中。
WorkBuddy 沿着「为什么不是全部丢失,而是精确退回某个历史状态」这个矛盾继续追,最终定位到:部署器上传了整个项目目录,本地用于测试的 6 条种子数据把线上 11 条真实数据覆盖了。
「不要只盯告警,而要寻找现象之间不应该发生的矛盾,用矛盾缩小根因空间。」
做 AIOps,真正值得做的是什么?
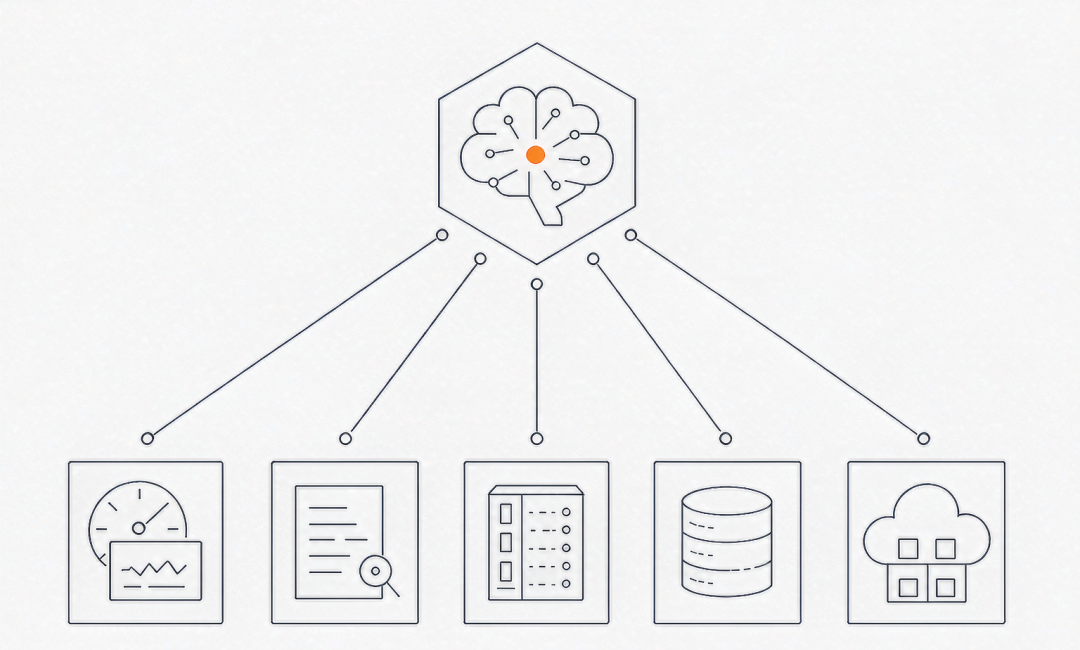
看完这些案例会发现,WorkBuddy 真正适合的并不是再造一个监控平台。
Prometheus 负责指标,日志平台负责检索,CMDB 负责资产,数据库工具负责采集锁,CloudQ 负责云资源和架构信息——这些系统本来就有自己的专业能力。
WorkBuddy 更适合站在它们上面,成为一个Agent 编排和推理层:
- 监控发现异常以后,它去确定影响范围;
- 日志很多时,它负责建立时间线;
- 多个系统同时异常时,它寻找传播关系;
- 要执行变更时,它按照风险决定是只读、审批还是执行;
- 事故结束以后,它再把告警、操作、聊天、变更和结论沉淀成知识。
JOTO 企业落地观察
- 对企业部署意味着,WorkBuddy 类 Agent 不应替代现有监控、日志或 CMDB 系统,而需作为轻量级编排层集成于其上。部署重点转向定义工具调用契约、时间轴对齐规则与跨系统因果推断逻辑,而非重复建设数据采集能力。
- 这类系统的取舍在于:是否将‘统一时间轴’‘阻塞链拼接’‘证据链审计’等推理能力固化为标准接口。若仅依赖大模型自由发挥,会导致分析过程不可复现;若过度预设规则,则丧失对未知故障模式的适应性。
- 对智能体工程而言,10 个案例共同指向一种分层设计:底层是只读取证工具集(如 lsof、Event Log 解析器),中层是状态机驱动的变更执行器(如发布/回滚),上层是基于矛盾识别的根因收缩器。三者权限与能力必须严格隔离。
- 在 AI 安全治理层面,案例中反复出现的 'production-safe' 边界设定、只读取证优先、风险等级标注等实践,提示企业需将 Agent 的操作权限模型化为可审计策略,而非依赖运行时人工干预。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们