TencentDB Agent Memory 深度解析:给 Agent 装上"不会失忆"的大脑
腾讯云推出的 TencentDB Agent Memory 是一款专为 AI Agent 设计的记忆引擎,支持短期、长期与团队三层记忆架构。其开源版基于本地 SQLite + sqlite-vec,云端版依托腾讯云 VectorDB;采用四层金字塔式长期记忆(L0-L3),支持混合检索与白盒溯源;实测显示 PersonaMem 准确率从 48% 提升至 76%,WideSearch Token 消耗下降 61.38%。
一句话定位:它是腾讯云(及其开源版本)为 AI Agent 打造的记忆引擎——把"对话、代码、文档、Skill"自动蒸馏成可检索、可溯源、可共享的记忆资产,让 Agent 跨会话、跨任务、跨团队越用越聪明。
一、档案卡片
| 项 | 内容 |
|---|---|
| 正式名称 | 云数据库 Agent Memory(TencentDB Agent Memory) |
| 出品方 | 腾讯云数据库团队(从底层完全自研) |
| 双重形态 | ① 腾讯云托管服务(SaaS,VPC 内网部署,控制台 + API);② MIT 开源项目 github.com/Tencent/TencentDB-Agent-Memory(本地优先,零外部依赖) |
| 核心能力 | 短期记忆 + 长期记忆(四层金字塔)+ 团队记忆,三层协同 |
| 检索方式 | 关键词 + 向量语义 + RRF 融合排序(混合检索) |
| 开源版存储 | 本地 SQLite + sqlite-vec(默认),数据不出本机 |
| 云端存储 | 腾讯云向量数据库(VectorDB)+ 文件存储 |
| 接入形态 | OpenClaw 插件 / Hermes 网关 / 自研 SDK(TS·Python)/ 独立 Gateway / 云端 API |
| 基准验证 | PersonaMem 准确率 48% → 76%;WideSearch Token -61.38%、成功率 +51.52% |
需要先把两个容易混淆的身份讲清楚:云端托管版是腾讯云卖给企业的 SaaS,数据存在腾讯云 VectorDB 上;开源版是同一套引擎的本地化实现,MIT 协议、完全离线、数据落在你自己的 SQLite 里。两者内核一致,差别只在"存哪、谁来管"。本文以开源版为主轴(因为它最能暴露工程细节),并在适用处标注云端的差异。
二、为什么 Agent 需要"记忆管理层"
大模型本身是无状态的概率机器。把记忆这件事丢给应用层"自己想办法",会撞上四个结构性矛盾:
- 上下文窗口天花板:长任务里工具日志、搜索结果、代码片段会迅速撑爆上下文,关键决策被挤出窗口。
- 会话失忆:每次新开会话都从"你是谁、你要什么"重新开始,用户要反复交代偏好。
- Token 飞涨:为了"不忘",朴素做法是把整段历史全量塞回 prompt,成本随对话长度线性甚至超线性增长。
- 团队经验孤岛:一个 Agent 踩过的坑、总结的规范,没法被同团队的另一个 Agent 或新成员直接复用。
TencentDB Agent Memory 的解法是把记忆抽出成一个独立底座,用"分层提炼 + 按需召回"替代"全量回灌"。它的口号式价值主张是:记住该记的,忘掉该忘的,并让记忆可审计。
三、三层记忆内核总览
整个系统自下而上分三层:数据底座 → 记忆内核 → 应用接入。记忆内核又由三块能力组成。
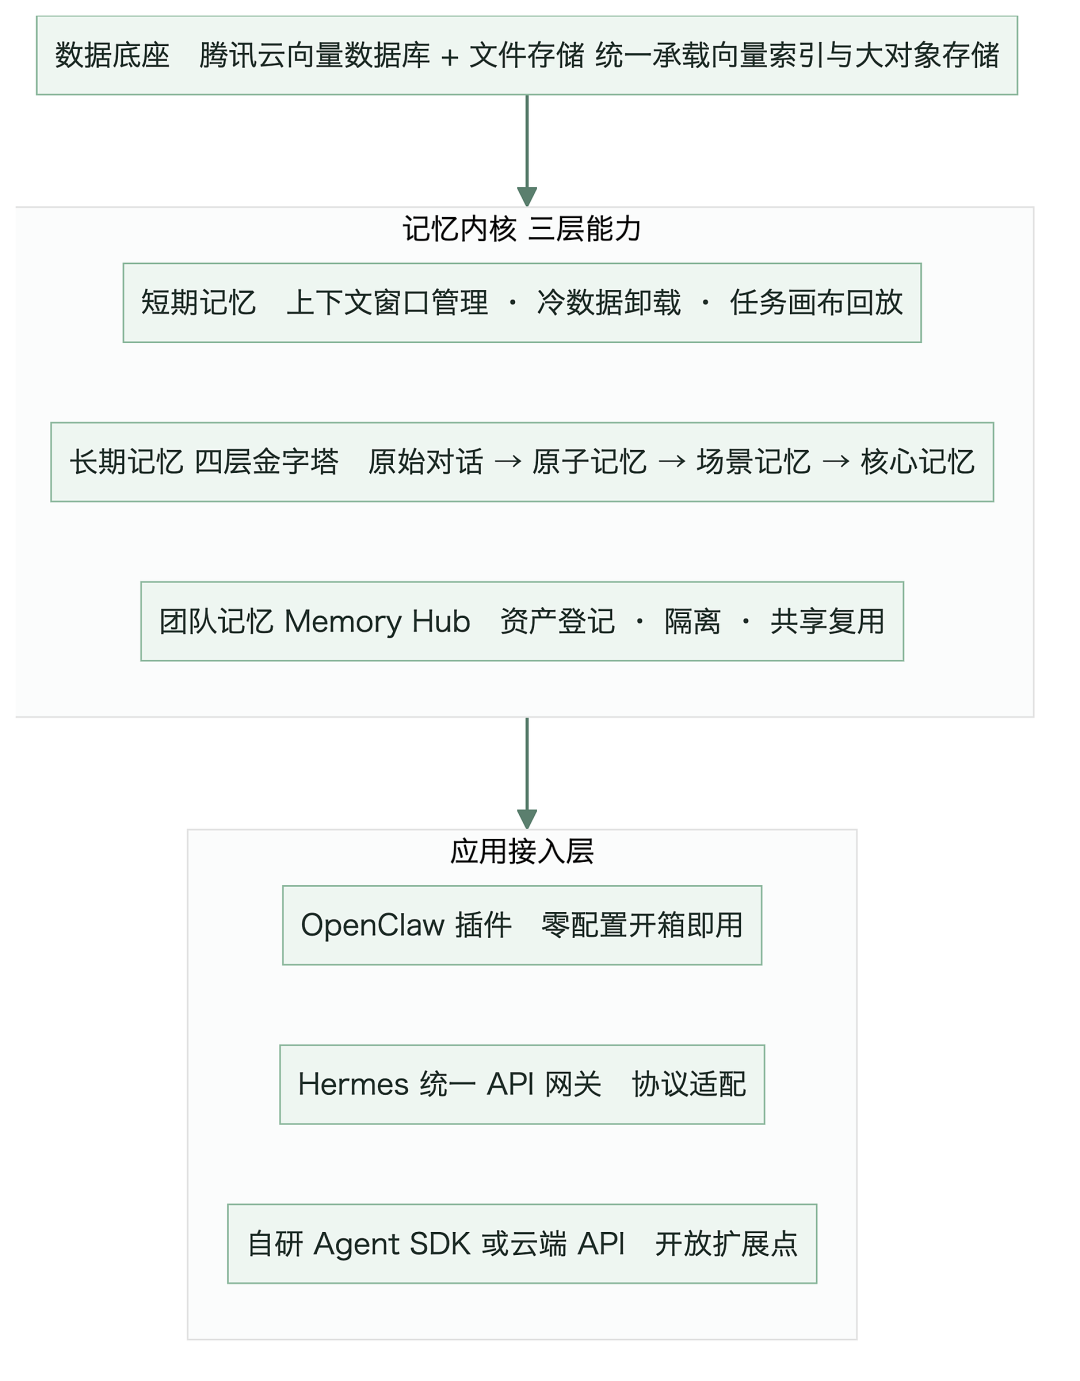
设计上最值得玩味的一点是:应用接入层与记忆内核解耦。无论是 OpenClaw、Hermes 还是你自己的 Agent,都只是"记忆内核"的不同客户端;换框架不改记忆逻辑。这和市面上一堆把记忆写死在 prompt 里的方案形成了鲜明对比。
四、短期记忆:把上下文"压"起来,而不是"堆"起来
短期记忆服务于当前任务窗口内的上下文管理,核心是三件事:
- 上下文窗口管理:在 Token 上限内保留与当前任务最相关的信息,避免关键上下文被截断。
- 冷数据卸载:上下文膨胀时,把暂时无关的历史片段卸载到持久化存储,释放窗口空间;需要时一键回调原文。
- 关键状态保留:识别并优先保留中间结果、决策分支、工具调用参数等关键节点,长任务中不丢进展。
短期记忆还有一个工程亮点——任务画布(Mermaid Canvas)。长任务的执行步骤被记录成一张可回放的 Mermaid 状态图,关键步骤能随时回放。这其实是把"过程"也当成一类可符号化存储的记忆,而不是只在最后沉淀结论。
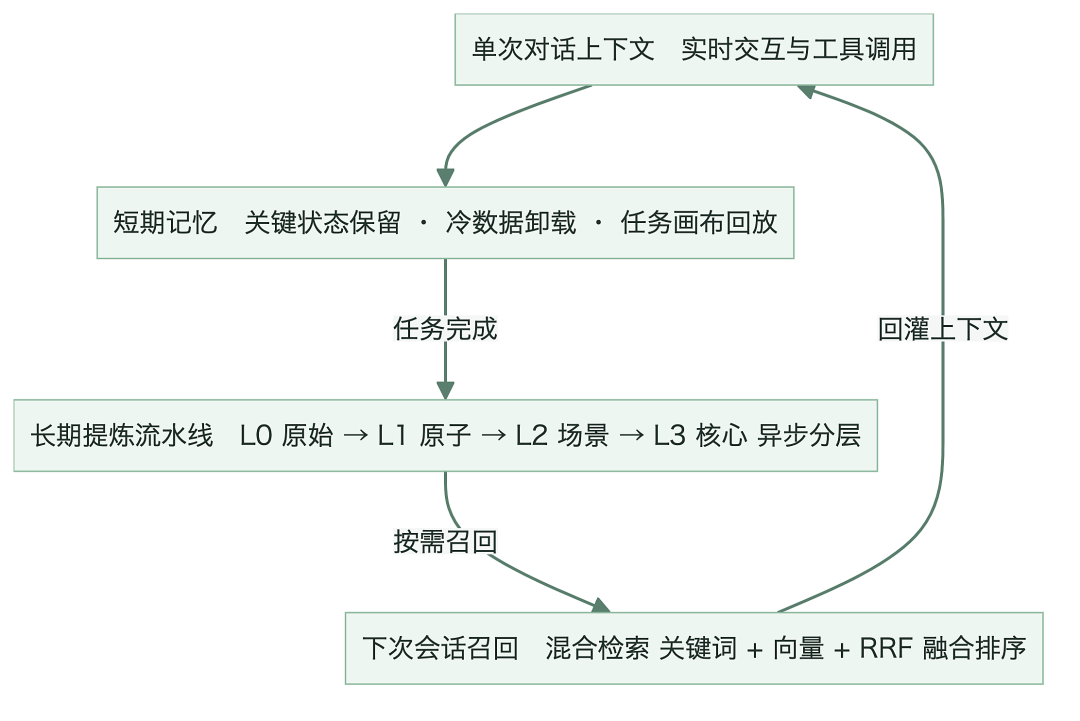
更关键的是:短期记忆是长期记忆的入口——一次任务完成后,短期记忆里有价值的信息会自动进入长期记忆的分层提炼流水线。
五、长期记忆:四层金字塔与白盒溯源
长期记忆是这套系统里最像"知识工程"的部分,采用四层渐进式金字塔,自下而上逐层提纯,信息密度越来越高:
| 层级 | 名称 | 内容形态 | 角色 |
|---|---|---|---|
| L0 | 原始对话 | 完整对话记录、工具调用日志、文档片段 | 最底层事实依据 |
| L1 | 原子记忆 | 从原始对话抽取的原子事实,每条带来源链接 | 可独立检索引用 |
| L2 | 场景记忆 | 同类原子事实归纳出的场景模式、高频路径 | 任务级经验沉淀 |
| L3 | 核心记忆 | 跨场景的核心洞察、稳定结论、团队规范 | Agent 平时直接调用的高密度知识 |
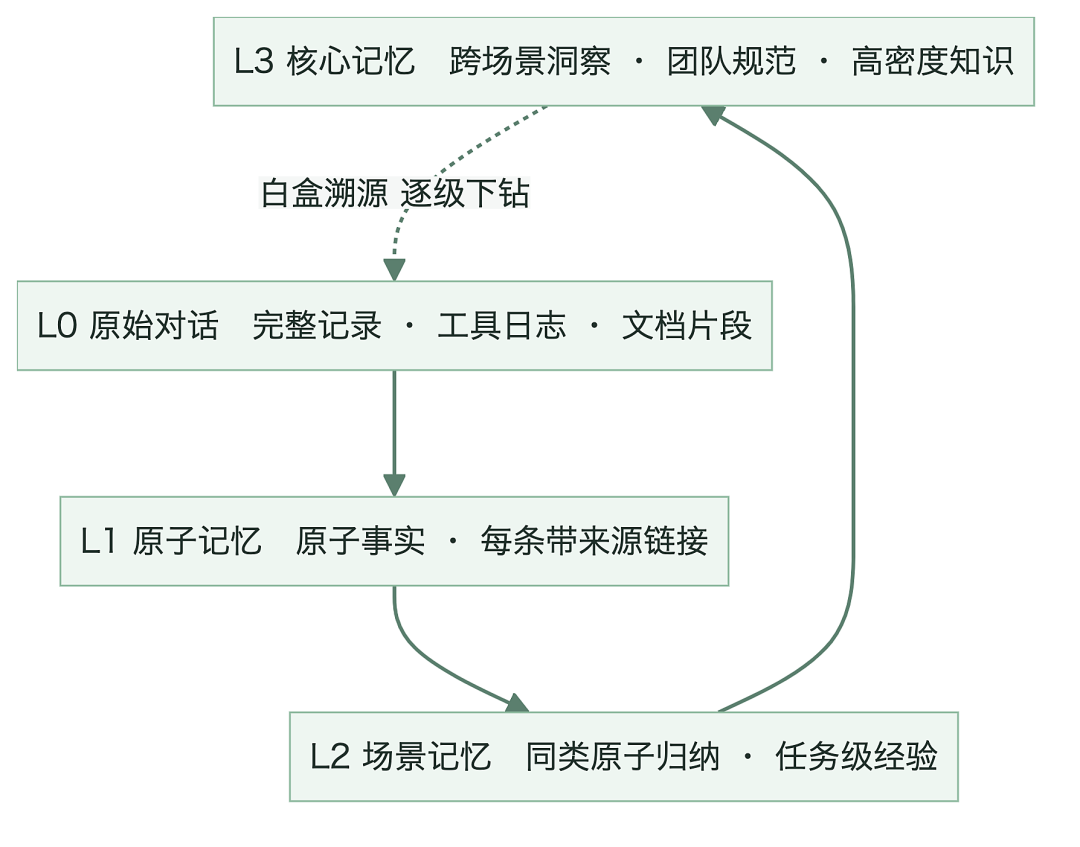
提炼是异步流水线:原文 → 关键点 → 场景 → 画像,越往上信息密度越高、越接近"深度理解"。而检索时反向——优先命中 L3 高密度结论,需要细节再沿来源链接逐级下钻。
这条白盒可溯源链路是它区别于"黑盒向量库"的核心卖点:每条核心结论都保留指向下层原始记录的链接,可沿四层从"结论"下钻到"原始对话",满足审计、纠错、合规要求。存储介质也是人眼可读的(开源版是 Markdown / JSONL / Mermaid),可调试、可人工核对。
混合检索则保证"召回得准":关键词命中(BM25)+ 向量语义 + RRF 融合排序三者结合,让模型拿到的不是无关历史碎片,而是"原子事实 + 场景模式 + 稳定结论"的组合。
六、团队记忆:让经验留在团队里
个人 Agent 的记忆解决了"我自己不丢",但真实业务是多人多 Agent 协同。团队记忆解决记忆在多用户、多 Agent 之间如何归属、隔离与共享。
可沉淀共享的记忆统一登记为记忆资产(Memory Asset),分四类:
- Chat Memory:跨会话保留用户偏好、事实、决策与交互历史。
- Skill:可复用的经验单元(版本、触发边界、执行步骤、验证规则),可配装给不同 Agent。
- Wiki:产品文档、设计方案、运维手册结构化为知识页与链接图谱。
- CodeGraph:索引代码符号、文件、调用关系与影响路径,支持影响面分析。
所有资产通过 Memory Hub 统一登记,记录 Owner(归属)、版本、状态、可见性、使用次数与 Agent 绑定关系。权限上分两层:全局管理员(System Admin)与团队内角色(Admin / Member);资产默认归 Owner 私有。默认私有、共享需明确授权——在"团队复用"与"成员隐私"之间取平衡。
七、数据底座与存储:云与开源两条路
| 维度 | 云端托管版 | 开源本地版 |
|---|---|---|
| 存储 | 腾讯云向量数据库 + 文件存储 | 本地 SQLite + sqlite-vec |
| 部署 | SaaS,VPC 内网 | 本地进程 / Docker,数据不出机 |
| 外部依赖 | 依赖腾讯云账号与网络 | 零外部 API 依赖 |
| 适用 | 企业级、强管控、合规审计 | 隐私敏感、离线、私有化 |
开源版之所以能"零外部依赖",是因为它把向量能力下沉到 sqlite-vec(SQLite 的向量扩展),再用文件存储兜底大对象。对隐私敏感的项目(代码、对话历史不想上任何第三方服务器)这是个硬需求。
八、接入形态:两条命令十分钟
开源版的上手成本低得夸张:
# OpenClaw 用户:零配置,默认本地 SQLite + sqlite-vec 后端 openclaw plugins install @tencentdb-agent-memory/memory-tencentdb openclaw gateway restart# Hermes 用户:Docker 一行起,内置 DeepSeek-V3.2 默认配置,也可自定义模型 docker run -d --name hermes-memory --restart unless-stopped \ -p 8420:8420 \ -e MODEL_API_KEY="$KEY" -e MODEL_BASE_URL="$URL" \ -e MODEL_NAME="deepseek-v3.2" -e MODEL_PROVIDER="custom" \ -v hermes_data:/opt/data \ agentmemory/hermes-memory:latest想自己写 Agent,则用 SDK 直接操作 Memory Gateway(默认监听 127.0.0.1:8420):
# pip install tencentdb-agent-memory-sdk-python from tencentdb_agent_memory import MemoryClient client = MemoryClient( endpoint="http://127.0.0.1:8420", api_key="local", # 独立模式默认值 service_id="default", # 独立模式默认空间 ) # 写入一段对话(L1 原子事实由异步流水线自动抽取) await client.addConversation({ "session_id": "quickstart-session", "messages": [ {"role": "user", "content": "I prefer TypeScript for tool scripts."}, {"role": "assistant", "content": "Got it, I will remember that preference."}, ], }) # 之后即可结构化检索原子记忆 memories = await client.searchAtomic({"query": "TypeScript preference", "limit": 5}) print(memories["items"])记忆生命周期是一个闭环:对话进入短期记忆 → 任务完成触发提炼 → L0→L1→L2→L3 异步分层 → 下次会话用混合检索召回 → 回灌上下文。
九、实测数据:省 Token 是真金白银
官方(及社区复现)给出三组硬指标,注意它们来自不同评测环境,应视为量级参考而非精确承诺:
- PersonaMem 评测集:总准确率 48% → 76%(提升约 59%),事实召回率 29.63% → 79.07%。(腾讯实验室,2026-04 统计)
- WideSearch 长任务基准:Token 消耗 221.31M → 85.64M(-61.38%),任务成功率 33% → 50%(+51.52%)。
- 动态智能上下文卸载:实测 Token 消耗直降 超 50%,完成率逆势提升 超 23%。
这组数字的逻辑自洽:上下文卸载砍掉了"全量回灌"的成本大头,分层记忆让召回从"翻碎片段"变成"取高密度结论",所以既省 Token 又提质量——通常这两者是要权衡的,这里靠"结构化"同时拿到。
十、边界与风险(实话实说)
- 版本与可用性:云端 Agent Memory 仍处内测/早期阶段,部分能力以问卷收集需求;开源版迭代快,接入路径以 GitHub 为准。
- 向量检索需自配 Embedding:开源版默认开启 BM25 离线检索,要上向量语义检索得自己接 Embedding 服务,否则混合检索退化成纯关键词。
- 收益有门槛:异步蒸馏流水线需要一定数据量才能体现分层价值,官方与社区都提到 < 100 轮对话收益不明显——小项目别指望立竿见影。
- 生态以腾讯云为主:OpenClaw / Hermes 之外的框架要走 SDK 适配,第三方示例相对少。
- 云版与开源版的治理差异:团队记忆的 Memory Hub、角色权限、资产审核是云端托管版的强项;开源版更偏"单机 / 私有部署",多租户治理能力要自己搭。
十一、总结:记忆该是底座,不是补丁
TencentDB Agent Memory 的设计哲学很清晰——把记忆从"提示词里的小技巧"升级成"系统级底座"。它的三个工程决策值得借鉴:
- 分层即压缩:L0→L3 的逐层提纯,本质是"用结构化换 Token",越往上越接近结论。
- 符号化 + 可溯源:存储介质人眼可读(Markdown/JSONL/Mermaid),结论能下钻到原始记录,这是"可审计记忆"的前提。
- 内核与框架解耦:记忆逻辑独立,换 Agent 框架不改记忆,团队经验真正可复用。
如果你正在做长期陪跑型 Agent(个人助理、企业知识问答、客服、编程助手),它值得作为记忆层候选;若只是跑一次性短任务,先把分层价值的数据量门槛想清楚再上。开源版 MIT + 本地离线,先两条命令跑起来看看,是成本最低的验证方式。
JOTO 企业落地观察
- 企业部署 AI Agent 时,若需支撑长期陪跑型场景(如客服、研发助手),必须将记忆模块从 Prompt 工程升级为独立底座,否则会面临 Token 成本不可控与经验无法沉淀的双重瓶颈。
- 四层金字塔式长期记忆(L0-L3)本质上是对 RAG 知识工程的流程化封装:L0 对应原始 chunk,L1-L3 则对应不同粒度的知识抽象与验证机制,企业需根据自身知识更新频率与审计要求选择启用层级。
- 开源版默认 SQLite + sqlite-vec 的轻量架构,降低了私有化部署门槛,但企业若需多租户隔离、细粒度权限与 Memory Hub 治理能力,仍需评估云端托管版或自行扩展开源版权限体系。
- 混合检索(BM25 + 向量 + RRF)虽提升召回质量,但对企业意味着需同步维护关键词词典、Embedding 模型与融合策略三套配置,AI 安全治理团队需将其纳入模型可观测性监控范围。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们