AI 智能体上了生产,你怎么知道它「今天有没有干蠢事」?
本文系统解析 AI 智能体(Agent)在生产环境中的可观测性问题,指出传统日志与 APM 无法应对 Agent 的多步、带工具、有状态、错误累积四大特性;提出 Tracing、Evaluation、Monitoring 三大支柱,并详解其分工;对比 Langfuse、LangSmith、Braintrust、Arize Phoenix 四家主流工具定位;最后给出从 Demo 到生产的五步落地清单。
你有没有遇到过这种情况:一个 AI 智能体(Agent),回答一个看起来很简单的问题,居然花了 45 秒。
到底是模型本身慢?是某次工具调用卡住了?还是它悄悄陷入了一个自己出不来的重试循环?
如果你没有装可观测性(Observability),你只能猜。而猜错的代价,可能是一笔悴悴上涨的 token 账单,也可能是一个在生产环境里默默犯错、你却毫无察觉的 Agent。
这不是我编的段子,这是 OpenTelemetry 官方在 2026 年那篇 GenAI 可观测性博客的开场白。他们用一句话点破了所有把 Agent 推上生产的团队的共同噩梦——你的 Agent 在生产环境里到底干了什么,你其实一无所知。
更扎心的一个事实是:单轮 LLM 调用,你还能靠「看输入、看输出」大致判断好坏;但一个 Agent 一次任务可能触发十几次模型调用、七八次工具调用、还带着一路累积的中间状态。这时候,你手里那套用了十年的日志和 APM(应用性能监控),基本上是瞎的。
今天这篇,我们就把「Agent 可观测性与评测」这件事从头讲透:它和传统运维差在哪、三大支柱分别管什么、四家主流工具怎么选,以及从 Demo 到生产你到底要盯哪些指标。
先讲个比喻:给实习生装监控,还是给整条流水线装监控?
理解 Agent 可观测性,先记住一个贯穿全文的比喻。
单轮 LLM,像你问实习生一句话:「帮我把这段英文翻译一下。」他给你个结果,好不好你一眼就能看出来。你根本不需要装摄像头,因为整个过程就一步,透明得很。
Agent 不一样。你不是问它一句话,你是把它放上了一整条流水线:让它自己查资料、调 API、读数据库、算中间结果、再决定下一步干什么。这条流水线可能有十几道工序,每一道都可能出错,而且错误会往下游累积——第三步取错了一个数,后面九步全在错误的地基上盖楼,最后产出一个看起来煞有介事、实际上完全错误的答案。
关键问题来了:如果你不给这条流水线装摄像头和质检站,货做废了,你根本不知道是哪一道工序把它做废的。
这就是 Agent 可观测性要解决的事——不是「结果对不对」这么简单,而是「整个过程里,每一步到底发生了什么,哪一步出了问题,代价有多大」。
为什么传统日志和 APM 看不懂 Agent?
先说清楚 Agent 和单轮 LLM 在运维层面的四个本质差别,这是理解后面所有内容的地基。
第一,多步。 单轮是「一问一答」,Agent 是「一个目标 → N 步动作」。传统 APM 擅长追踪「一个 HTTP 请求耗时多少」,但它不理解「这 45 秒里,模型思考占了几秒、工具调用占了几秒、重试浪费了几秒」。
第二,带工具。 Agent 会调用外部工具——搜索、数据库、代码执行、第三方 API。每个工具调用都可能超时、报错、返回垃圾数据。传统日志把这些当成孤立的 HTTP 请求记录,但它不知道「这次工具失败,是因为上一步模型生成了一个错误的参数」。
第三,有状态。 Agent 在一次任务里维护着不断增长的上下文(对话历史、中间结论、记忆)。同样一句用户输入,在不同的上下文状态下,Agent 的行为可能天差地别。无状态的传统监控完全捕捉不到这层因果。
第四,会累积错误。 这是最致命的。单轮 LLM 错了就是错了,一目了然。Agent 的错误会沿着推理链传播和放大——一个早期的小偏差,经过多步放大,最后变成一个离谱的结果。而你看最终输出,往往看不出这个错是从第几步开始的。
一句话总结:传统可观测性是为「无状态、单步、纯计算」的系统设计的;而 Agent 是「有状态、多步、带外部副作用」的系统。 用旧工具看新系统,就像用听诊器给汽车做故障诊断——不是没用,是根本不在一个维度上。
举个具体的例子体会下「累积错误」有多坏:假设一个任务需要 5 步,每一步 Agent 的正确率高达 90%,听起来很不错吧?但 0.9 的 5 次方只有 0.59——也就是说,即便每步都有九成把握,五步走下来成功率也不到六成。 步数再多一点(真实 Agent 十几步很常见),成功率就像雪崩一样往下滞。更麻烦的是,你看最终那个错误输出,完全不知道崩在了第几步。这就是为什么 Agent 特别依赖可观测性:你必须能把每一步单独拆开看,才能知道错误是从哪里开始滞延的。
三大支柱:Tracing、Evaluation、Monitoring
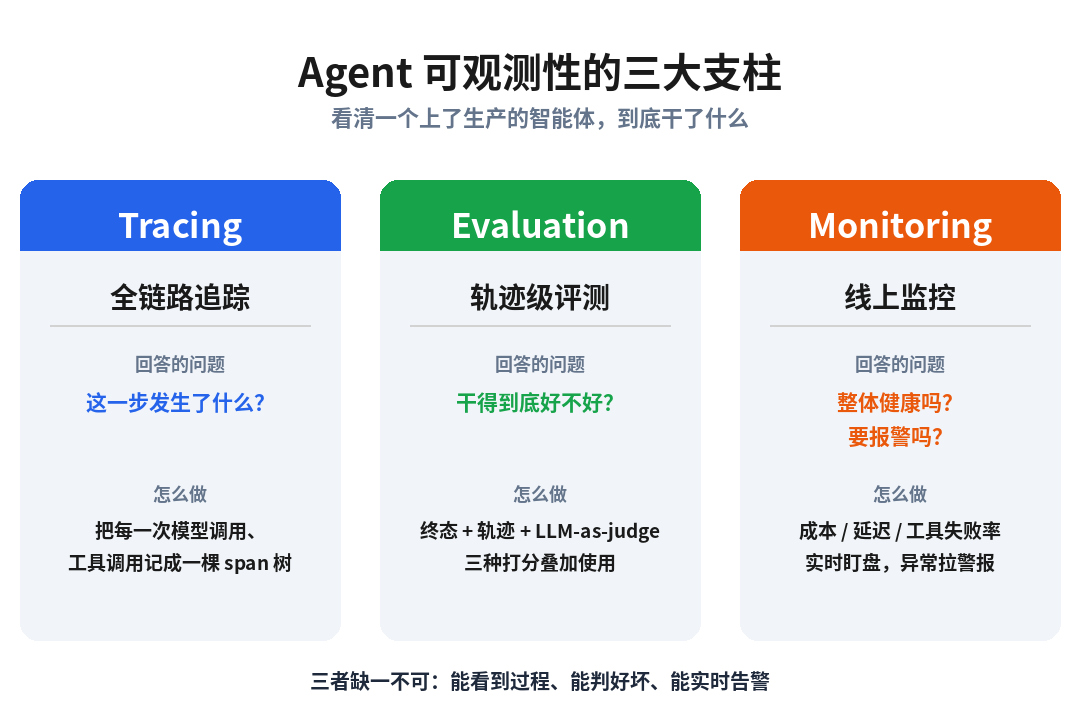
那给流水线装的这套「监控系统」,到底由什么组成?业界基本收敛到了三根支柱,你可以理解成三种视角,分别回答三个不同的问题。
- Tracing(全链路追踪):回答「这一次任务,具体每一步发生了什么?」——像流水线上装的一排摄像头,把每一道工序录下来。
- Evaluation(评测):回答「这一次任务,干得到底好不好?」——像质检站,给产出打分,甚至给中间每一步打分。
- Monitoring(线上监控):回答「最近一批任务,整体健康吗?出问题了要不要报警?」——像车间墙上的大屏,实时显示良品率、耗时、成本,异常了拉警报。
三者缺一不可。只有 Tracing 没有 Evaluation,你能看到过程却不知道好坏;只有 Evaluation 没有 Monitoring,你能离线评分却发现不了线上突然变糟;只有 Monitoring 没有 Tracing,你知道出事了却定位不到是哪一步。这三者合起来,才能回答一个 Agent 团队最关心的终极问题:它今天到底干得好不好、花了多少钱、有没有在患里干蠢事。下面逐个拆开。
支柱一:Tracing——把 Agent 的「思考轨迹」摊在阳光下
Tracing 是三大支柱的地基,因为另外两根柱子都建立在「你能完整看到过程」之上。
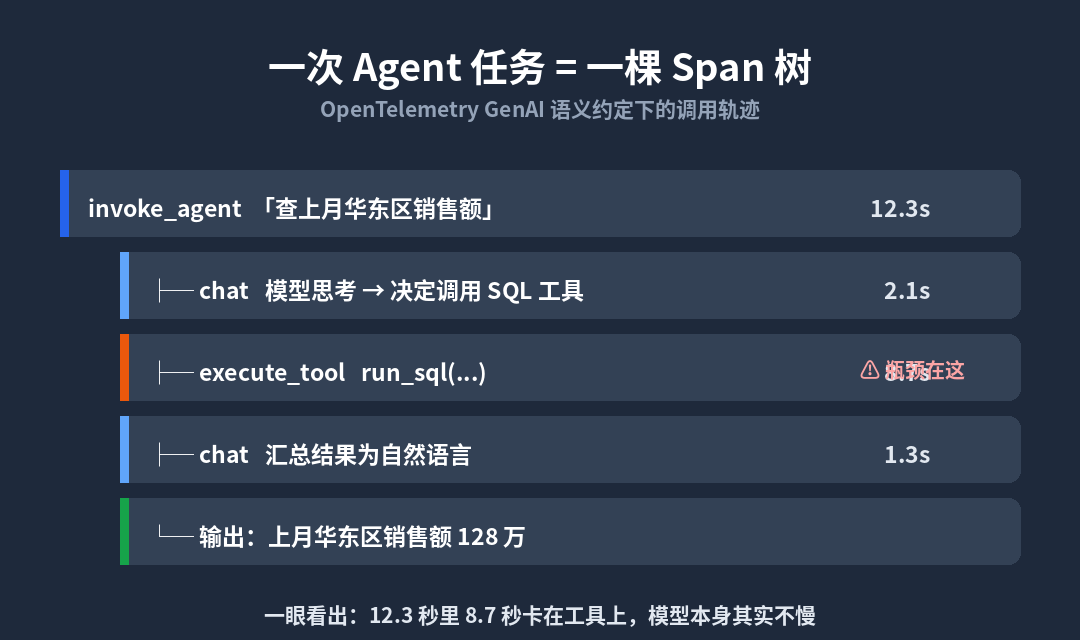
核心数据结构是一棵 Span 树(跨度树)。 一次 Agent 任务是一个根 Span,它下面挂着一层层子 Span,形成一棵树。以 OpenTelemetry 2026 年的 GenAI 语义约定为例,一次典型的 Agent 执行,展开后大概长这样:
- 顶层是一个
invoke_agentspan(这次智能体调用) - 它下面挂着若干个
chatspan(每一次 LLM 模型调用) - 以及若干个
execute_toolspan(每一次工具调用)
画成一棵树大概长这样:
invoke_agent “查上月华东区销售额”  (12.3s)
  ├─ chat  模型思考 → 决定调用 SQL 工具  (2.1s)
  ├─ execute_tool  run_sql(...)  (8.7s)  ⚠ 慢
  ├─ chat  把查询结果汇总成自然语言  (1.3s)
  └─ 输出:“上月华东区销售额 128 万”
一眼就能看出:12.3 秒里有 8.7 秒卡在 SQL 工具上,模型本身其实不慢。这就是 span 树的价值——它把一次任务拆成了可归因的时间切片。
点开任意一个 span,你能看到 OTel 语义约定规定的标准字段:调用了哪个模型、输入输出的 token 数、(在你显式开启后)完整的 prompt 和 completion 内容、工具调用的参数和返回值。
"每次应用调用 LLM,背后都会发生一连串的模型调用、工具调用和 token 交换——没有可观测性,你就是在猜。" —— OpenTelemetry GenAI 可观测性博客
这里要专门说一下 OpenTelemetry GenAI 语义约定,因为它是 2026 年整个赛道最重要的「地基工程」。
大白话版: 以前每家可观测性工具记 Agent 数据的格式都不一样,你从 Langfuse 导出的数据塞不进 Datadog,换个工具就得重新埋点。OTel 语义约定干的事,就是定义一套所有人都认的标准词汇表:prompt 叫什么字段、token 数叫什么字段、工具调用怎么记、模型供应商怎么标(比如 AWS Bedrock 统一标成 aws.bedrock)。这样一来,数据格式统一了,工具之间可以互换,你不再被某一家锁死。
这个标准的分量有多重?看谁在跟进就知道了:Datadog 已经原生支持 OTel GenAI 语义约定;VS Code Copilot、OpenAI Codex、Claude Code 这些编程助手,现在都能直接吐出 OTel 格式的遥测数据(Claude Code 的 trace 支持还在 beta)。也就是说,可观测性正在从「各家自己埋点」走向「一套标准、处处通用」,这对做 Agent 的团队是天大的好事。
Tracing 到底帮你抓什么问题? 回到开头那个 45 秒的例子:点开 span 树,你一眼就能看到——哦,原来 40 秒都耗在一个 execute_tool span 上,是那个数据库查询超时了,模型本身其实只花了 3 秒。没有 Tracing,你只知道「慢」;有了 Tracing,你知道「慢在哪、为什么慢、怎么修」。
支柱二:Evaluation——给「多步任务是否成功」设计评分
这是整件事里最难、也最容易被忽视的一环。因为 Agent 的「成功」很难定义。
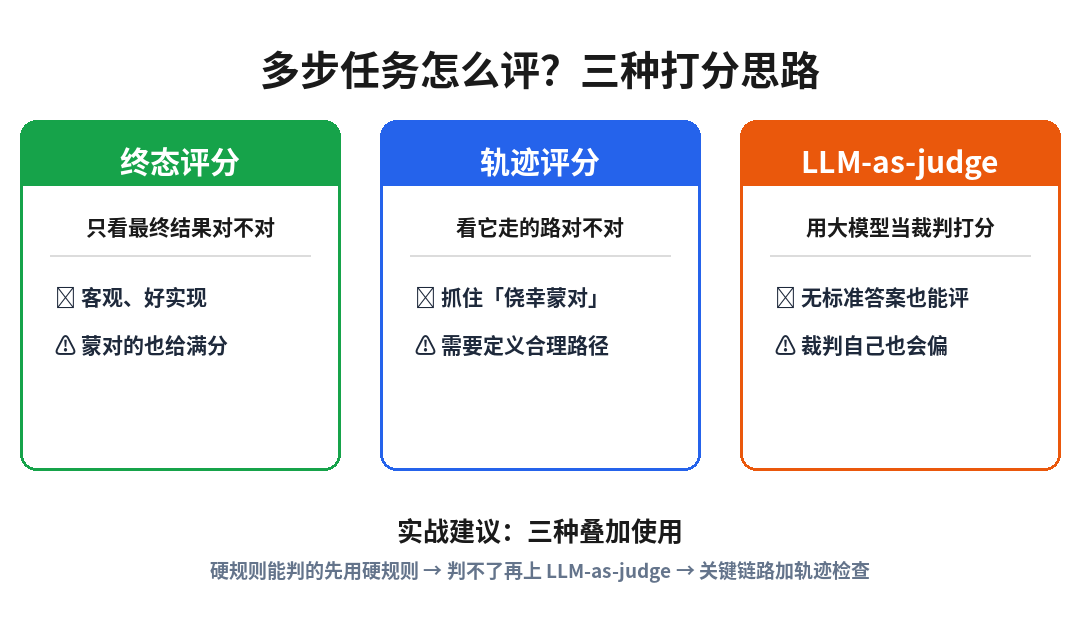
单轮 LLM 的评测相对好办:给个标准答案,比对一下就行。但 Agent 的任务往往没有唯一标准答案(「帮我订一张性价比最高的机票」这种任务,怎么算对?),而且它是多步完成的。业界现在主要有三种评测思路。
第一种:终态评分(Final-state / Outcome)。 只看最终结果对不对——机票订对了吗?代码跑通了吗?优点是客观、好实现;缺点是它会放过「蒙对的」和「过程全靠蒙、结果碰巧对」的情况。
第二种:轨迹评分(Trajectory)。 不只看结果,还看它「走的路对不对」——它是不是调用了正确的工具?步骤顺序合不合理?有没有多余的弯路和重试?这对 Agent 尤其重要,因为一个「侥幸蒙对」的 Agent 上了生产,早晚会翻车。
第三种:LLM-as-judge(用大模型当裁判)。 当答案没有标准参考、又无法用规则自动判断时,就拉另一个(通常更强的)模型来给输出打分,比如「请从 1-5 分评价这个回答的事实准确性」。这是 2026 年最主流的自动评测手段,但它有个致命陷阱:裁判自己也会不靠谱(有偏见、偏好长回答、容易被「听起来很专业」的胡言乱语骗过)。所以严谨的做法是:先拿一批人工标注好的数据去「校准」你的 LLM 裁判,确认它的打分和人类对得上,再拿它去大规模自动评分。
一个实战建议:不要只用一种。成熟的 Agent 评测体系通常是终态 + 轨迹 + LLM-as-judge 三种叠加:能用硬规则(代码跑不跑通、JSON 合不合法)判定的就用硬规则,硬规则判不了的再上 LLM-as-judge,关键链路再叠一层轨迹检查。
那评测集从哪来?两条路子:一是人工标注(贵但质量高,适合关键任务),二是把线上真实轨迹攒下来、把出过问题的 case 挑出来当回归样本。一个实用技巧:别一上来就追求几百条大集,先攒三五十条能覆盖典型场景和已知坏 case 的小集,能拦住八成回归就已经很值了。评测集不是一次造好的,它跟着你的 Agent 一起长大。
一个极端对比案例,让你看清「只看终态」有多危险。 假设你做一个数据分析 Agent,用户问「上个月华东区销售额多少」。两个 Agent 都回答了「128 万」,终态评分都是满分。但拉开轨迹一看:A 号正确地过滤了「华东区 + 上月」两个条件;B 号其实把 WHERE 条件写错了,算的是全城数据,只是碰巧这个月全城和华东区数字差不多。下个月 B 号就会翻车,而你的终态评分完全发现不了——因为它今天「侥对了」。这就是为什么轨迹评分对 Agent 不是锦上添花,而是生死攻防。
小心评测被「玩坏」。 还有个阴沟:一旦你把某个评分标准当成优化目标,Agent(或调参的人)就会学会「只优化分数、不优化真实效果」。比如你用 LLM-as-judge 打「回答是否详细」,结果 Agent 学会了写一大堆没用的废话来凑「详细」。这就是强化学习里臭名昭著的 reward hacking 在评测环节的翻版。应对办法:多维度交叉打分、定期用新的人工样本重新校准裁判、不要把单一指标当唯一真理。
支柱三:Monitoring——线上到底该盯哪几个数字?
Tracing 和 Evaluation 很多是「事后看回放」和「上线前跑分」,Monitoring 则是「线上实时盯盘」。Agent 上了生产,你到底该在大屏上盯哪几个指标?除了传统的延迟、QPS、错误率,Agent 特有的四类指标你必须看:
- 成本(每任务 token 消耗):单轮 LLM 的成本好估,Agent 一次任务调十几次模型,成本方差极大。一旦某类任务陷入重试循环,token 账单会瞬间爆炸。盯「每任务平均成本」和「长尾高成本任务」。
- 延迟(端到端 + 分阶段):不能只看总耗时,要拆开看模型思考、工具调用、网络等待各占多少。P95/P99 延迟比平均值重要得多。
- 工具调用失败率:这是 Agent 独有且最容易被忽视的指标。工具报错率一旦升高,往往意味着模型开始生成错误参数,或者下游 API 挂了。
- 任务成功率 / 人工接管率:多少任务 Agent 自己完成了,多少需要人工兵。后者上升往往是质量滑坡的最早信号。
举个真实的告警场景:某天上游换了个模型版本,你的大屏上“工具调用失败率”从 2% 突升到 15%。传统 APM 会告诉你“服务都正常、HTTP 200”,因为代码没报错;但 Agent 监控能直接拉警报:新模型生成的工具参数格式变了,导致调用大面积失败。这种“代码没错、但 Agent 变蠢”的毛病,只有 Agent 专用的监控才看得见。
把 Evaluation 的自动评分接到线上(对采样流量跑 LLM-as-judge),你就能把「质量」也变成一个可告警的实时指标——这才是 Agent 监控与传统 APM 最大的不同:传统监控只能告诉你「系统挂没挂」,Agent 监控还得告诉你「它变蠢没变蠢」。
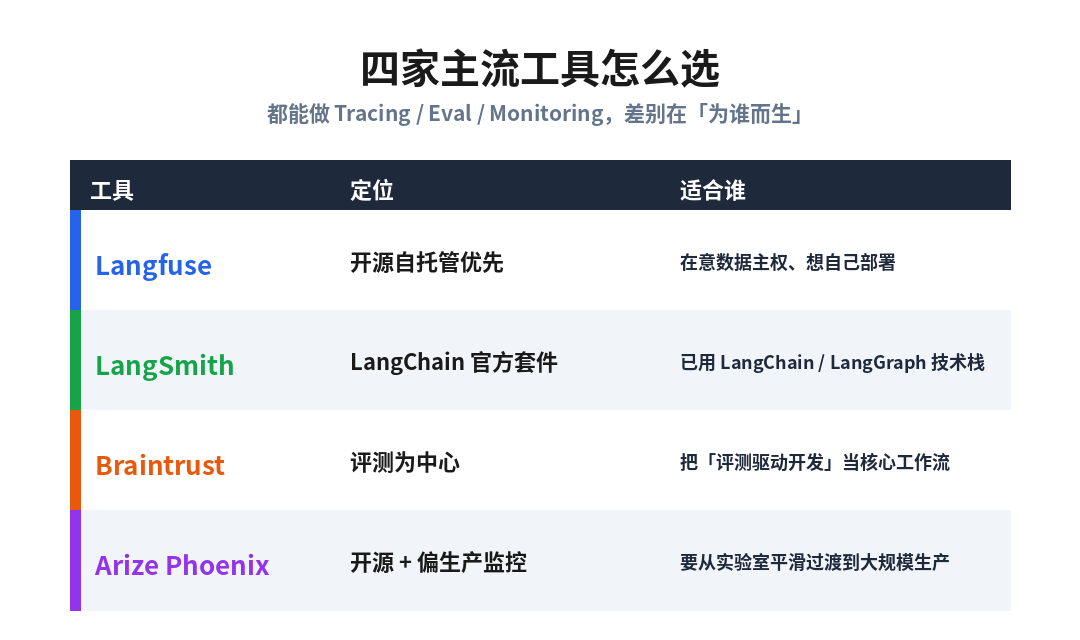
四家工具矩阵:Langfuse / LangSmith / Braintrust / Arize Phoenix
地基搭好了,现实中用什么工具落地?先说它们的共性:四家其实都干同一件事——接住 Agent 吐出的 trace、提供一套跨轨迹的评测能力、再把关键指标搬上线上监控大屏。差别不在“能不能”,而在“先为谁而生”——每家都有自己的基因和偷心。
2026 年四家主流方案,各有脸面:
| 工具 | 定位 | 特点 | 适合谁 |
|---|---|---|---|
| Langfuse | 开源自托管优先 | 开源、能自己部署、框架中立、OTel 兼容好 | 在意数据主权、想自托管的团队 |
| LangSmith | LangChain 官方套件 | 与 LangChain/LangGraph 无缝衔接、评测能力强 | 已经用 LangChain 技术栈的团队 |
| Braintrust | 评测为中心 | Eval 体验好、Playground 强、适合快速迭代 prompt | 把「评测驱动开发」当核心工作流的团队 |
| Arize Phoenix | 开源 + 偏生产监控 | 开源、OTel 原生、偏向生产环境大规模监控与漂移检测 | 需要从实验室平滑到生产监控的团队 |
选型的真正分水岭不是功能列表,而是三个问题:你能不能接受 SaaS(还是必须自托管)?你的技术栈是不是绑定 LangChain?你的重心在「开发期快速评测」还是「生产期大规模监控」?想清楚这三点,选型基本就定了。而有了 OTel GenAI 语义约定这层标准,即便以后想换工具,迁移成本也比以前低得多。
从 Demo 到生产:一张可观测性落地清单
讲了这么多原理,最后给一张可以直接拿去用的落地清单,按这个顺序一步步来:
- 先埋 Tracing。 从第一行 Agent 代码开始就接 OTel GenAI 语义约定,把
invoke_agent/chat/execute_tool的 span 树先跑通。没有 trace,后面什么都是空中楼阁。 - 攒一个评测集。 把真实、有代表性的任务攒成一个数据集(哪怕先几十条),作为上线前的「回归测试」。改 prompt、换模型前先跑一遍,防止「改好了一处、改崩了五处」。
- 设计分层评分。 硬规则优先,其次 LLM-as-judge(并用人工标注校准),关键链路加轨迹检查。
- 上线监控 + 告警。 把成本、分阶段延迟、工具失败率、任务成功率上大屏,对采样流量跑在线评分,异常拉警报。
- 形成闭环。 线上发现的坏 case 回流到评测集,下次迭代自动防回归。可观测性不是一次性工程,是个不断转的飞轮。
回到开头那个比喻。单轮 LLM 是问实习生一句话,错了一眼就看得出来;Agent 是放它上了整条流水线,不装摄像头和质检站,你根本不知道它在哪一步把货做废了。而所谓可观测性,就是让这条流水线从黑盒变成玻璃房——每一道工序都看得见,每一件次品都拦得下。
Agent 能不能真正从「好玩的 Demo」变成「靠谱的生产力」,差的往往不是模型能力,而是你能不能看清楚它到底干了什么。看不见的东西,无法改进。过去一年,真正把 Agent 跑上生产的团队都在补这一课:先把“黑盒”变透明,再谈优化。可观测性听起来像是“锈活”,但它恰恰是区分“玩具 Agent”和“生产 Agent”的那道分水岭。
JOTO 企业落地观察
- 企业部署 Agent 时,若跳过 Tracing 直接进入 Evaluation 或 Monitoring,将导致可观测性体系根基不稳——因为后两者均依赖完整、标准化的过程数据。缺乏 Span 树结构,评测无法归因,监控无法下钻。
- 企业在选择工具时,不应仅关注功能列表,而需评估自身在「数据主权」「技术栈耦合度」「开发与生产阶段权重」三方面的实际约束。OTel GenAI 语义约定降低了切换成本,但初始选型仍影响工程节奏与团队认知负荷。
- Agent 的可观测性建设不是一次性配置任务,而是需嵌入研发流程的持续实践:评测集随业务演进、Trace Schema 随 Agent 架构调整、监控阈值随线上表现动态校准。企业需为该能力预留长期迭代资源,而非视为上线前的收尾工作。
- 当企业将 LLM-as-judge 用于线上质量监控时,必须同步建立裁判模型的可信度验证机制——包括人工抽样比对、对抗样本压力测试、及跨时间窗口的稳定性跟踪。否则,“用模型监模型”可能演变为双重黑盒风险。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们