AI模型切换远非一行代码:企业平均需数周工程投入
VentureBeat调查显示,47%的百人以上企业过去一年内更换过生产环境AI模型,但其中70%需额外数周工程工作;仅13%实现近乎零成本切换。模型行为差异、提示词适配、微调迁移与测试框架依赖是主要瓶颈。
本应很简单。AI模型在智能水平上不断相互超越,因此各公司已搭建了网关和路由器,让工程师只需修改一行代码即可切换模型——从而轻松升级至当日最佳模型。
事实证明,当公司在客户或员工已依赖的应用程序内部尝试这种切换时,替换工作可能需要数周甚至数月的工程投入。他们往往不得不重构应用程序,或退回使用原有模型。新的最佳模型每隔几个月就会出现一次,因此希望跟上节奏的公司不得不反复面对数周的工程工作。
VentureBeat在其 10月调查 中就模型切换问题向员工人数至少为100人的企业中从事AI工作的人员进行了询问。我们提问:受访者所在公司是否在过去12个月内,在保持周边应用程序不变的前提下,替换了生产环境AI系统中的模型。在所有受访者中,47%回答“是”。
在那些所在公司确实执行过模型切换的受访者中,70%表示,除模型本身更换外,切换工作还需额外耗费数周或更长时间的工程投入。在这些相同受访者中,36%表示切换耗时超过一个月。
仅有13%的、所在公司执行过模型切换的受访者表示,该切换几乎无需付出努力,接近于一次配置变更。
切换结果参差不齐。在那些所在公司执行过模型切换的受访者中,55%表示新模型表现与旧模型持平或更优。其余45%给出了两种回答之一:性能下降,公司不得不重构周边应用程序;或公司退回使用原始模型。这45%的比例自9月以来在统计学意义上未发生显著变化。 自9月以来。
为了解导致切换困难的原因以及公司如何为此做准备,我参考了VentureBeat近期对Uber、PayPal、Home Depot、T-Mobile、Box及其他公司高管的访谈及活动会议内容。
Anthropic于周一下调了价格,各公司正将工作负载路由至更便宜的模型。
降价是公司切换模型的原因之一,尽管我们的调查并未询问受访者其公司切换模型的具体原因,也未询问新模型是否更便宜。周一,Anthropic发布了Claude Fable 5.2,输入令牌单价为每百万8美元,输出令牌单价为每百万40美元, 较其所替代版本价格低20%,据VentureBeat执行主编Carl Franzen报道。我们的10月调查在该发布前已结束。
公司可通过路由器将工作负载从中等价位模型迁移至更便宜的模型。路由器是一种软件,负责将每个请求发送至选定的模型。路由是AI网关的一项职能,该网关位于公司应用程序与模型提供商之间。
Adobe营销智能体使用更便宜的模型来选择合适上下文,随后Adobe将提示词发送至更大的模型,Adobe工程高级副总裁Anjul Bhambhri在VentureBeat于10月28日于旧金山举办的 智能体基础设施栈峰会(Agentic Infrastructure Stack Summit) 上表示。
一些初创公司提供模型路由解决方案。Tetrate即为其中一家,其“自动模式(Auto Mode)”为每个请求选择模型。Tetrate联合创始人兼首席技术官Varun Talwar在峰会上表示,部分Tetrate客户已不再关心最终获得的是哪个模型。他说,这些客户告诉Tetrate:“你爱在模型设置里填什么字符串就填什么。”
但Talwar表示,客户在信任该自动选择前仍需开展工作。他表示,Tetrate目前尚未“完全实现”对“何种任务适配何种模型”的准确判断。Talwar称,客户通常先由一个团队启动,仅当答案质量与此前相当且成本下降时,才将自动模式设为默认。
因此,网关虽使模型易于更换,但公司仍须验证其应用程序在新模型下是否仍能同等良好地运行。
在客户或员工已依赖的应用程序内部替换模型,是一项截然不同的工作,而这也正是我们此次调查所聚焦的问题。Upwork(一家面向自由职业者的在线市场)平台基础设施工程副总裁Sudhanshu Bist在峰会上也划出了同样的界限。针对一项开源编程挑战,Bist表示他个人会允许一个小模型完成一个大模型启动的任务。但在生产系统中,他表示自己“很可能坚持使用现有模型”。他在周三的一封电子邮件中补充道,模型选择取决于具体任务。他表示,Upwork将重复性高、定义明确的工作(例如匹配自由职业者与职位)交由更小、经过调优的模型处理,而将开放式任务交由更大模型处理。
生产级应用程序可能依赖工程师为某一特定模型量身定制的提示词、工具和测试,而这些部分在模型变更后可能需要重新调整。本次调查并未询问受访者具体重做了哪些部分,也未询问其公司是否使用网关。
新模型在为旧模型构建的软件内部可能表现出不同行为。
一些公司已转向对模型进行微调,以使其更适配自身业务领域。公司利用自身示例进一步训练该模型,但此类微调无法自动迁移到替换模型上。PayPal全球AI产品高级副总裁Ren Zhang于10月8日VentureBeat一场活动中表示,PayPal已在某应用程序中“多次”更换模型。对于PayPal的电商智能体(该智能体协助购物者调研并购买商品),PayPal转而采用更小、更快的模型,并对该小模型进行了微调,此举提升了准确性,但提升幅度不足,Zhang表示。该公司称,上述工作均在内部研究与测试阶段完成,早于该智能体面向客户上线之前。
PayPal后来决定减少微调,因为微调需要一支专业团队,且“每当出现新模型时,你都必须用新模型再次进行微调”,Zhang表示。PayPal现通过平衡微调、开箱即用模型以及计算资源分配方式,以获取准确性、速度、成本与可控性之间的最佳组合,Zhang于周二通过PayPal发言人表示。
Box首席技术官Ben Kus表示,新模型可能令应用程序表现变差,因为工程师将其软件专门适配于最初选用的模型。随后工程师更换模型,“而新模型的行为可能只是略有不同”,Kus于10月30日在接受VentureBeat 《超越试点》(Beyond the Pilot)播客采访时指出。他表示,高管们常假设采用更新模型即意味着更好结果,而这一假设往往并不成立。
他表示,公司“最显著不同的结果很可能源于‘封装器’(harness)”。封装器指包裹模型的代码,负责向模型传递指令并控制模型可调用的工具。当前前沿模型之间的选择差异较小,因为这些模型整体都非常优秀。他表示,Box目前正对封装器与模型进行组合测试,以找出效果最佳的配对方案。
该测试框架(harness)会改变任务的成本。月之暗面(Moonshot AI)的Kimi K3模型在Runta公司FrontierHarness Eval基准测试中,于Claude Code和一种DeepSeek Harness配置下均通过了63.3%的任务。但每项通过任务的平均成本在Claude Code中为18.34美元,在该DeepSeek Harness配置中仅为3.28美元——相同得分下成本高出五倍以上,该基准测试的 排行榜 显示。
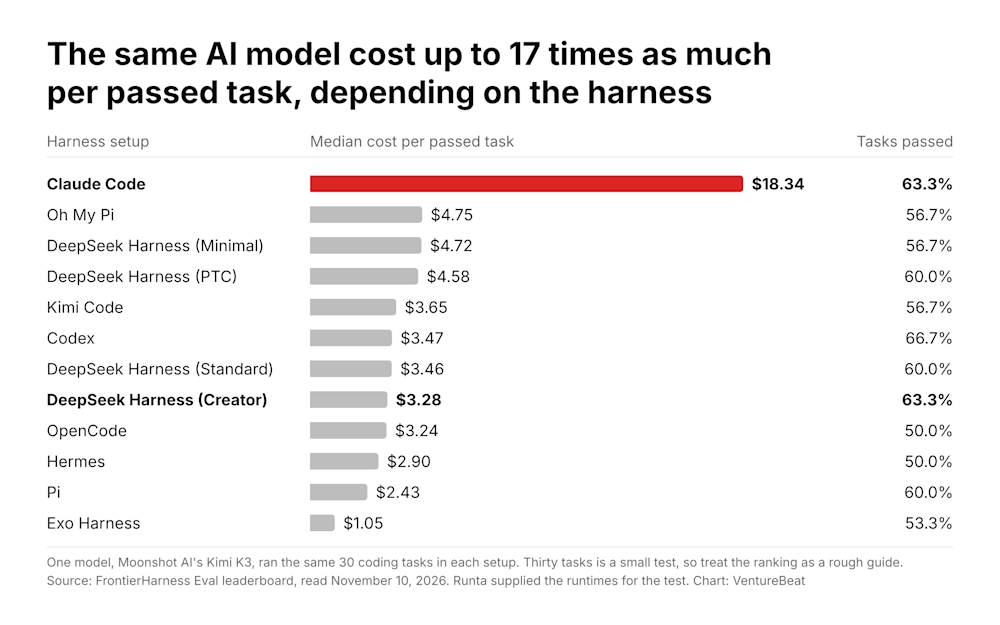
在FrontierHarness Eval中,Kimi K3在九种编码测试框架(coding harnesses)的12种配置下,对同一组30个任务进行了运行。提供本次测试运行时环境的代理基础设施公司Runta于9月初早些时候公布了结果。30个任务属于小规模测试,因此排名仅能作为粗略参考,这一点我在播客联合主持人Sam Witteveen对其基准测试所作的 视频评测中亦有指出。
我们向正在评估新模型的公司提出的建议是:在该模型实际将使用的测试框架中进行测试;若结果令人失望,应先尝试更换另一种测试框架,再决定是否弃用该模型。否则,公司可能将本由测试框架引发的问题归咎于模型本身。
基准测试公司Artificial Analysis联合创始人兼首席执行官Micah Hill-Smith在10月28日峰会上表示,对于最大型模型,其研究发现测试框架(harness)“所起的作用比我们预期的要小”。而另一方面,Hill-Smith称小型模型灵活性较低。他表示,小型模型在编码代理测试中的得分可能产生“20、30或40分的大幅波动”,具体取决于该模型是否针对某一特定测试框架的风格进行了训练。
Hill-Smith称,转向更小型模型是企业大幅降低任务成本的方式,但此举需付出工程时间代价。“我们投入更多工作,以使我们能够使用更小型的模型,”他说。
如果小型模型对测试框架反应强烈,那么工程师为大型模型构建的测试框架可能并不适用于小型模型。
每token成本更低的模型,其每次获得优质结果的成本却可能更高
更换为更廉价的模型后,若失败频率上升,总成本反而可能更高。
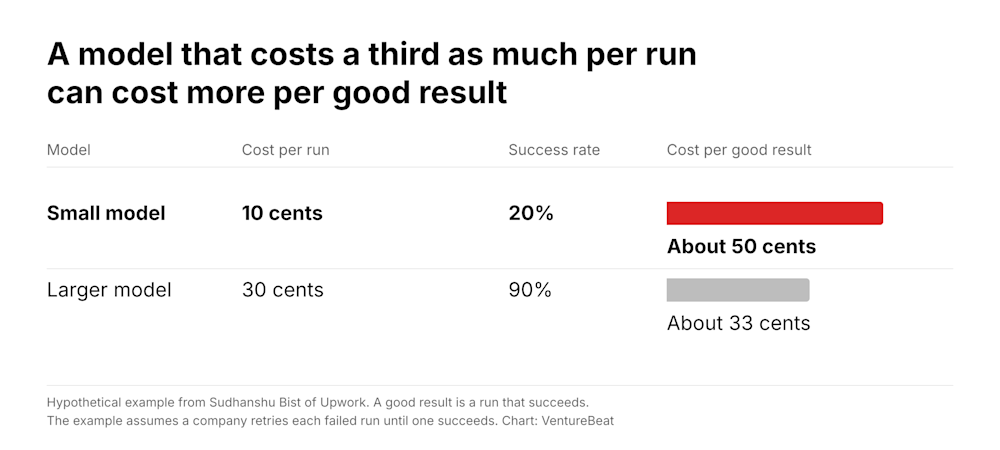
Bist在峰会上向听众举了一个假设性例子:一个每次运行成本为10美分、成功率20%的小型模型,平均需运行5次才能获得一次成功结果,因此每次优质结果的成本约为50美分。Bist在周三的一封电子邮件中澄清其数据称,一个每次运行成本为30美分、成功率90%的较大型模型,每次优质结果的成本约为33美分。该较大型模型单次运行成本是小型模型的三倍,但每次优质结果的成本反而更低。Bist表示,该示例假设企业会对每次失败的运行持续重试,直至获得一次成功结果。
Bist称,Upwork的模型网关(model gateway)并未捕捉到每次优质结果的全部成本。该网关按团队追踪模型调用支出,但无法观测用于模型训练与微调的GPU算力消耗、人工修复代理输出所花费的时间,以及代理调用工具时产生的处理器成本。
Tetrate公司Talwar称,一些公司正开始计算“每次优质结果的成本”,而非仅关注“每token成本”。WEKA公司首席AI官Val Bercovici在峰会上表示,AI行业“仍固守”按token计费模式,而本应按结果(outcome)计量成本。WEKA是本次峰会的赞助商之一。
一些公司认定,对特定任务而言,选用更廉价的模型并非正确目标。T-Mobile首席信息官Jeff Simon在峰会上表示,T-Mobile在其客户服务代理中采用领先模型,并为此支付溢价。“我们在客户服务领域并未真正追求成本优化,”Simon称。T-Mobile的目标是向客户提供快速、准确的答案。
Uber表示可在数日内切换托管代理(managed agent)所用模型
Uber杰出工程师Uday Kiran Medisetty在峰会上表示,若某开源权重模型(open-weight model)能为Uber的AI代码审查带来最佳投资回报率,“我们将在数日内完成切换。”AI代码审查是Uber的托管代理之一,即Uber集中构建并运行、专用于单一任务的代理。
Uber拥有 代码审查基准测试,因为Uber可将任一模型与过去数年中的任意代码变更进行测试对比,Medisetty称。随后Uber基于真实编码会话构建了其后台编码代理(background coding agent)的基准测试,他称此项工作难度大得多。
Medisetty称,Uber利用这些基准测试所得洞见为其自动化代码清理任务选择模型。该任务用于移除过时的功能标志(stale feature flags)。他称,Uber通过基准测试并选择合适模型,将其每次清理任务的成本降低了90%。他表示,Uber在每一项托管代理中均看到了进一步降低成本的机会。
Medisetty还称,Uber亦追踪其AI请求中可从一个模型迁移至另一模型的比例。Uber可将其托管代理在不同模型间迁移;而工程师在Claude Code等工具中手动运行的会话则难以迁移,他称,因为迁移此类会话意味着改变人员的工作方式。
PayPal、Databricks客户、Box、T-Mobile及摩根大通(JPMorgan Chase)在模型切换前采取的措施
PayPal将其业务知识保留在模型之外。 PayPal内部数据科学助理依赖一个知识层,该层存储PayPal的业务定义、经批准的查询语句以及分析工作的分步操作手册(playbooks),Zhang称。据PayPal称,加入该知识层后 该助理在内部业务问题上的准确率 从43%提升至95%,且所用模型未变。PayPal将该知识层独立于模型单独构建。“它是模型无关(model agnostic)的,因为我刻意如此设计,”Zhang称。当更优模型问世时,“我只需即插即用,无需更改我的知识。”她表示,若企业将自身知识与某一特定模型绑定,则每次更换新模型时都需重新调整该知识。
Databricks客户将前沿模型(frontier model)的回答转化为测试依据。 Databricks产品管理总监Bryan Clark称,Databricks客户遵循一套流程:首先基于前沿模型、借助简易文本索引构建第一版,Clark称之为“智能代理,非智能后端”;随后将前沿模型的回答保存为评估集;接着迁移到更廉价的开源权重模型,添加向量搜索以辅助该廉价模型,并将该廉价模型的回答与前述评估集进行比对,Clark在峰会上表示。
Box从三个数字评判每一项变更: 准确率、成本与速度,均基于一个由客户向Box代理提出的真实请求所构建的评估集进行测量。“你如何实现并不重要,真正重要的是这三个数字,”Kus称。他称,收集评估数据通常是最困难的部分。
T-Mobile在真实客户通话中测试各项变更,并在每次会话后全程回看。 当T-Mobile的工程师希望更改其客服代理的设置方式时,T-Mobile会同时运行旧版本和新版本,并在真实客户通话中对二者进行对比评估,西蒙表示。仅当新版本表现更优时,T-Mobile才会扩大其部署规模。他还表示,T-Mobile还运行一个小型模型,监控每一次聊天及语音会话,并对看起来有误的回答发出警示。西蒙称,上线前的测试无法覆盖客户提问的所有方式,因此T-Mobile会寻找那些‘你在实验室里永远看不到’的异常案例。
摩根大通(JPMorgan Chase)在员工获得访问权限之前即批准新模型。 另一个拖慢模型切换速度的因素是组织层面的治理机制。 正在向更多员工推出Anthropic公司Claude模型的摩根大通,要求每一款新的Claude模型均须通过该银行自身的审批流程,方可供摩根大通任何员工使用, Anthropic公司表示, 于周一。
企业在下一次模型切换前可采取的措施
切换所需的工作量,是审慎评估切换的动因之一,而非彻底排除切换可能。Snowflake公司AI编程助手CoCo及面向知识工作者的AI助理CoWork的产品主管威廉·艾伦(William Allen)在11月3日与VentureBeat的对话中表示,三四个月前关于AI的某些认知很可能已不再成立。“对我们所有人而言,最需理解并真正领会的关键谬误或许是沉没成本谬误——你可能会说:‘不不不,我已投入大量时间构建了这个系统,我不想重新构建它。’”艾伦表示。
根据上述发言者所描述的情况,核心启示在于:务必在切换前完成准备工作。
第一,从真实用户请求及经准确性核查的回答中构建评估集,以便企业能用该评估集测试新模型。
第二,在‘每次成功结果的成本’维度上对比各模型,计入失败尝试次数;在模型实际将运行的封装环境(harness)内测试每款模型,并尽可能至少另选一种封装环境进行测试。
第三,将业务知识(例如定义与规则)保留在企业自主可控的一层中,从而避免工程师为每个模型重复构建该层。
第四,在真实流量下对比应用的旧版本与新版本,并在切换后持续监控,因为测试无法覆盖用户提出的所有问题。
VentureBeat将在其11月的调查中就模型切换提出相同问题,并报告是否仍有70%的受访者所在公司完成模型切换后仍表示切换耗时数周或更久。
数据说明:VentureBeat Intelligence于2026年10月开展了本次关于智能体编排(agent orchestration)的VB Pulse调研。受访者所回答的是员工人数至少为100人的组织;其中28%的受访者为顾问,其回答基于其投入时间最多的客户。仅报告过模型切换的受访者回答了有关工程工作量的问题;而关于切换结果的百分比数据亦仅针对同一群体,因此该群体的百分比精度较低。
本次对比中,9月数据仅包含那些本可通过10月资格筛选的受访者。9月,49%报告其所在公司已完成模型切换的受访者表示切换耗时数周或更久,12%表示切换耗时超过一个月。VentureBeat Intelligence将10月这两项增幅均标注为趋势性(directional),因受访者构成发生了变化。10月,35%的受访者表示其从商业角度使用AI系统或对其进行追踪,该比例远高于9月;且这些受访者选择“超过一个月”的频率高于其他受访者。若剔除这部分受访者,则10月报告其所在公司已完成模型切换的受访者中,66%表示切换耗时数周或更久,29%表示切换耗时超过一个月。大多数10月受访者来自研究小组(research panel),我们无法判断9月至10月间任何变化在多大程度上源于受访人群本身的差异。您可查阅 此处更多VB Pulse报告。
JOTO 企业落地观察
- 对企业部署而言,模型切换不是配置变更而是系统重构:PayPal、T-Mobile等公司证实,即便使用网关,仍需重测提示词、工具链与封装器(harness),且必须在真实客户流量下A/B验证,否则易因行为偏移导致服务降级。
- 对智能体工程而言,‘每次优质结果的成本’正取代‘每token成本’成为核心指标:Upwork与Bist的测算表明,低价小模型若成功率低,其单次有效输出成本可能反超高价大模型,迫使工程师重新设计失败重试逻辑与成本归因体系。
- 对AI安全治理而言,模型切换暴露组织级风险:摩根大通要求所有新Claude模型须经银行审批才可上线,而PayPal将业务知识层与模型解耦以规避绑定风险——这说明模型迭代已从技术问题升级为跨部门治理议题,需前置定义知识资产归属与模型替换SOP。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们