你有没有被 AI 客服那半秒的空白噎过?
你说完话,对面静了一下——就是这一下,你立刻知道"它不是人"。语音场景里,这条线很硬:对方说完,AI 得在约 500 毫秒内接上,慢了就"卡"。为了守住这条线,行业里长期只能用那些"快、但不太聪明"的非推理模型。10 月 1 日,一家叫 Inception 的公司说:这个取舍,可以不用做了。0.5 秒:语音 AI 的生死线
先把这个背景钉死。Inception 官方在博客里写得很直白:语音应用要显得自然,agent 必须在用户说完后约 500 毫秒内响应,再久,那个停顿就尴尬了。所以语音 agent 的默认选择,要么是慢一点但会思考的模型,要么是快但只会照着指令走的模型。这是过去几年大家默认的"二选一"。320 毫秒:它交出的第一个数字
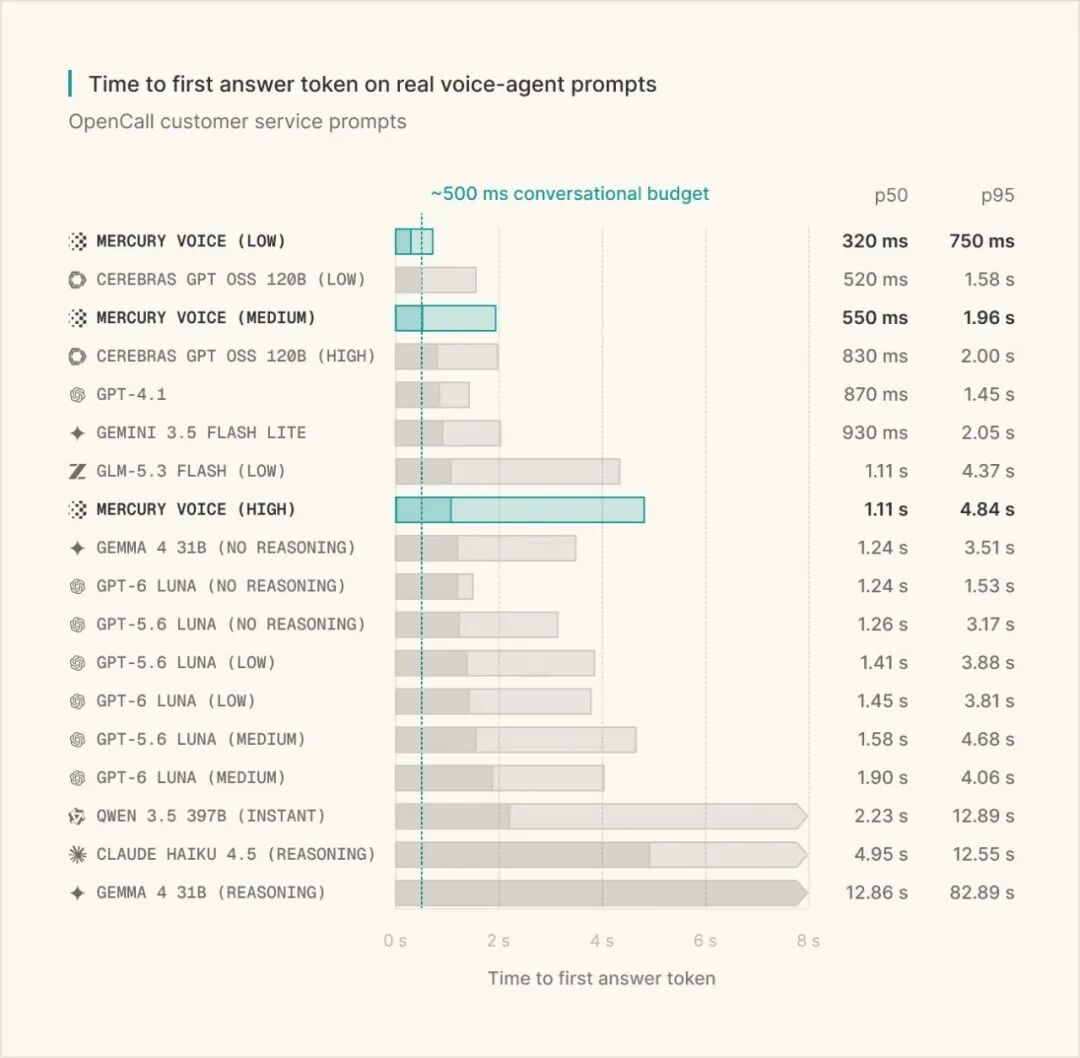
为什么要盯准语音场景?这不是 Inception 一家的热闹。过去一年,语音助手从"按键菜单"变成了"能对话的 agent",凡是做客服、外呼、点餐、预约的公司,都在抢那 500 毫秒。谁能把"聪明"和"快"同时给到,谁就拿到订单。Mercury Voice 挑这个时间点从预览转正式可用,掐的就是这个需求。Mercury Voice 是个扩散语言模型(dLLM),专门为语音 agent 调教:会推理、会调工具、能跟长系统提示,同时把延迟压到能说人话的程度。官方给的第一个数字是:在真实客服提示词上,它的首字回答延迟(TTFAT)中位数低于 320 毫秒,p95 是 750 毫秒。我特意去核了下"首字回答延迟"这个口径——它算的不是模型开始"想"的时间,而是推理做完、开始吐用户真正听得到的第一个字的时间。这个口径,才对应你耳朵里的体感。5.9 倍:官方说它比对手快多少
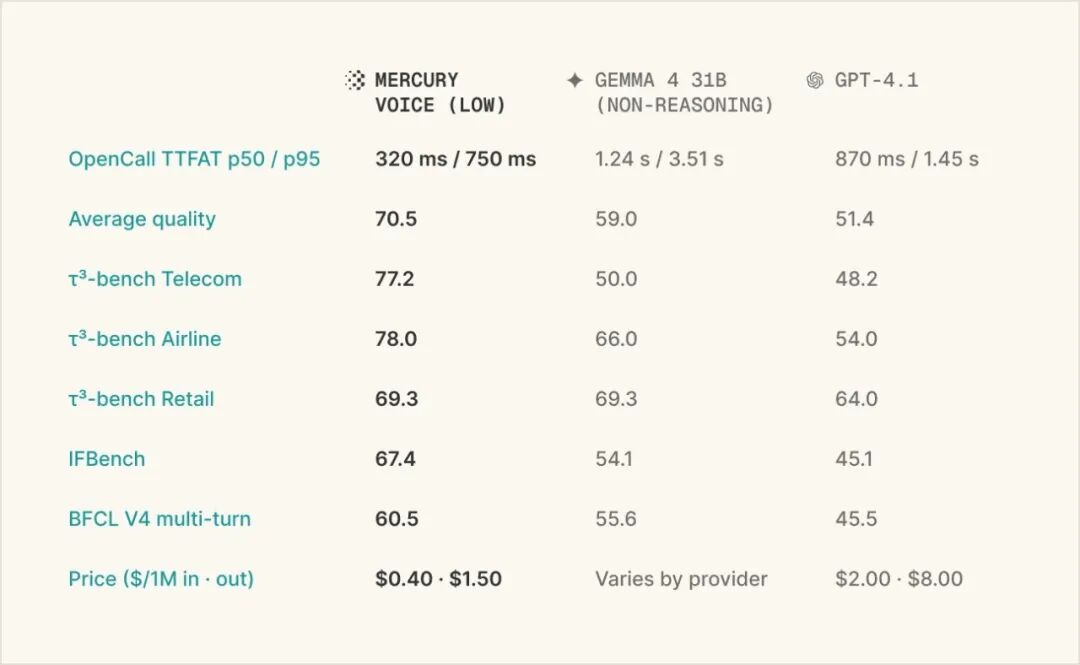
官方口径:Mercury Voice 比 GPT-6 Luna(关闭推理)快约 5.9 倍。质量上,它在一套综合了 τ³-bench(电信/零售/航空)、IFBench、BFCL v4 的基准里,压过了 Gemma 4 31B、GPT-6 Luna、GLM-5.3-Flash、Qwen3.5-397B 等模型。尾巴延迟也被单独提了:官方说,语音里 p95 四秒,意味着大概每二十轮就崩一轮,所以它把 p95 也压到了 750 毫秒。这里有个反常识的点:语音场景里,尾巴延迟和平均延迟几乎一样重要。一次偶尔的长卡,用户记住的就是那一下。所以真正的看点是那句 p95(750 毫秒),而不只是那 320。$0.20:上线五折,诚不诚
价格这块官方也给全了:标准价$0.40 / 百万输入 token、$1.50 / 百万输出;上线期间打五折,变成$0.20 / $0.75。配套规格:推理档位三档(low / medium / high),上下文 128K,最多输出 50K token。落地客户已经有名字了:Audivi AI 用它做免下车点餐的全自动接单;Altur 用它给金融机构做外呼、实时谈付款方案;OpenCall 做 AI 客服电话,官方案例里提到 Mercury 把中位响应延迟压到接近 170 毫秒。它凭什么这么快(讲人话)
一句话:传统大模型是一个字一个字往外蹦(自回归),Inception 用的是"扩散"的路子——一批字同时生成,所以快。代价也 historically 在这儿:扩散模型过去要么慢、要么不够聪明。这次他们想做的是"两头都要"——这才是值得看的地方,而不是又一个跑分。官方还提到,这类模型在搜索、语音、编程 agent 这些"实时"场景里更稳,而这正是语音产品最缺的。怎么接入(企业向)
拿访问:Mercury Voice 面向企业客户开放。企业可联系官方,或从官网www.inceptionlabs.ai入手。
走API:通过 Inception API 调用;Mercury 系列也可在 OpenRouter、Baseten 上使用。
关键设置:语音场景把推理档位调到low,先保住那 500 毫秒预算;要更稳再往上调。
跑通第一个任务:把你们现用的一段客服提示词喂进去,只测一件事——"首字回答延迟",跟现用模型对比。
www.inceptionlabs.ai/blog/introducing-mercury-voice。一个必须说的坑:320 毫秒是模型首字,不等于整通电话的体感。端到端还要加上语音识别、语音合成和网络传输,任何一环慢了都会还回去。而且官方那些对比是它们自己选的基准,换到你的场景未必成立——务必用真实通话验证。另外,现在网上关于"语音模型延迟"的对比图口径五花八门(有的算首字、有的算首音、有的算整句),彼此根本对不上。看的时候,先看它比的是哪个口径。谁该看,谁可以再等等
更该关注的:做客服、外呼、点餐、预约的语音产品团队——尤其是被"便宜模型不够聪明"卡住的那批。以及所有把延迟当 KPI 的实时应用。可以先观望的:只是偶尔做语音转写的产品。你们用普通模型加语音识别/合成就够了,没必要为 320 毫秒多花钱。一句话选型建议:如果你的痛点是"AI 答题太死板",先去解决聪明;如果你的痛点是"用户嫌 AI 反应慢",那 Mercury Voice 值得进候选池。泼盆冷水
- 它拼的是"够快够用",不是"最聪明"。最难的任务,还是得交给旗舰模型。
- 延迟数字漂亮,但打断处理、多轮记忆、方言口音这些"工程活",才是语音产品真正难的地方。
- 价格五折是"上线期",能持续多久,官方没说;企业采购得按原价做预算。
如果接电话的 AI 从"卡半秒"变成"几乎无感",你觉得,自己还能不能听出对面不是人?#MercuryVoice #Inception #语音Agent #AI客服 #扩散模型 #大模型
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询