OpenAI 的新接口,有个很小的官方例子。
你正在跟语音 AI 聊天,顺嘴说了一句,刷新一下网页。它接着听你说话,应用在后台完成刷新,再把结果告诉它。
这个接口叫 Decisions,10 月 6 日开放公测,赶上了 Tibo 的第二轮日更。
四项更新里,我想先拆开这个。
开发者提前准备三个选项,后退、刷新、什么都不做。Decisions 接收对话文字和当前页面状态,从里面选一个。应用接到选择,再执行操作。
这时候,负责说话的 GPT-Live 还能继续听、继续聊。
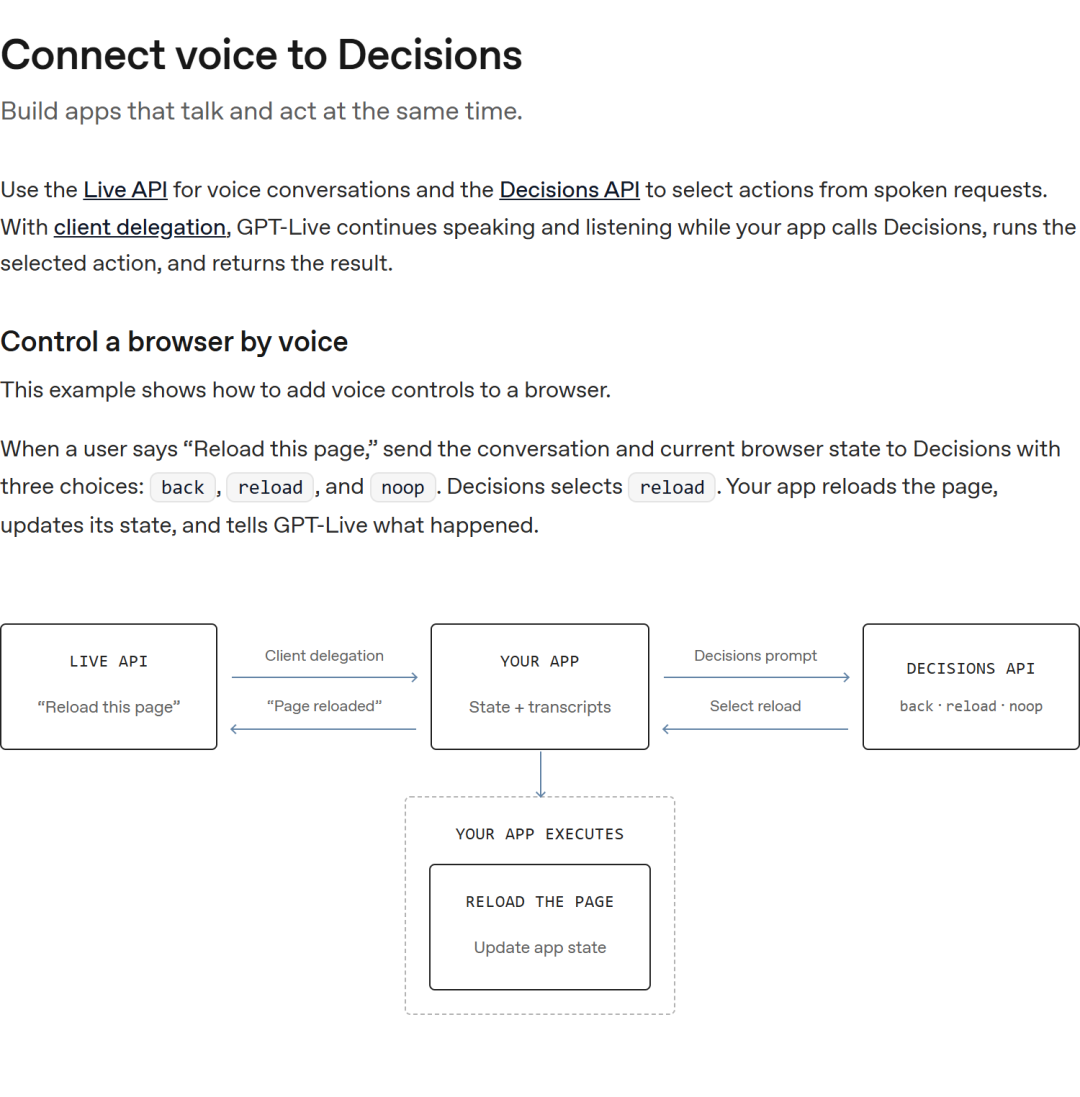
我喜欢那个“什么都不做”。人随口说一句话,AI 不一定非得找个按钮按。没有合适的动作,就别动。
官方还给了一个翻 PPT 的例子。
“下一页”,选翻页。
“帮我比较这两个方案,推荐一个”,选 reason,再由应用交给推理模型分析。
翻一页 PPT,用不着把两个方案也分析一遍。
以前写过的 Jev,也是这种让 AI 快点做选择的路子。现在 OpenAI 把自己的接口放出来了,底下用的是 GPT-6 Luna。
它接受文本和图片。除了选动作,还能判断一个条件成立的概率,或者按你给的标准打分。
比如商品照片里有没有磕碰,一条投诉应该交给哪个部门。应用拿到结果,才决定接下来怎么处理。
但这个接口没法代替整个 Agent。选出了刷新,网页还得由应用去刷。给了一个概率,也得用自己业务里的样本验证,不能把 0.9 当成准确率 90%。
它的价格倒是很干脆。
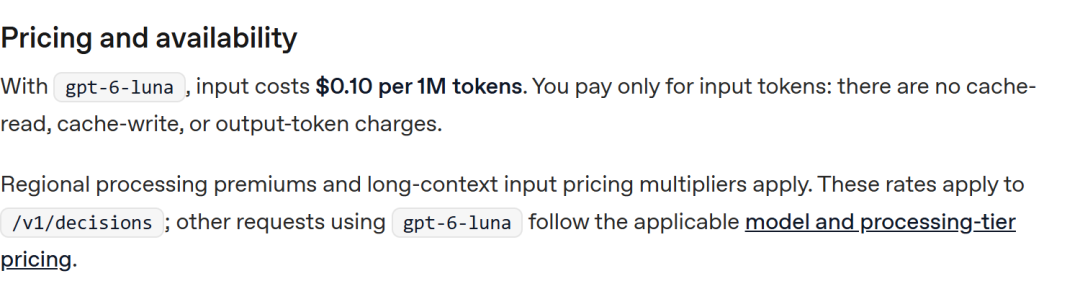
每百万输入 Token,0.10 美元。输出不收费,缓存读写也不收费。
别急着把聊天接口全换了。这里返回的是选项、概率和评分,没有让它免费写长文这回事。地区处理和长上下文也有额外计价规则。
OpenAI 说,这类判断任务最高能快 10 倍。对照的是同一个 GPT-6 Luna 走 Responses API,不能直接理解成整个 Agent 跑快 10 倍。
对做 Agent 的程序员来说,值得拿出来单独折腾的,就是选动作这一步。一个任务可能只在最后写一份报告,中间却要做很多次选择。
另外三项也捎带说下。
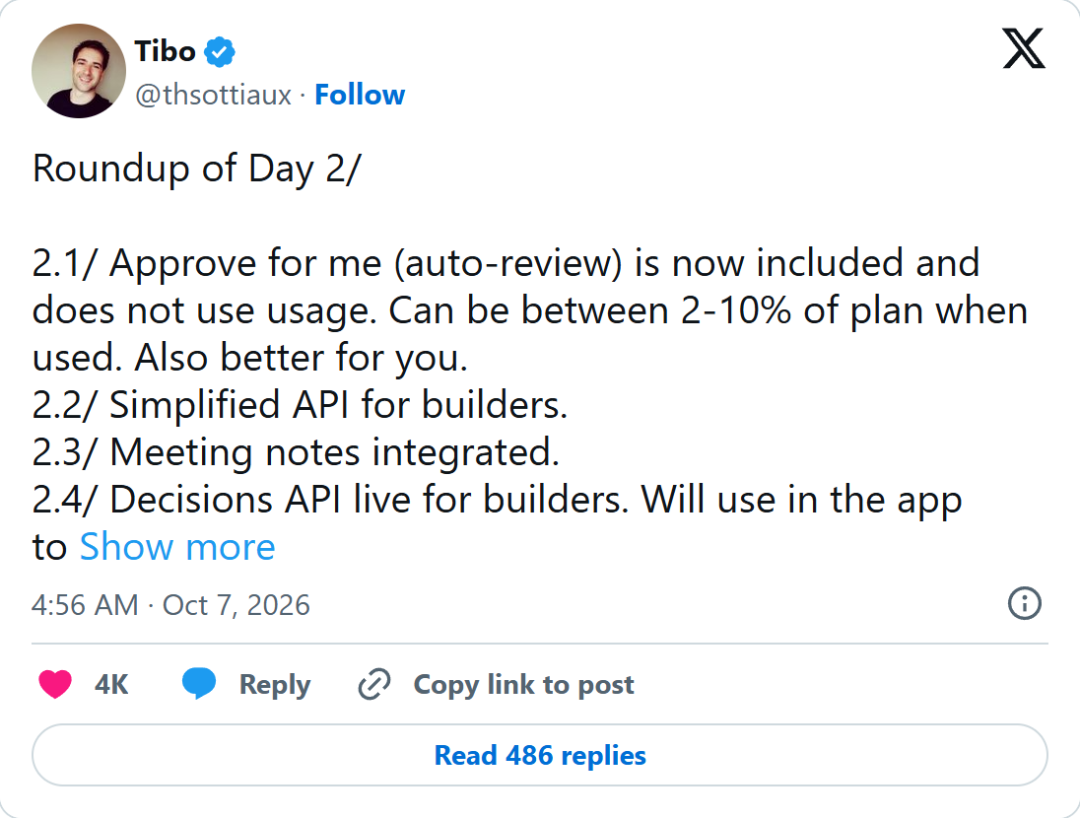
通过 ChatGPT 账号登录时,Auto-review 不再消耗套餐额度。Agent 申请越过沙箱权限边界,会有另一个审核 Agent 判断能不能放行。少一点反复点确认,但它仍可能误判,也没有接管所有操作。
API 的付费使用层级从五档收成三档。Build、Launch、Grow,累计购买额度分别达到 5、100、500 美元,可以满足对应升级条件。这项调整改的是调用容量门槛,不涉及模型单价。
还有 Meetings 插件。开完会,摘要和待办留在 ChatGPT Space,审一下,再让 ChatGPT 起草邮件、更新项目计划。目前是 macOS 的 Pro、Business 用户测试版。开始记录前,要先取得参会者同意。
四项更新看完,我还是惦记那个翻页动作。
让 AI 一边讲方案,一边听人提问,还能顺手翻 PPT。这种配合,光把模型换得更聪明还不够,应用得把后面的动作接好。
鸭鸭给你分享一道题:
假设要开发一个智能工单分类系统,请拆解AI可参与的环节并说明技术选型思路
回答重点
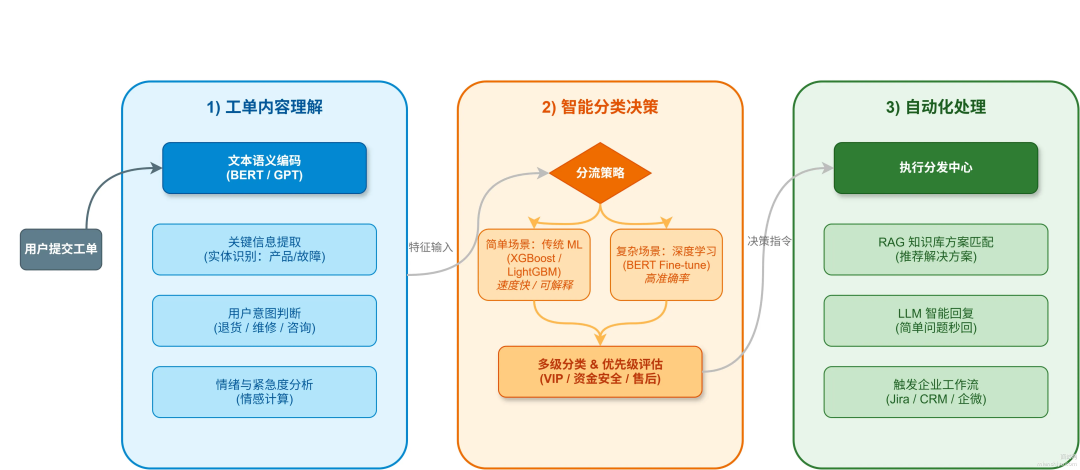
智能工单分类系统里,AI 能介入的环节其实挺多的,从用户提交工单那一刻到最后自动派单,整条链路都能用上。核心就三块:理解工单在说啥、决定往哪分、自动化处理。
1)工单内容理解
用户提交的工单五花八门,有的啰嗦一大堆,有的就几个字,AI 得先把内容"读懂"。传统做法是分词、去停用词那套 NLP 流程,现在直接上 BERT 或者 GPT 类模型做文本编码更省事。关键是要提取出几个核心信息:用户到底遇到了什么问题、涉及哪个产品或模块、情绪是不是很激动。实体识别能把"我的 iPhone 15 屏幕碎了"里的产品名、问题类型抠出来,意图识别能判断用户是想退货还是要维修。
2)智能分类决策
理解完内容就要决定这工单该派给谁。简单场景用 XGBoost、LightGBM 这类传统机器学习模型就够了,训练快、推理快、可解释性还好。复杂场景可以上 BERT 做 fine-tune,分类准确率能高不少。工单分类一般是多级的,先分大类再分小类,比如先判断是售后还是售前,售后里再分退款、换货、维修。还得评估优先级,VIP 客户的工单、涉及资金安全的工单得优先处理。
3)自动化处理
分类完不是结束,还能让 AI 干更多。比如接入 RAG 系统,从企业知识库里捞出历史类似工单的处理方案,直接推荐给客服。简单问题甚至可以让 LLM 生成回复,用户一提交就秒回,不用等人工。分类结果还能触发工作流,自动创建 Jira 工单、发企业微信通知、更新 CRM 状态。
扩展知识
为什么工单分类要上 AI
传统工单系统靠人工分类或者关键词规则匹配,问题很多。人工分类慢还容易出错,高峰期工单堆积严重;关键词规则太死板,用户换个说法就匹配不上,"手机坏了"和"设备故障"规则引擎识别不出来是一回事。AI 模型能理解语义,泛化能力强,一个模型能覆盖各种表述方式。
技术选型思路
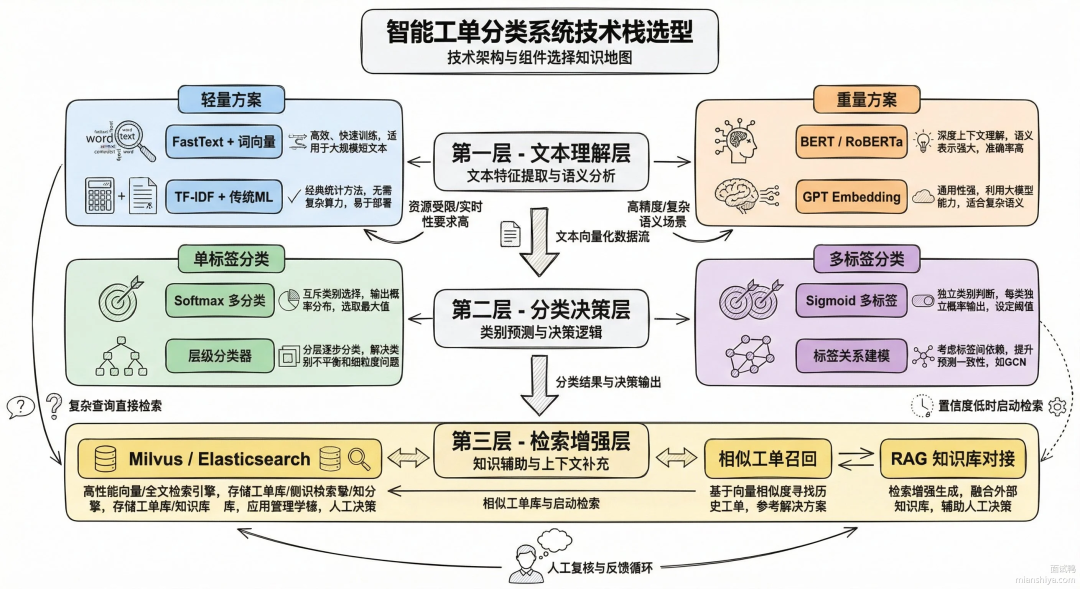
选型要看业务规模和准确率要求:
| 场景 | 推荐方案 | 理由 |
|---|---|---|
| 日工单量 < 1000,类别 < 20 | FastText + XGBoost | 简单够用,部署成本低 |
| 日工单量 1000-10000,类别 20-100 | BERT fine-tune | 准确率高,推理延迟可接受 |
| 日工单量 > 10000,需要实时响应 | 蒸馏小模型 + GPU 推理 | 平衡效果和性能 |
| 类别经常变动,难以穷举 | LLM few-shot + RAG | 灵活性强,不用频繁重训 |
工单分类流程实现
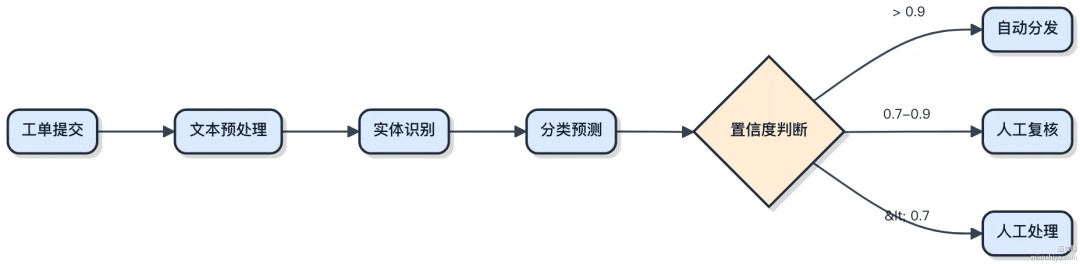
完整的处理流程是这样的:工单进来先做预处理,去掉 HTML 标签、特殊字符、表情这些噪音。然后过一遍 NER 模型提取实体,再用分类模型预测类别。预测结果有个置信度阈值,高于 0.9 的直接自动分发,0.7-0.9 的人工复核,低于 0.7 的全量人工处理。自动分发出去的工单还要定期抽检,发现错分的案例收集起来做增量训练。
相似工单检索
分类之外,检索历史相似工单也很有价值。客服看到新工单,系统自动推送 3-5 条历史类似案例和处理方案,处理效率能提升 30% 以上。技术上就是把工单文本用 Sentence-BERT 转成向量,存到 Milvus 这类向量库里,来新工单时做 ANN 检索。还可以把历史工单的处理方案也向量化,做 RAG 直接生成回复建议。
模型持续优化
工单分类不是一锤子买卖,业务在变、产品在变、用户表述习惯也在变。得搞一套持续迭代的机制:
1)线上埋点收集错分案例,客服手动改了分类的就是负样本2)每周或每月做增量训练,新数据权重可以调高一点3)A/B 测试验证新模型效果,灰度切流上线4)监控分类准确率、平均处理时长这些指标,发现异常及时排查
篇幅有限,完整答案可以点击下方进行查阅:
我们精选了近两年的高频面试真题,已经有 10000 多道面试题目啦,由大厂资深面试官手写答案,押题命中率超高!
不仅有传统八股文,场景题、项目题、系统设计题等等应有尽有,还在不断更新中!
目前优惠最低特价 129 元即永久(限时上架)畅看所有面试题和答案,正式运营价格为 399+,不要错过这次优惠哈!
且,现在邀请好友注册并成为会员,还可获得 10% 的分佣🧧!详情见面试鸭拉新邀请有赏规则(网页版面试鸭点击头像查看)
网页端网址:www.mianshiya.com
往期推荐